Cours
Concentration et loi des grands nombres — Cours en autonomie — Terminale spécialité
Cours
Concentration et loi des grands nombres — Cours en autonomie — Terminale spécialité
Terminale spécialité · Cours en autonomie
Concentration et loi des grands nombres
Faire les 2k\(\pi\)
CONCENTRATION
ET LOI DES GRANDS NOMBRES
Mesurer le risque, comprendre la stabilité
Terminale générale · Spécialité mathématiques
Cours en autonomie · 2026–2027
La question du chapitre. Une observation est incertaine. Pourquoi la moyenne de nombreuses observations peut-elle être plus prévisible ? Combien d’observations faut-il prévoir pour assurer une précision choisie ? Que garantit réellement cette assurance, et que ne garantit-elle pas ?
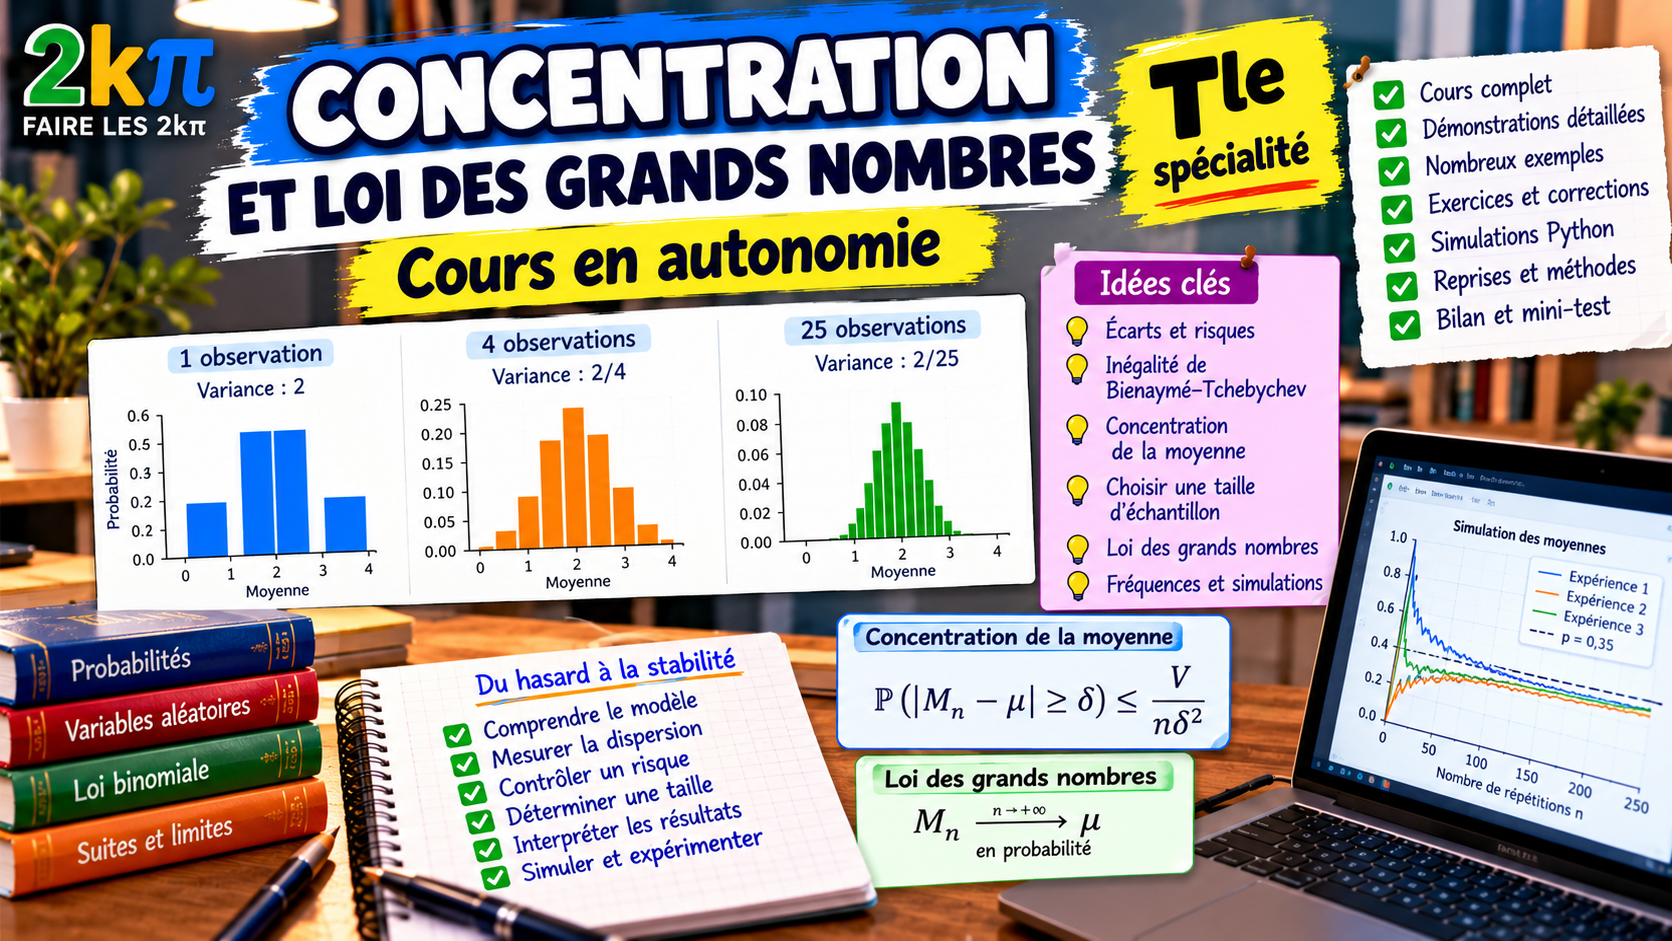
Lecture. On répète une expérience qui donne 0, 2 ou 4 avec probabilités 1/4, 1/2 et 1/4. Les graphiques montrent les lois exactes des moyennes de 1, 4 et 25 observations indépendantes. L’espérance reste 2 ; la variance passe de 2 à 1/2 puis à 2/25. Les échelles verticales diffèrent et sont graduées : la comparaison porte sur la répartition horizontale autour du centre.
Comment essayer. Recopie la consigne d’un « À toi », puis tente une réponse avant de lire les indices et la correction. Compare tes raisons et tes calculs, pas seulement la dernière valeur. Les tâches « à reprendre plus tard » sont des occasions de retester le raisonnement avant relecture ; elles n’ont pas de date automatique.
Les noms ont un rôle. Une définition fixe le sens d’un objet. Une propriété, une proposition et un théorème sont des résultats qui ont la même exigence de justesse ; leurs titres ne mesurent pas une certitude plus ou moins grande. Un lemme aide à prouver un résultat ; un corollaire découle d’un résultat identifié. Les démonstrations sont annoncées comme telles. Une intuition ou une simulation n’est jamais appelée démonstration.
Cadre de lecture. Les variables du parcours principal prennent un nombre fini de valeurs. Les rappels de Première et du chapitre sur les sommes sont redonnés au moment où ils servent. Les exemples réels sont des modèles explicitement posés, pas des données observées sur une population. Les compléments facultatifs sont signalés dans leurs titres.
1. Mesurer un écart et traduire un événement
Objectif. Passer sans ambiguïté d’une phrase à une distance, à un intervalle et à une probabilité.
Un appareil ne donne pas toujours le même résultat. Ce chapitre ne promet pas de deviner chaque mesure : il explique comment contrôler le risque d’un écart important, puis comment ce risque évolue lorsqu’on moyenne plusieurs mesures.
À toi 1.1 — Un repérage avant de commencer
Un résultat vaut \(x=14\) et le centre de comparaison est \(10\). Quelle est la distance de \(x\) à \(10\) ? Le nombre \(6\) est-il à la même distance ? Enfin, que signifie un risque de \(0{,}08\) ? Correction et orientation. \(14-10=4\) et \(6-10=-4\), mais les deux distances valent \(4\) : on prend \(|14-10|=4\) et \(|6-10|=4\). Un risque de \(0{,}08\) est une probabilité de \(8\,\%\), pas un écart de \(8\) unités. Si le signe ou l’unité te bloque, reprends les deux définitions suivantes avant de traduire une phrase.
Définition 1.2 — Variable, loi et réalisation
Une variable aléatoire associe un nombre au résultat d’une expérience aléatoire. Ici, elle ne prend qu’un nombre fini de valeurs. Sa loi indique la probabilité de chacune d’elles ; ces probabilités sont positives ou nulles et leur somme vaut \(1\). On note généralement \(X\) la variable avant l’expérience, et \(x\) une valeur observée. \(\mathbb{P}(X=12)\) est la probabilité de l’événement « la valeur obtenue est \(12\) ». Une fois \(x=12\) observé, ce nombre n’est plus aléatoire pour cette expérience déjà réalisée.
Rappel 1.3 — Centre et dispersion : trois objets différents
Si \(X\) prend les valeurs \(x_1,\ldots,x_r\) avec probabilités \(q_1,\ldots,q_r\), son espérance, sa variance et son écart type sont \[\mu=\operatorname{E}(X)=\sum_{i=1}^{r}x_iq_i,\qquad V=\operatorname{V}(X)=\sum_{i=1}^{r}(x_i-\mu)^2q_i,\qquad \sigma=\sqrt V.\] La notation \(\sum_{i=1}^{r}\) signifie « additionner les termes pour \(i=1,2,\ldots,r\) ». Ainsi \(\sum x_iq_i=x_1q_1+\cdots+x_rq_r\). L’espérance est un centre théorique pondéré, pas forcément une valeur possible de \(X\). La variance est la moyenne pondérée des carrés des écarts à ce centre. Les carrés évitent que des écarts négatifs et positifs se compensent. L’écart type revient à l’unité de \(X\) : si \(X\) est en millimètres, \(\mu\) et \(\sigma\) sont en millimètres, \(V\) en millimètres carrés.
Exemple de référence 1.4 — Une loi finie pour voir les formules fonctionner
Dans un modèle de mesure, \(X\) prend les valeurs suivantes, en millimètres :
| \(x_i\) | \(8\) | \(10\) | \(12\) |
|---|---|---|---|
| \(q_i\) | \(1/4\) | \(1/2\) | \(1/4\) |
La somme des probabilités vaut \(1/4+2/4+1/4=4/4=1\) ; c’est bien une loi. Son espérance vaut \[\mu=8\times\frac14+10\times\frac12+12\times\frac14 =2+5+3=10.\] Pour la variance, on calcule d’abord les écarts \(8-10=-2\), \(10-10=0\), \(12-10=2\), puis leurs carrés : \[V=(-2)^2\times\frac14+0^2\times\frac12+2^2\times\frac14 =4\times\frac14+0+4\times\frac14=1+0+1=2.\] Ainsi \(\sigma=\sqrt2\approx1{,}414\) millimètre. Le centre \(10\) se voit aussi par la symétrie des deux valeurs extrêmes, qui ont la même probabilité ; ce contrôle ne remplace pas le calcul de la variance. Cas révélateur. Une variable prenant \(0\) ou \(1\) avec probabilités \(1/2\) et \(1/2\) a pour espérance \(1/2\), alors qu’elle ne vaut jamais \(1/2\). Une espérance n’est donc pas une prédiction certaine de la prochaine valeur.
Définition 1.5 — Valeur absolue et distance
Pour un réel \(u\), \(|u|\) vaut \(u\) si \(u\geq0\) et \(-u\) si \(u<0\). C’est toujours un nombre positif ou nul. La distance entre deux réels \(x\) et \(\mu\) est \(|x-\mu|\). Par exemple, \(|-4|=-(-4)=4\), tandis que \(|4|=4\). Écrire \(|x-\mu|\) ne signifie pas que \(x\) est supérieur à \(\mu\) : le même écart peut se produire de part et d’autre.
Caractérisation 1.6 — Intérieur et extérieur d’une bande
Pour \(\delta>0\) et \(x,\mu\) réels, \[\begin{array}{rcl} |x-\mu|<\delta&\iff&\mu-\delta<x<\mu+\delta,\\ |x-\mu|\leq\delta&\iff&\mu-\delta\leq x\leq\mu+\delta,\\ |x-\mu|\geq\delta&\iff&x\leq\mu-\delta\ \text{ou}\ x\geq\mu+\delta,\\ |x-\mu|>\delta&\iff&x<\mu-\delta\ \text{ou}\ x>\mu+\delta. \end{array}\]
Démonstration. Si \(x\geq\mu\), la distance est \(x-\mu\) : être à moins de \(\delta\) signifie \(x<\mu+\delta\). Si \(x<\mu\), la distance est \(\mu-x\) : être à moins de \(\delta\) signifie \(x>\mu-\delta\). Ces deux cas réunis donnent l’intervalle ouvert. Réciproquement, à l’intérieur de cet intervalle, chacun des deux cas donne une distance inférieure à \(\delta\) ; les deux sens sont prouvés. En conservant les égalités on obtient la version fermée. Les deux versions extérieures sont les négations des versions intérieures correspondantes.
Lecture. La région intérieure stricte exclut les deux extrémités ; son contraire les inclut. Les deux régions extérieures sont réunies par « ou », tandis que les deux inégalités de l’intérieur doivent être satisfaites ensemble.
Exemple de référence 1.7 — Passer d’une distance à un événement
Une variable \(X\) a pour espérance \(18\). On s’intéresse à un écart strictement inférieur à \(3\) par rapport à ce centre. La valeur absolue \(|X-18|\) mesure une distance, donc ne peut pas être négative. Pour un nombre réel \(x\), être à une distance strictement inférieure à \(3\) de \(18\) signifie être entre \(18-3\) et \(18+3\), sans les extrémités : \[|x-18|<3\iff -3<x-18<3 \iff -3+18<x-18+18<3+18 \iff15<x<21.\] On a ajouté \(18\) aux trois membres : cela ne change pas le sens des inégalités. Ainsi \[\mathbb{P}(|X-18|<3)=\mathbb{P}(15<X<21).\] L’événement contraire contient aussi les deux frontières : \[|X-18|\geq3\iff X\leq15\ \text{ou}\ X\geq21.\] Les deux événements sont disjoints et couvrent tous les résultats possibles ; leurs probabilités s’additionnent en \(1\). Donc \[\mathbb{P}(|X-18|<3)=1-\mathbb{P}(|X-18|\geq3).\] Contrôle. Pour \(x=15\), \(|15-18|=|-3|=3\) : cette valeur appartient à l’extérieur, pas à l’intérieur strict. Si \(X\) ne prend que des valeurs entières, \(15<X<21\) devient \(16\leq X\leq20\) ; on ne remplace pas \(<\) par \(\leq\) sans changer les bornes.
Propriété 1.8 — Passer d’un risque à une garantie
Un événement \(A\) et son contraire \(\overline A\) ont des probabilités dont la somme vaut \(1\) ; donc \(\mathbb{P}(\overline A)=1-\mathbb{P}(A)\). Si \(\mathbb{P}(A)\leq b\), alors \(\mathbb{P}(\overline A)\geq1-b\).
Démonstration. Soustraire les deux membres de l’inégalité à \(1\) inverse leur ordre : de \(\mathbb{P}(A)\leq b\), on tire \(-\mathbb{P}(A)\geq-b\), puis \(1-\mathbb{P}(A)\geq1-b\). Par exemple, un risque au plus égal à \(0{,}08\) donne une probabilité de l’événement contraire au moins égale à \(0{,}92\). Il ne dit pas que le risque vaut exactement \(0{,}08\).
Méthode 1.9 — Commencer par la phrase, conserver les frontières
Je reconnais. L’énoncé parle d’écart, de proximité, de dépassement ou d’un intervalle.
Premier geste. Nommer la variable, le centre \(\mu\) et la tolérance \(\delta>0\), dans la même unité. Écrire ensuite la distance avec le signe exact : « moins de » donne \(<\), « au moins » donne \(\geq\).
Traduire en intervalle si cela aide ; si la variable est entière, ajuster seulement alors les bornes. Pour passer au contraire, échanger \(<\) et \(\geq\), ou \(\leq\) et \(>\). Tester une valeur exactement à une frontière : c’est souvent le contrôle le plus rapide.
À toi 1.10 — À toi, avec un premier appui
On compare \(X\) au centre \(25\). Traduire « l’écart est inférieur ou égal à \(4\) » en valeur absolue puis en intervalle. Écrire l’événement contraire. Compléter ensuite : si ce contraire a une probabilité au plus égale à \(0{,}12\), alors la probabilité de l’intervalle vaut au moins … Indice. Les deux bornes sont \(25-4\) et \(25+4\) ; commence par les calculer.
Correction expliquée 1.11 — Les deux bornes et le bon complément
La distance demandée est \(|X-25|\leq4\). Comme \(25-4=21\) et \(25+4=29\), l’événement est \(21\leq X\leq29\). Son contraire est \(X<21\) ou \(X>29\), c’est-à-dire \(|X-25|>4\). Le risque est au plus \(0{,}12\), donc la probabilité de l’intervalle est au moins \(1-0{,}12=0{,}88\). La valeur \(X=21\) est bien dans l’intervalle : sa distance est \(4\), autorisée par « inférieur ou égal ».
À toi 1.12 — À tenter avant de consulter
Une variable entière \(K\) est comparée au centre \(7\). Écrire \(|K-7|<2\) sous forme d’intervalle entier, puis son contraire. Si \(\mathbb{P}(|K-7|\geq2)\leq0{,}3\), que peut-on conclure pour l’événement intérieur ? Indice. Écris d’abord \(5<K<9\) sans transformer trop tôt les signes.
Correction expliquée 1.13 — Une traduction discrète
On a \(|K-7|<2\iff5<K<9\). Comme \(K\) est entier, les valeurs retenues sont \(6\), \(7\), \(8\), soit \(6\leq K\leq8\). Le contraire est \(K\leq5\) ou \(K\geq9\). Les frontières \(5\) et \(9\) ont une distance égale à \(2\) ; elles sont donc exclues de l’intérieur strict. Par complément, \(\mathbb{P}(6\leq K\leq8)\geq1-0{,}3=0{,}7\). On a obtenu une minoration, pas la valeur exacte.
À toi 1.14 — À expliquer et à faire varier
Pourquoi le contraire de \(|X-\mu|<\delta\) n’est-il pas \(|X-\mu|>\delta\) ? Puis reprendre la question précédente si \(K\) peut prendre des valeurs réelles, et non seulement entières. Réponse possible. Une distance égale à \(\delta\) ne satisfait ni \(<\delta\) ni \(>\delta\) ; ces deux événements ne couvrent donc pas tous les cas. Le contraire correct est \(\geq\delta\). Pour une variable réelle, \(5<K<9\) reste un intervalle ouvert : par exemple \(K=5{,}5\) appartient à cet intervalle mais pas à \([6;8]\). Critères. Mentionner l’égalité à la frontière, expliquer la partition de tous les cas et identifier l’hypothèse « entier » qui autorisait le changement de bornes.
Point de vigilance 1.15 — Réparer une confusion de signe
Première erreur. « Le contraire de \(|X-18|<3\) est \(|X-18|>3\). » La ligne oublie la distance exactement égale à \(3\).
Rappel simple. Pour un nombre \(d\geq0\), soit \(d<1\), soit \(d\geq1\). La valeur \(d=1\) appartient au second groupe.
Nouvel essai. Quel est le contraire de \(|Y-5|\leq1\) ?
Correction. L’intérieur fermé est \(4\leq Y\leq6\). Le contraire est \(Y<4\) ou \(Y>6\), donc \(|Y-5|>1\). Ici l’égalité appartient à l’intérieur, contrairement à la première phrase. Reviens alors à l’événement initial : comme l’intérieur est strict, sa frontière appartient au contraire \(\geq3\).
À toi 1.16 — À reprendre plus tard, avant relecture
Une variable entière \(T\) a une espérance \(12\). Traduire « s’écarter de \(12\) de strictement moins de \(2{,}5\) », puis décrire le risque contraire et la garantie obtenue si ce risque est au plus \(0{,}06\). Indice. Calcule \(12-2{,}5\) et \(12+2{,}5\) avant de choisir les entiers. Correction. \(|T-12|<2{,}5\iff9{,}5<T<14{,}5\iff10\leq T\leq14\). Le contraire est \(T\leq9\) ou \(T\geq15\). Si sa probabilité est au plus \(0{,}06\), celle de \(10\leq T\leq14\) est au moins \(1-0{,}06=0{,}94\). Pour contrôler, \(T=9\) a une distance \(3>2{,}5\), alors que \(T=10\) a une distance \(2<2{,}5\). Je vérifie ma réponse. La variable, les unités, les deux frontières, les entiers et le sens de la borne sont tous explicites.
Synthèse 1.17 — Ce qui doit rester disponible
Une valeur absolue décrit un écart des deux côtés du centre. Le signe de la frontière fait partie de l’événement. Une probabilité est sans unité, tandis que l’écart a l’unité de la variable. Une borne sur le risque se transforme en borne de sens contraire sur la garantie, jamais en égalité automatique.
2. Comprendre et démontrer Bienaymé–Tchebychev
Objectif. Relier une dispersion moyenne à un risque d’écart important, sans connaître toute la loi.
Rappel 2.1 — Les objets nécessaires dans cette unité
Une variable finie \(X\) a des valeurs \(x_i\) et des probabilités \(q_i\geq0\) de somme \(1\). Son espérance est \(\mu=\sum x_iq_i\), sa variance \(V=\sum(x_i-\mu)^2q_i\), son écart type \(\sigma=\sqrt V\). Un événement \(|X-\mu|\geq\delta\) signifie \(X\leq\mu-\delta\) ou \(X\geq\mu+\delta\) ; son contraire est \(\mu-\delta<X<\mu+\delta\). Toutes les valeurs étudiées sont finies.
À toi 2.2 — Lire la dispersion avant la formule
Un terme de variance a la forme \((x_i-\mu)^2q_i\) avec \(q_i\geq0\). Peut-il être négatif ? Si l’on enlève plusieurs de ces termes d’une somme, cette somme peut-elle augmenter ? Correction. Un carré est positif ou nul, donc son produit par \(q_i\geq0\) l’est aussi. Retirer un terme positif ou nul n’augmente pas la somme. Si ce raisonnement te paraît abstrait, compare \(2+0+5=7\) à \(2+0=2\) ; la preuve suivante utilise exactement ce geste avec des contributions pondérées.
Intuition et représentation 2.3 — La variance comme un budget de dispersion
On peut voir chaque quantité \((x_i-\mu)^2q_i\) comme une contribution au « budget » total \(V\). Une valeur très éloignée coûte beaucoup en carré de distance ; si elle était fréquente, elle consommerait une grande partie de ce budget. Un budget \(V\) limité force donc la probabilité totale des grands écarts à rester limitée. Correspondances. Le coût est un carré d’écart ; le poids est une probabilité ; le budget est leur somme.
Limite de l’image. Aucun mécanisme ne redistribue les résultats pour respecter un quota au cours du temps. Les contributions sont théoriques, dans la loi, pas des dépenses successives. C’est la preuve par sommes ci-dessous, et non l’image du budget, qui établit l’inégalité.
Lemme 2.4 — Conserver seulement certains termes positifs
Si \(a_1,\ldots,a_r\) sont positifs ou nuls, alors \(a_1+\cdots+a_s\leq a_1+\cdots+a_r\) pour \(0\leq s\leq r\) ; une somme sans terme vaut \(0\). Si, en outre, \(a_i\geq b_i\) pour \(1\leq i\leq s\), alors \(a_1+\cdots+a_s\geq b_1+\cdots+b_s\).
Démonstration. La différence entre la somme complète et la première est \(a_{s+1}+\cdots+a_r\geq0\). Dans la seconde comparaison, la différence est \((a_1-b_1)+\cdots+(a_s-b_s)\geq0\). Ce lemme permet les deux comparaisons centrales de la preuve suivante.
Théorème 2.5 — Inégalité de Bienaymé–Tchebychev
Soit \(X\) une variable aléatoire à valeurs finies, d’espérance \(\mu\) et de variance \(V\). Pour tout réel \(\delta>0\), \[\boxed{\mathbb{P}(|X-\mu|\geq\delta)\leq\frac{V}{\delta^2}.}\] Aucune indépendance entre plusieurs variables n’est nécessaire ici : le résultat porte sur une seule variable.
Démonstration. Notons \(x_1,\ldots,x_r\) les valeurs de \(X\), et \(q_i=\mathbb{P}(X=x_i)\). Chaque \(q_i\) est positif ou nul. Par définition, \[V=(x_1-\mu)^2q_1+\cdots+(x_r-\mu)^2q_r.\] Pour ne pas introduire une notation de somme compliquée, rangeons d’abord les valeurs dont la distance à \(\mu\) est au moins \(\delta\) : ce sont \(x_1,\ldots,x_s\). Si aucune valeur ne convient, la probabilité cherchée vaut \(0\) et l’inégalité est immédiate.
Sinon, tous les termes de la variance sont positifs ou nuls. En ne conservant que les \(s\) premiers, on ne peut qu’abaisser la somme. Pour chacun de ces termes, \(|x_i-\mu|\geq\delta\) entraîne \((x_i-\mu)^2\geq\delta^2\) ; on compare des nombres positifs et on multiplie par \(q_i\geq0\). Ainsi : \[\begin{aligned} V&\geq (x_1-\mu)^2q_1+\cdots+(x_s-\mu)^2q_s\\ &\geq\delta^2q_1+\cdots+\delta^2q_s\\ &=\delta^2(q_1+\cdots+q_s). \end{aligned}\] Les événements \(X=x_1,\ldots,X=x_s\) sont disjoints : \(q_1+\cdots+q_s\) est exactement \(\mathbb{P}(|X-\mu|\geq\delta)\). Comme \(\delta^2>0\), la division par \(\delta^2\) conserve le sens : \[\frac{V}{\delta^2}\geq \frac{\delta^2\mathbb{P}(|X-\mu|\geq\delta)}{\delta^2} =\mathbb{P}(|X-\mu|\geq\delta).\] Cela établit le résultat pour toute variable finie, et non seulement pour l’exemple dessiné.
Lecture. Dans l’exemple à trois valeurs, les deux valeurs extrêmes portent toutes les contributions à la variance. Les probabilités sont les poids des valeurs, pas leurs distances ; on compare des sommes de contributions positives.
Corollaire 2.6 — Une minoration de la probabilité intérieure
Dans les conditions du théorème et pour \(\delta>0\), \[\mathbb{P}(|X-\mu|<\delta)\geq1-\frac{V}{\delta^2}.\]
Démonstration. Les événements \(|X-\mu|<\delta\) et \(|X-\mu|\geq\delta\) sont contraires. Leur somme de probabilités vaut \(1\). La majoration du second entraîne donc la minoration du premier : \(1-\mathbb{P}(|X-\mu|\geq\delta)\geq1-V/\delta^2\). Version fermée. Comme l’intérieur strict est inclus dans \(|X-\mu|\leq\delta\), la même minoration reste vraie pour cet intérieur fermé. Ce sont deux événements distincts, reliés par une inclusion.
Propriété 2.7 — Quand la variance est nulle
Si \(V=0\), alors \(\mathbb{P}(X=\mu)=1\). Réciproquement, si \(\mathbb{P}(X=\mu)=1\), alors \(V=0\).
Démonstration. Lorsque la somme \(\sum(x_i-\mu)^2q_i\) de termes positifs ou nuls vaut \(0\), chaque terme vaut \(0\). Pour une valeur de probabilité \(q_i>0\), cela impose \((x_i-\mu)^2=0\), donc \(x_i=\mu\). Toutes les valeurs de probabilité positive sont donc égales à \(\mu\). Réciproquement, si seule cette valeur a une probabilité positive, tous les carrés des écarts qui contribuent à la variance sont nuls. Ainsi, pour toute distance \(\delta>0\), \(\mathbb{P}(|X-\mu|\geq\delta)=0\). Mais \(\mathbb{P}(|X-\mu|\geq0)=1\) : le théorème ne s’applique pas à un seuil nul.
Corollaire 2.8 — Exprimer le seuil en écarts types
Supposons \(\sigma>0\). Pour tout \(k>0\), \[\mathbb{P}(|X-\mu|\geq k\sigma)\leq\frac1{k^2}.\]
Démonstration. On prend \(\delta=k\sigma>0\) dans Bienaymé–Tchebychev et on utilise \(V=\sigma^2\) : \[\frac V{\delta^2}=\frac{\sigma^2}{(k\sigma)^2} =\frac{\sigma^2}{k^2\sigma^2}=\frac1{k^2}.\] La simplification par \(\sigma^2\) est autorisée parce que \(\sigma>0\). Pour \(k=2\), le risque est au plus \(1/4\) ; pour \(k=3\), au plus \(1/9\) ; pour \(k=4\), au plus \(1/16\). Les garanties intérieures strictes sont respectivement \(3/4\), \(8/9\) et \(15/16\). Vigilance. Le cas \(\sigma=0\) a été traité séparément. Le seuil \(k\sigma\) serait nul : l’événement large serait certain, et la conclusion ci-dessus serait fausse pour \(k>1\).
Exemple de référence 2.9 — Une information limitée, mais une conclusion certaine sur le risque
Dans un modèle de dosage, \(X\) est une quantité en milligrammes, d’espérance \(40\) et d’écart type \(3\). On veut encadrer le risque de s’écarter d’au moins \(6\) milligrammes du centre. Le seuil \(6\) est positif et la variance vaut \(V=3^2=9\) milligrammes carrés. \[\mathbb{P}(|X-40|\geq6)\leq\frac9{6^2} =\frac9{36}=\frac14=0{,}25.\] Donc \(\mathbb{P}(34<X<46)\geq1-0{,}25=0{,}75\). On peut retrouver le même résultat avec \(6=2\sigma\), donc \(1/k^2=1/2^2=1/4\). Ce que l’on ne sait pas. La loi complète n’est pas donnée : le risque réel pourrait valoir \(0{,}01\), \(0{,}1\), ou une autre valeur compatible avec ces données. L’inégalité ne choisit pas l’une de ces valeurs. En particulier, « deux écarts types » ne garantit pas universellement \(95\,\%\) de probabilité intérieure.
Méthode 2.10 — Utiliser le théorème sans changer son sens
Indices. On connaît l’espérance et la variance, ou l’écart type, et on demande un risque autour de l’espérance.
Premier geste. Écrire \(\mu\), \(V\) et la distance \(\delta>0\) avant de substituer. Si l’on te donne \(\sigma\), calcule d’abord \(V=\sigma^2\). Écris l’événement, puis \(\mathbb{P}(\text{écart})\leq V/\delta^2\). Pour une garantie intérieure, utilise le complément et conserve les frontières.
Contrôles. Les unités se simplifient dans \(V/\delta^2\). Une probabilité est comprise entre \(0\) et \(1\). Une majoration par un nombre supérieur à \(1\) reste vraie, mais n’apprend rien de plus que cette dernière règle.
À toi 2.11 — À toi, avec les trois données à repérer
On sait \(\operatorname{E}(X)=15\) et \(\operatorname{V}(X)=4\). Majorer \(\mathbb{P}(|X-15|\geq5)\), puis minorer \(\mathbb{P}(10<X<20)\). Indiquer \(\mu\), \(V\), \(\delta\) avant le calcul. Indice. Le nombre \(4\) est déjà une variance : ne le mets pas une seconde fois au carré.
Correction expliquée 2.12 — Variance donnée et distance demandée
Les données sont \(\mu=15\), \(V=4\), \(\delta=5>0\). Donc \(\mathbb{P}(|X-15|\geq5)\leq4/5^2=4/25=0{,}16\). Le contraire est \(10<X<20\) ; sa probabilité est au moins \(1-0{,}16=0{,}84\). Contrôle : le seuil est \(5/2=2{,}5\) écarts types, car \(\sigma=\sqrt4=2\) ; \(1/(2{,}5)^2=1/6{,}25=0{,}16\) redonne la borne.
À toi 2.13 — À tenter avant de consulter
Une variable \(Y\) a pour espérance \(-2\) et pour écart type \(0{,}5\). Que peut-on garantir pour la probabilité de \(-3<Y<-1\) ? Indice. Le centre peut être négatif. C’est la distance au centre, et non le centre lui-même, qui doit être positive.
Correction expliquée 2.14 — Un centre négatif ne gêne pas le théorème
L’intervalle est centré en \(-2\) avec demi-largeur \(1\) : \(-3<Y<-1\iff|Y-(-2)|<1\). La variance est \((0{,}5)^2=0{,}25\). La queue contraire a une probabilité au plus \(0{,}25/1^2=0{,}25\). Ainsi \(\mathbb{P}(-3<Y<-1)\geq0{,}75\). Le seuil \(1\) est strictement positif et les bornes \(-3\) et \(-1\) restent exclues ; le signe négatif de l’espérance n’affecte pas les carrés des distances.
À toi 2.15 — Pourquoi la preuve fonctionne-t-elle ?
Dans la preuve, pourquoi a-t-on le droit de supprimer les valeurs proches du centre ? Pourquoi ne remplace-t-on pas ensuite \(\leq\) par \(=\) ? Réponse possible. Toutes les contributions à la variance sont positives ou nulles, donc les supprimer abaisse la somme ou la laisse inchangée. Les valeurs lointaines peuvent être plus loin que \(\delta\) ; remplacer leur carré d’écart par \(\delta^2\) peut aussi abaisser la somme. Les deux étapes sont des inégalités, généralement pas des égalités. Critères. Faire apparaître la positivité des poids et des carrés, le sens de chaque comparaison et la différence entre distance au moins \(\delta\) et distance exactement \(\delta\).
Point de vigilance 2.16 — Réparer la confusion entre écart type et variance
Erreur. Avec \(\sigma=3\) et \(\delta=6\), écrire une borne \(3/6^2\) utilise le mauvais numérateur.
Rappel et exemple plus simple. La variance est le carré de l’écart type. Si \(\sigma=2\), alors \(V=2\times2=4\), et au seuil \(4\) la borne vaut \(4/4^2=4/16=1/4\).
Nouvel essai. Avec \(\sigma=5\) et \(\delta=10\), quelle borne obtient-on ?
Correction. \(V=5^2=25\), \(\delta^2=10^2=100\), donc \(25/100=1/4\). Revenir au cas initial donne \(3^2/6^2=9/36=1/4\). Dans les trois cas le seuil vaut deux écarts types ; cette constance est un contrôle, pas une raison pour oublier le carré.
À toi 2.17 — Quand une hypothèse change
Une variable est certaine : \(X=7\) avec probabilité \(1\). Peut-on annoncer \(\mathbb{P}(|X-7|\geq3\sigma)\leq1/9\) ? Correction. \(V=0\) et \(\sigma=0\). Le seuil \(3\sigma\) vaut \(0\), donc \(|X-7|\geq0\) est certain : la probabilité vaut \(1\). Le corollaire standardisé exigeait \(\sigma>0\). En revanche, pour tout vrai seuil \(\delta>0\), \(\mathbb{P}(|X-7|\geq\delta)=0\), en accord avec le théorème initial. La bonne réparation consiste à changer de cas, pas à diviser par zéro.
À toi 2.18 — À reprendre plus tard, avant relecture
Avec \(\operatorname{E}(Z)=30\) et \(\operatorname{V}(Z)=9\), minorer \(\mathbb{P}(24<Z<36)\), puis expliquer en une phrase pourquoi une valeur exacte n’est pas déterminée. Indice. Le seuil est \(6\), pas la largeur totale \(12\). Correction. \(24<Z<36\iff|Z-30|<6\). La queue large est majorée par \(9/6^2=9/36=1/4\). L’intérieur strict a donc une probabilité au moins égale à \(1-1/4=3/4\). L’espérance et la variance ne précisent pas toutes les probabilités de la loi ; la majoration peut être plus grande que le risque réel.
Synthèse 2.19 — Le résultat et son statut
Bienaymé–Tchebychev est démontré ici pour une loi finie. Il transforme une variance connue en garantie sur un événement d’écart, avec \(\delta>0\). Le résultat est universel dans ce cadre ; cette généralité explique qu’il puisse être peu précis pour une loi particulière.
3. Encadrer une probabilité sans connaître toute la loi
Objectif. Choisir entre calcul exact, majoration, complément et inclusion d’événements.
Rappel 3.1 — Ce dont on dispose
Une variable finie \(X\) a pour espérance \(\mu\) et variance \(V\geq0\). Pour \(\delta>0\), Bienaymé–Tchebychev donne \[\mathbb{P}(|X-\mu|\geq\delta)\leq V/\delta^2, \qquad \mathbb{P}(|X-\mu|<\delta)\geq1-V/\delta^2.\] L’intérieur strict est \(\mu-\delta<X<\mu+\delta\). Si la loi complète est disponible, on peut aussi additionner les probabilités des valeurs autorisées. Les valeurs d’une variable finie sont des nombres ; leurs probabilités sont les poids utilisés dans cette addition.
À toi 3.2 — Une borne n’est pas une réponse exacte
On sait seulement qu’un événement a une probabilité au plus égale à \(0{,}4\). Cette probabilité peut-elle valoir \(0{,}1\) ? Peut-elle valoir \(0{,}7\) ? Peut-on conclure qu’elle vaut \(0{,}4\) ? Correction. \(0{,}1\leq0{,}4\) est compatible avec l’information ; \(0{,}7>0{,}4\) ne l’est pas. La probabilité peut être n’importe quelle valeur autorisée entre \(0\) et \(0{,}4\), selon la loi : une égalité à \(0{,}4\) n’est pas établie. Si cette lecture te bloque, représente \(0\leq q\leq0{,}4\) comme un intervalle de possibilités pour \(q\).
Exemple de référence 3.3 — Comparer une valeur exacte à sa majoration
Une prime aléatoire \(X\), en euros, prend les valeurs \(0\), \(4\), \(10\) avec probabilités \(0{,}2\), \(0{,}5\), \(0{,}3\). Leur somme est \(1\). \[\mu=0\times0{,}2+4\times0{,}5+10\times0{,}3=0+2+3=5.\] Les écarts au centre sont \(-5\), \(-1\), \(5\) ; leur variance est \[V=(-5)^2\times0{,}2+(-1)^2\times0{,}5+5^2\times0{,}3 =5+0{,}5+7{,}5=13.\] Calcul exact de la queue. \(|X-5|\geq5\) se produit pour \(X=0\) ou \(X=10\), événements incompatibles. La probabilité vaut \(0{,}2+0{,}3=0{,}5\). Majorant. Avec \(\delta=5\), Bienaymé–Tchebychev donne \(\mathbb{P}(|X-5|\geq5)\leq13/25=0{,}52\). On vérifie réellement \(0{,}5\leq0{,}52\). Intérieur. \(|X-5|<5\) se produit seulement pour \(X=4\), donc sa probabilité exacte vaut \(0{,}5\). La garantie fournie par le théorème est \(1-0{,}52=0{,}48\), bien inférieure ou égale à \(0{,}5\). Le théorème reste utile si l’on retire la table de loi mais que l’on connaît encore \(\mu=5\) et \(V=13\) : le calcul exact disparaît, la garantie subsiste.
Méthode 3.4 — Choisir la voie adaptée aux informations disponibles
Si la loi est connue et le calcul raisonnable : le premier geste est de lister les valeurs qui satisfont exactement l’événement ; on additionne leurs probabilités. Un tableau, une somme binomiale ou un cumul de calculatrice peut effectuer ce calcul.
Si seuls l’espérance et la variance sont connus : on cherche un événement d’écart autour de \(\mu\) auquel appliquer Bienaymé–Tchebychev. Si l’événement demandé n’est pas centré, on cherche une inclusion, jamais une fausse égalité.
Si une simulation est proposée : elle produit une fréquence observée, qui varie d’une exécution à l’autre. Ce n’est ni une valeur exacte ni, à elle seule, une preuve de majoration.
Contrôle final. Préciser dans la phrase de conclusion « vaut », « est environ égal à », « est au plus » ou « est au moins », selon ce qui a effectivement été calculé.
Propriété 3.5 — Utiliser une inclusion d’événements
Si tout résultat de l’événement \(A\) appartient aussi à \(B\), on note \(A\subset B\) et on a \(\mathbb{P}(A)\leq\mathbb{P}(B)\).
Démonstration. L’événement \(B\) se décompose en \(A\) et en la partie de \(B\) qui n’est pas dans \(A\). Ces parties sont disjointes et la seconde a une probabilité positive ou nulle. Donc \(\mathbb{P}(B)=\mathbb{P}(A)+\mathbb{P}(B\text{ sans }A)\geq\mathbb{P}(A)\). Deux usages. Pour majorer un risque, on peut le contenir dans un risque plus grand. Pour minorer une réussite, on peut trouver une réussite plus petite incluse dans celle demandée.
Exemple de référence 3.6 — Un intervalle qui n’est pas centré
Une variable \(X\) a pour espérance \(50\) et variance \(9\). On veut une garantie pour \(44\leq X\leq55\). Cet intervalle n’est pas centré en \(50\) : les distances aux deux bords sont \(6\) et \(5\). Le premier geste est de choisir une bande centrée qui tient entièrement dans l’intervalle demandé. L’intervalle \(45<X<55\) convient, avec demi-largeur \(5\) : \[\{|X-50|<5\}\subset\{44\leq X\leq55\}.\] Par le théorème, \(\mathbb{P}(|X-50|<5)\geq1-9/25=16/25=0{,}64\). Par inclusion, \[\mathbb{P}(44\leq X\leq55)\geq0{,}64.\] Contrôle. Une valeur comme \(44{,}5\) appartient à l’intervalle demandé mais pas à la bande choisie : il s’agit bien d’une inclusion, non d’une égalité. Choisir la demi-largeur \(6\) donnerait \(44<X<56\), qui n’est pas inclus dans \([44;55]\) ; on n’aurait plus la garantie cherchée par ce raisonnement.
Lecture. La bande centrée de rayon 5 autour de 50 reste dans l’intervalle de 44 à 55. Sa probabilité fournit donc une minoration de celle du grand intervalle, même si les deux événements ne sont pas égaux.
Exemple de référence 3.7 — Un événement d’un seul côté
Avec les mêmes données \(\mu=50\) et \(V=9\), l’événement \(X\geq58\) entraîne \(|X-50|\geq8\). La réciproque est fausse : \(X\leq42\) satisfait aussi l’événement d’écart. Ainsi, \[\mathbb{P}(X\geq58)\leq\mathbb{P}(|X-50|\geq8) \leq\frac9{8^2}=\frac9{64}=0{,}140625.\] Cette majoration unilatérale est correcte par inclusion. Elle n’est pas forcément la meilleure possible, et aucune propriété de symétrie n’a été supposée : on ne divise donc pas automatiquement la borne par \(2\).
Bon réflexe 3.8 — Garder les bornes naturelles de toute probabilité
Une probabilité est déjà comprise entre \(0\) et \(1\). Si \(V/\delta^2\) dépasse \(1\), on garde la borne \(1\), plus utile. Par exemple, pour \(V=25\) et \(\delta=2\), le quotient vaut \(25/4=6{,}25\) : \(\mathbb{P}(|X-\mu|\geq2)\leq6{,}25\) est vrai, mais moins informatif que \(\mathbb{P}(\cdot)\leq1\). La minoration intérieure \(1-6{,}25=-5{,}25\) est pareillement remplacée par \(0\). Bénéfice et limite. Ce contrôle évite de présenter un « risque de \(625\,\%\) ». Il ne rend pas la probabilité calculable : on sait seulement que la borne de Tchebychev est trop grossière à ce seuil.
À toi 3.9 — À toi, avec une inclusion à construire
Une variable \(Z\) a pour espérance \(20\) et variance \(4\). Donner une minoration de \(\mathbb{P}(15\leq Z\leq24)\) en choisissant une bande centrée en \(20\). Peut-on remplacer cette minoration par une égalité ? Indice. Les distances aux bords sont \(5\) et \(4\). La bande doit tenir du côté le plus proche du centre.
Correction expliquée 3.10 — Le bord le plus proche commande la bande
La bande \(|Z-20|<4\) est \(16<Z<24\) et elle est incluse dans \([15;24]\). La probabilité de cette bande est au moins \(1-4/4^2=1-4/16=1-1/4=3/4\). Donc \(\mathbb{P}(15\leq Z\leq24)\geq3/4\). Une égalité n’est pas établie : l’intervalle demandé peut contenir d’autres valeurs, et la borne elle-même peut être large.
À toi 3.11 — À tenter avant de consulter
Une variable \(Y\) a pour espérance \(5\) et écart type \(2\). Que peut-on dire de \(\mathbb{P}(Y\geq11)\) ? Donner une justification qui n’utilise pas une symétrie absente de l’énoncé. Indice. La distance de \(11\) au centre est \(11-5=6\).
Correction expliquée 3.12 — Une majoration, pas une loi inventée
La variance vaut \(2^2=4\). Si \(Y\geq11\), alors \(Y-5\geq6\), donc \(|Y-5|\geq6\). Par inclusion et par Bienaymé–Tchebychev, \[\mathbb{P}(Y\geq11)\leq\mathbb{P}(|Y-5|\geq6)\leq\frac4{6^2} =\frac4{36}=\frac19.\] Le seuil \(6\) est positif. La queue gauche \(Y\leq-1\) participe à l’événement bilatéral ; rien ne dit qu’elle a la même probabilité que la queue droite. Diviser par deux n’est donc pas justifié.
À toi 3.13 — Étudier une affirmation inverse
Un élève affirme : « Puisque \(\mathbb{P}(|X-\operatorname{E}(X)|\geq5)\leq0{,}3\), la variance de \(X\) vaut \(0{,}3\times5^2=7{,}5\). » Cette conclusion est-elle imposée ? Réponse possible. Non. Si \(X\) est constamment égal à \(2\), son espérance est \(2\), son risque d’écart d’au moins \(5\) vaut \(0\leq0{,}3\), et sa variance vaut \(0\), pas \(7{,}5\). On a retourné à tort une implication et traité une borne comme une égalité. Critères. Fournir une variable autorisée, vérifier l’hypothèse donnée et montrer que la conclusion échoue. Ce seul contre-exemple suffit à réfuter l’affirmation générale.
Point de vigilance 3.14 — Réparer une borne utilisée comme valeur exacte
Erreur initiale. « Le quotient vaut \(0{,}52\), donc la probabilité vaut \(0{,}52\). » La première égalité fautive remplace le signe \(\leq\) par \(=\).
Rappel et exemple simple. Un nombre \(q\) satisfaisant \(q\leq1/2\) peut valoir \(1/4\) : \(1/4\leq1/2\), mais \(1/4\neq1/2\).
Nouvel essai. Si \(\mathbb{P}(A)\leq0{,}2\), écrire l’information correcte sur \(\mathbb{P}(\overline A)\) et proposer une valeur compatible de chacune.
Correction. \(\mathbb{P}(\overline A)=1-\mathbb{P}(A)\geq1-0{,}2=0{,}8\). Par exemple \(\mathbb{P}(A)=0{,}1\) et \(\mathbb{P}(\overline A)=0{,}9\) sont compatibles et totalisent \(1\). Reviens à la prime de référence : le calcul exact donne \(0{,}5\), la borne \(0{,}52\) ; ils ne se contredisent pas.
À toi 3.15 — À reprendre plus tard, sans relire les méthodes
Une variable \(T\) a pour espérance \(12\) et variance \(9\). Donner une minoration de \(\mathbb{P}(6\leq T\leq19)\) et une majoration de \(\mathbb{P}(T\geq18)\). Préciser à chaque fois l’inclusion utilisée. Indice. Les deux demandes n’ont pas le même type de conclusion ; une même bande de rayon \(6\) peut servir. Correction. La bande \(|T-12|<6\) est \(6<T<18\), incluse dans \([6;19]\). Elle a une probabilité au moins égale à \(1-9/6^2=1-1/4=3/4\). Donc \(\mathbb{P}(6\leq T\leq19)\geq3/4\). D’autre part, \(T\geq18\) entraîne \(|T-12|\geq6\), donc \(\mathbb{P}(T\geq18)\leq9/36=1/4\). Aucun partage égal entre les deux côtés n’a été supposé. Je vérifie. J’ai nommé les événements, conservé le sens des inclusions et conclu par une borne, non par une probabilité exacte inventée.
Synthèse 3.16 — Trois résultats de nature différente
Une loi permet parfois un calcul exact ; une inégalité fournit une garantie ; une simulation fournit une observation. Ces trois outils se comparent, mais aucun signe \(=\), \(\approx\), \(\leq\) ou \(\geq\) ne doit être changé pour les faire coïncider.
4. De l’observation à la moyenne : la concentration
Objectif. Construire une moyenne aléatoire, calculer sa dispersion et expliquer pourquoi des répétitions indépendantes permettent de mieux la contrôler.
Avant de commencer : trois vérifications rapides
À toi 4.1 — Ne pas confondre la grandeur et sa dispersion
Sans consulter la correction, réponds aux trois questions.
Trois valeurs observées sont \(4\), \(8\) et \(6\). Quels sont leur total et leur moyenne ?
On moyenne neuf variables indépendantes de même loi, chacune de variance \(9\). La variance de la moyenne est-elle \(9\), \(1\) ou \(1/9\) ?
Une formule donne \(\operatorname{E}(M_n)=12\). Cela signifie-t-il que chaque moyenne observée est égale à \(12\) ?
Correction expliquée 4.2 — Le point de départ à choisir
1. Le total vaut \(4+8+6=18\) ; la moyenne vaut \(18/3=6\). Le total additionne, la moyenne additionne puis divise par le nombre de valeurs.
2. La somme des neuf variables a pour variance \(9\times9=81\). Diviser cette somme par \(9\) multiplie sa variance par \((1/9)^2=1/81\) : la variance cherchée vaut donc \(81/81=1\).
3. Non. L’espérance est un centre théorique de la loi de la moyenne, pas une valeur imposée à chaque réalisation.
Pour t’orienter. Si la première réponse pose problème, commence par les définitions ci-dessous. Si tu as choisi \(1/9\) à la deuxième question, soigne le passage somme puis moyenne et la réparation proposée en fin d’unité. Si tu as répondu oui à la troisième, garde la distinction entre majuscules aléatoires et valeurs observées.
Définir ce que l’on répète et ce que l’on moyenne
Rappel 4.3 — Espérance, variance et écart type
Une variable aléatoire finie \(X\) prend des valeurs \(x_1,\ldots,x_r\) avec des probabilités \(q_1,\ldots,q_r\), toutes positives ou nulles et de somme \(1\). On note \[\mu=\operatorname{E}(X)=\sum_{i=1}^{r}x_iq_i,\qquad V=\operatorname{V}(X)=\sum_{i=1}^{r}(x_i-\mu)^2q_i,\qquad \sigma=\sqrt V.\] Le symbole \(\sum\) signifie que l’on additionne les termes obtenus pour \(i=1,\ldots,r\). La variance est une moyenne pondérée de carrés d’écarts ; elle est donc positive ou nulle. L’écart type est sa racine carrée positive.
Si \(X\) est une longueur en millimètres, \(\mu\) et \(\sigma\) s’expriment en millimètres, mais \(V\) s’exprime en millimètres carrés. Une tolérance sur une longueur doit être comparée à un écart type, pas directement à une variance.
Définition 4.4 — Échantillon aléatoire de taille \(n\)
On effectue \(n\) répétitions indépendantes d’une même expérience, dans les mêmes conditions probabilistes, avec \(n\) entier et \(n\geq1\). Les résultats numériques sont décrits par les variables \(X_1,\ldots,X_n\), qui ont la même loi. Cette liste de variables constitue un échantillon aléatoire de taille \(n\).
De même loi signifie qu’elles ont les mêmes valeurs possibles avec les mêmes probabilités ; cela ne signifie pas qu’elles prennent la même valeur lors d’une réalisation. L’indépendance signifie ici que le modèle décrit des répétitions qui ne se modifient pas probabilistement les unes les autres.
Notation 4.5 — Une somme et une moyenne, deux variables différentes
On pose \[S_n=X_1+\cdots+X_n,\qquad M_n=\frac{S_n}{n}=\frac{X_1+\cdots+X_n}{n}.\] \(S_n\) est la somme ; \(M_n\) est la moyenne. Avant les répétitions, elles sont aléatoires. Après une réalisation, si les valeurs obtenues sont \(x_1,\ldots,x_n\), on observe le total \(s_n=x_1+\cdots+x_n\) et la moyenne \(m_n=s_n/n\).
Une mesure recopiée dans \(n\) cases n’est pas un échantillon de \(n\) mesures indépendantes : c’est toujours une seule mesure.
Intuition et représentation 4.6 — Additionner puis changer d’échelle
Le total rassemble les contributions de toutes les observations. La moyenne ramène ensuite ce total à l’échelle d’une seule observation en divisant par \(n\). C’est ce changement d’échelle qui peut réduire la dispersion.
L’image d’erreurs qui se compensent aide à comprendre l’intérêt d’une moyenne, mais a une limite importante : une compensation n’est pas promise à chaque expérience. Les formules suivantes décrivent la loi de la moyenne, et non une règle de compensation obligatoire entre les valeurs obtenues.
Pourquoi le coefficient est-il mis au carré dans une variance ?
Rappel 4.7 — Deux résultats antérieurs et le rôle de l’indépendance
La linéarité de l’espérance donne \[\operatorname{E}(X+Y)=\operatorname{E}(X)+\operatorname{E}(Y),\qquad \operatorname{E}(aY)=a\operatorname{E}(Y)\] pour une constante réelle \(a\). Ces égalités ne demandent pas l’indépendance.
Pour des variables provenant de répétitions indépendantes, on utilise en outre \[\operatorname{V}(X+Y)=\operatorname{V}(X)+\operatorname{V}(Y).\] Cette additivité des variances sous indépendance est un résultat antérieur admis au niveau du programme. En l’appliquant successivement, on additionne aussi les variances de \(n\) variables indépendantes. On ne l’étend pas sans justification à des variables dépendantes.
Propriété 4.8 — Multiplier une variable par une constante
Pour toute variable finie \(Y\) et toute constante réelle \(a\), \[\operatorname{V}(aY)=a^2\operatorname{V}(Y),\qquad \sigma(aY)=|a|\,\sigma(Y).\]
Démonstration. Notons \(y_i\) les valeurs de \(Y\), \(q_i\) leurs probabilités et \(m=\operatorname{E}(Y)\). La linéarité donne \(\operatorname{E}(aY)=am\). Pour la valeur \(y_i\), l’écart correspondant pour \(aY\) est \[ay_i-am=a(y_i-m).\] Son carré est \[[ay_i-am]^2=[a(y_i-m)]^2=a^2(y_i-m)^2.\] En utilisant les probabilités de \(Y\) comme poids, on obtient \[\begin{aligned} \operatorname{V}(aY) &=\sum_{i=1}^{r}[ay_i-am]^2q_i\\ &=\sum_{i=1}^{r}a^2(y_i-m)^2q_i\\ &=a^2\sum_{i=1}^{r}(y_i-m)^2q_i =a^2\operatorname{V}(Y). \end{aligned}\] Le facteur \(a^2\) est le même dans chaque terme : on peut le sortir de la somme. Si plusieurs valeurs de \(aY\) se confondent, regrouper leurs probabilités ne change pas cette somme. Cela couvre aussi \(a=0\), pour lequel la variance vaut \(0\).
Enfin \(\operatorname{V}(Y)\geq0\), et \(\sqrt{a^2}=|a|\) ; donc \(\sqrt{a^2\operatorname{V}(Y)}=|a|\sqrt{\operatorname{V}(Y)}\). Même si \(a<0\), un écart type ne devient jamais négatif.
Propriété 4.9 — Les moments de la moyenne
Soient \(X_1,\ldots,X_n\) des variables issues de \(n\) répétitions indépendantes d’une même expérience. Elles ont toutes pour espérance \(\mu\) et variance \(V\). Avec \(n\geq1\), \(S_n=X_1+\cdots+X_n\) et \(M_n=S_n/n\), \[\operatorname{E}(S_n)=n\mu,\quad \operatorname{V}(S_n)=nV,\qquad \operatorname{E}(M_n)=\mu,\quad \operatorname{V}(M_n)=\frac{V}{n},\quad \sigma(M_n)=\frac{\sqrt V}{\sqrt n}.\]
Démonstration. La linéarité de l’espérance donne \(\operatorname{E}(S_n)=\mu+\cdots+\mu=n\mu\). L’additivité des variances sous indépendance, résultat antérieur admis dans le programme, donne \(\operatorname{V}(S_n)=V+\cdots+V=nV\). Pour la moyenne, on multiplie \(S_n\) par \(1/n\), qui est une constante : \[\operatorname{E}(M_n)=\frac1n\operatorname{E}(S_n)=\frac1n\times n\mu =\frac{n}{n}\mu=\mu.\] La variance se multiplie par le carré du coefficient. Avec la règle \(\operatorname{V}(aY)=a^2\operatorname{V}(Y)\) rappelée dans cette unité, \[\operatorname{V}(M_n)=\left(\frac1n\right)^2\operatorname{V}(S_n) =\frac1{n^2}\times nV =\frac{nV}{n\times n} =\frac Vn.\] Le facteur \(n\) se simplifie car \(n\geq1\), donc \(n\neq0\). Enfin \(V\geq0\) et \(n>0\) permettent d’écrire \(\sqrt{V/n}=\sqrt V/\sqrt n\). Ne pas confondre. Le total est de plus en plus dispersé, tandis que la moyenne est de moins en moins dispersée ; on ne mesure pas la même grandeur.
Remarque 4.10 — Le cas où il n’y a aucune dispersion
Les comparaisons de dispersion de la somme et de la moyenne sont strictes lorsque \(V>0\) et que l’effectif augmente. Si \(V=0\), toutes les variances et tous les écarts types précédents sont nuls.
Dans une loi finie, \(V=0\) signifie que chaque valeur de probabilité non nulle est égale à \(\mu\) : les termes \((x_i-\mu)^2q_i\) sont non négatifs et leur somme ne peut être nulle que si chacun est nul. Ainsi \(X=\mu\) avec probabilité \(1\), puis \(M_n=\mu\) avec probabilité \(1\).
Exemple de référence 4.11 — La moyenne de petites erreurs de mesure
Un capteur possède une erreur aléatoire \(X\), exprimée en millimètres, de loi \[\begin{array}{c|ccc} x&-2&0&2\\ \hline \mathbb{P}(X=x)&1/4&1/2&1/4 \end{array}.\] Les erreurs de mesures distinctes sont supposées indépendantes et suivent cette même loi. Calculons d’abord les moments d’une erreur : \[\operatorname{E}(X)=(-2)\times\frac14+0\times\frac12+2\times\frac14 =-\frac12+0+\frac12=0,\] \[\begin{aligned} \operatorname{V}(X) &=(-2-0)^2\times\frac14+(0-0)^2\times\frac12+(2-0)^2\times\frac14\\ &=4\times\frac14+0\times\frac12+4\times\frac14=1+0+1=2. \end{aligned}\] Pour \(50\) mesures, la somme des erreurs a pour espérance \(50\times0=0\) et variance \(50\times2=100\). Sa dispersion augmente : son écart type vaut \(\sqrt{100}=10\).
Mais l’erreur moyenne est \(M_{50}=S_{50}/50\). Alors \[\operatorname{E}(M_{50})=0,\qquad \operatorname{V}(M_{50})=\frac{2}{50}=\frac1{25}=0{,}04,\qquad \sigma(M_{50})=\sqrt{\frac1{25}}=\frac15=0{,}2.\] L’erreur moyenne reste centrée sur \(0\) et son écart type vaut \(0{,}2\) mm. On n’a pas affirmé que chacune des cinquante erreurs, ni leur moyenne observée, serait nulle.
Passer de la variance à une garantie de concentration
Rappel 4.12 — L’inégalité utilisée, avec ses conditions
Pour toute variable aléatoire finie \(Y\), d’espérance \(m\) et de variance \(v\), et pour tout réel \(d>0\), Bienaymé–Tchebychev donne \[\mathbb{P}(|Y-m|\geq d)\leq\frac{v}{d^2}.\] Le membre de droite est une borne supérieure, pas nécessairement la probabilité exacte. Le mécanisme de la preuve est le suivant : dans la variance, chaque valeur à distance au moins \(d\) contribue au moins \(d^2\) multiplié par sa probabilité ; les autres contributions sont non négatives. La variance est donc au moins \(d^2\mathbb{P}(|Y-m|\geq d)\), et on divise par \(d^2>0\).
Théorème 4.13 — Concentration de la moyenne d’un échantillon
Soient \(X_1,\ldots,X_n\) les variables de \(n\) répétitions indépendantes de même loi finie, d’espérance \(\mu\) et de variance \(V\). On pose \(M_n=(X_1+\cdots+X_n)/n\), avec \(n\geq1\). Pour toute tolérance \(\delta>0\), \[\boxed{\mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2}.}\]
Démonstration. La moyenne \(M_n\) est une variable finie, d’espérance \(\mu\) et de variance \(V/n\), comme démontré dans cette unité à partir des résultats antérieurs indiqués. On lui applique Bienaymé–Tchebychev : \[\mathbb{P}(|M_n-\mu|\geq\delta) \leq\frac{\operatorname{V}(M_n)}{\delta^2} =\frac{V/n}{\delta^2} =\frac Vn\times\frac1{\delta^2} =\frac{V}{n\delta^2}.\] La division par \(\delta^2\) est permise car \(\delta>0\), donc \(\delta^2>0\) ; celle par \(n\) l’est car \(n\geq1\).
Ce qui est au numérateur. \(V\) est la variance d’une observation individuelle. Elle ne désigne pas déjà \(V/n\), la variance de la moyenne. On ne divise donc pas deux fois par \(n\).
Corollaire 4.14 — Une probabilité de rester près de l’espérance
Sous les mêmes hypothèses, \[\mathbb{P}(\mu-\delta<M_n<\mu+\delta) \geq1-\frac{V}{n\delta^2}.\]
Démonstration. Le complément exact de \(|M_n-\mu|\geq\delta\) est \(|M_n-\mu|<\delta\), c’est-à-dire \(\mu-\delta<M_n<\mu+\delta\). Si le risque extérieur est au plus \(b=V/(n\delta^2)\), sa probabilité contraire vaut \(1-\text{risque}\) et est au moins \(1-b\).
Si \(b>1\), la borne extérieure est vraie mais moins utile que \(1\) ; le minorant intérieur \(1-b\) est négatif et moins utile que \(0\). Cela n’autorise ni une probabilité supérieure à \(1\), ni une probabilité négative.
Lecture. Pour cette figure, la variable individuelle vaut \(0\), \(2\) ou \(4\), avec probabilités \(1/4\), \(1/2\) et \(1/4\) ; son espérance vaut \(2\) et sa variance \(2\). Les moyennes portent sur \(1\), \(4\) ou \(25\) répétitions indépendantes. Les échelles verticales diffèrent : comparer les positions et les dispersions, pas les seules hauteurs des barres entre panneaux. L’image illustre une tendance à la concentration, contrôlée par une borne de risque qui diminue ; elle n’affirme aucune monotonie universelle des probabilités réelles ni des moyennes observées.
Méthode 4.15 — Choisir la bonne variable avant de remplacer les lettres
Nommer l’observation individuelle. Préciser sa loi, ou au moins son espérance \(\mu\) et sa variance \(V\). Si l’énoncé donne \(\sigma\), calculer d’abord \(V=\sigma^2\).
Nommer la moyenne et l’effectif. Vérifier que \(M_n\) moyenne \(n\) répétitions indépendantes de même loi.
Traduire l’écart. Une erreur d’au moins \(\delta\) correspond à \(|M_n-\mu|\geq\delta\), avec \(\delta>0\).
Substituer sans sauter le carré. Écrire \(V/[n(\delta)^2]\), puis calculer.
Contrôler et conclure. Une borne de risque se lit au plus ; le complément donne une probabilité intérieure au moins.
Le détour par \(\operatorname{V}(M_n)=V/n\) est un bon contrôle lorsqu’on hésite sur le facteur \(n\).
Exemple de référence 4.16 — Ce que garantissent cinquante mesures
Reprenons localement les données utiles : erreurs indépendantes de même loi finie, espérance \(0\), variance individuelle \(2\), effectif \(50\). On veut contrôler l’événement où l’erreur moyenne atteint au moins \(0{,}5\) mm. \[\begin{aligned} \mathbb{P}(|M_{50}|\geq0{,}5) &\leq\frac{2}{50(0{,}5)^2}\\ &=\frac{2}{50\times0{,}25} =\frac{2}{12{,}5} =0{,}16. \end{aligned}\] Vérification par la variance de la moyenne : \(\operatorname{V}(M_{50})=0{,}04\), donc \(0{,}04/(0{,}5)^2=0{,}04/0{,}25=0{,}16\) aussi.
Le risque d’une erreur d’au moins \(0{,}5\) mm est donc au plus \(16\,\%\). Par complément, \[\mathbb{P}(-0{,}5<M_{50}<0{,}5)\geq1-0{,}16=0{,}84.\] Il s’agit d’une garantie d’au moins \(84\,\%\), pas d’une probabilité exacte annoncée égale à \(84\,\%\).
Contre-exemple 4.17 — Même loi ne signifie pas indépendance
Une variable \(Z\) vaut \(-2\) ou \(2\), avec probabilités \(1/2\) et \(1/2\). On mesure \(Z\) une fois, puis on recopie le résultat seize fois : \(X_1=\cdots=X_{16}=Z\).
Chaque case a bien la même loi, mais \[M_{16}=\frac{Z+\cdots+Z}{16}=\frac{16Z}{16}=Z.\] Or \(\operatorname{E}(Z)=(-2)/2+2/2=0\) et \(\operatorname{V}(Z)=4/2+4/2=4\). La variance de la moyenne vaut donc \(4\), pas \(4/16\).
On a même \(\mathbb{P}(|M_{16}|\geq1)=1\), car \(|Z|=2\). La fausse application de la concentration donnerait \(4/(16\times1^2)=1/4\). La contradiction vient de l’absence d’indépendance : recopier une observation n’ajoute aucune information indépendante.
S’entraîner : de l’aide guidée à une rédaction personnelle
À toi 4.18 — Une moyenne de durées
Des durées enregistrées au centième de milliseconde suivent une même loi finie, d’espérance \(12\) ms et de variance \(16\) ms\(^2\). On effectue \(64\) observations indépendantes et on note \(M_{64}\) leur moyenne.
Calcule \(\operatorname{E}(M_{64})\), \(\operatorname{V}(M_{64})\) et son écart type.
Écris une borne de \(\mathbb{P}(|M_{64}-12|\geq1)\).
Déduis une garantie pour \(\mathbb{P}(11<M_{64}<13)\).
Indices gradués. D’abord, la somme des variances vaut \(64\times16\). Ensuite, le coefficient appliqué à la somme est \(1/64\) et sa variance est multipliée par \((1/64)^2\). Enfin, l’événement de la question 3 est le contraire de celui de la question 2.
Correction expliquée 4.19 — La variance individuelle n’est pas celle de la moyenne
Les hypothèses d’indépendance et de même loi sont données. L’espérance de la somme vaut \(64\times12=768\) ; celle de la moyenne vaut \(768/64=12\).
La variance de la somme vaut \(64\times16=1\,024\). Ainsi \[\operatorname{V}(M_{64}) =\left(\frac1{64}\right)^2\times1\,024 =\frac{64\times16}{64\times64} =\frac{16}{64} =\frac14=0{,}25.\] L’écart type est \(\sqrt{1/4}=1/2=0{,}5\) ms. Pour \(\delta=1>0\), \[\mathbb{P}(|M_{64}-12|\geq1) \leq\frac{16}{64\times1^2} =\frac14=0{,}25.\] Par complément, la probabilité que la moyenne soit strictement entre \(11\) et \(13\) ms est au moins \(1-0{,}25=0{,}75\).
À toi 4.20 — À chercher avant d’ouvrir la correction
Une mesure numérique finie a pour espérance \(7\) et pour écart type \(3\). On moyenne \(144\) répétitions indépendantes de même loi. Donne une garantie de probabilité pour que la moyenne soit strictement comprise entre \(6{,}5\) et \(7{,}5\). Cette garantie permet-elle d’annoncer une probabilité d’au moins \(90\,\%\) ?
Indice 1, seulement si nécessaire. L’énoncé ne donne pas directement \(V\).
Indice 2. L’intervalle est centré sur \(7\) ; sa demi-largeur vaut \(0{,}5\), pas \(1\).
Correction expliquée 4.21 — Traduire l’écart type et la demi-largeur
La variance individuelle vaut \(V=\sigma^2=3^2=9\). Pour la moyenne, \[\operatorname{E}(M_{144})=7,\qquad \operatorname{V}(M_{144})=\frac9{144}=\frac1{16},\qquad \sigma(M_{144})=\frac14.\] L’événement demandé est \(|M_{144}-7|<0{,}5\). Son contraire est \(|M_{144}-7|\geq0{,}5\). La concentration donne \[\mathbb{P}(|M_{144}-7|\geq0{,}5) \leq\frac9{144(0{,}5)^2} =\frac9{144\times0{,}25} =\frac9{36} =\frac14.\] Donc \(\mathbb{P}(6{,}5<M_{144}<7{,}5)\geq3/4=75\,\%\).
Ce minorant de \(75\,\%\) ne permet pas de garantir \(90\,\%\). Il ne permet pas non plus d’affirmer que la vraie probabilité serait inférieure à \(90\,\%\) : une borne ne donne pas toute la loi.
À toi 4.22 — Justifier le facteur \(1/n\)
Explique avec une égalité à chaque étape pourquoi la variance de la moyenne de \(n\) observations indépendantes, chacune de variance \(V\), est \(V/n\) et non \(V/n^2\). Indique exactement où l’indépendance intervient.
Correction expliquée 4.23 — Une réponse possible et ses critères
Par indépendance, \(\operatorname{V}(S_n)=V+\cdots+V=nV\). Comme \(M_n=(1/n)S_n\) et que la variance multiplie le coefficient par lui-même, \[\operatorname{V}(M_n)=(1/n)^2\operatorname{V}(S_n) =\frac1{n^2}\times nV =\frac{nV}{n\times n} =\frac Vn.\] La simplification par \(n\) est permise puisque \(n\geq1\).
Critères de contenu. Ta réponse doit contenir le facteur \(nV\) provenant de la somme, le facteur \(1/n^2\) provenant de la moyenne, et la condition d’indépendance au premier passage. Écrire seulement la formule finale ne justifie pas le facteur.
À toi 4.24 — Changer de représentation : que devient l’écart type ?
La variance individuelle vaut \(9\). On passe d’une moyenne de \(9\) observations indépendantes de même loi à une moyenne de \(36\) observations. Un élève annonce : Il y a quatre fois plus d’observations, donc l’écart type est quatre fois plus petit. Corrige sa phrase en calculant les deux écarts types.
Correction expliquée 4.25 — Variance et écart type ne varient pas au même rythme
Pour \(n=9\), la variance de la moyenne vaut \(9/9=1\), donc son écart type vaut \(\sqrt1=1\). Pour \(n=36\), la variance vaut \(9/36=1/4\), donc l’écart type vaut \(\sqrt{1/4}=1/2\).
La variance est divisée par \(4\), mais l’écart type est divisé par \(\sqrt4=2\). La phrase correcte est donc : Avec quatre fois plus d’observations, l’écart type de la moyenne est deux fois plus petit.
Réparer une confusion fréquente, puis revenir au problème
Point de vigilance 4.26 — L’erreur : diviser la mauvaise variance
Pour \(25\) observations indépendantes de variance individuelle \(4\), Noah écrit \[\operatorname{V}(M_{25})=\frac{\operatorname{V}(X)}{25^2}=\frac4{625}.\] Il applique correctement le carré d’un coefficient, mais à la mauvaise variable : \(M_{25}\) est la somme divisée par \(25\), pas une observation unique divisée par \(25\).
Rappel 4.27 — Le trajet à reconstruire
Écris deux lignes distinctes : \[\text{observations}\ \longrightarrow\ S_n\ \text{de variance }nV, \qquad S_n\ \longrightarrow\ M_n=S_n/n\ \text{de variance }(1/n)^2(nV).\] Le premier passage additionne \(n\) contributions indépendantes. Le second change l’échelle de cette somme.
Exemple de référence 4.28 — Un cas plus simple, entièrement calculé
Quatre observations indépendantes ont chacune une variance égale à \(1\). La somme a pour variance \(1+1+1+1=4\). La moyenne est le quart de la somme : \[\operatorname{V}(M_4)=\left(\frac14\right)^2\times4 =\frac1{16}\times4=\frac4{16}=\frac14.\] La réponse \(1/16\) aurait oublié de multiplier par la variance \(4\) de la somme.
À toi 4.29 — Nouvel essai avant le retour
Neuf observations indépendantes ont chacune une variance égale à \(9\). Calcule successivement la variance de la somme, puis celle de la moyenne. Reprends ensuite le calcul de Noah pour \(n=25\) et \(V=4\).
Indice. Garde l’écriture \((1/n)^2\times(nV)\) jusqu’à la dernière simplification.
Correction expliquée 4.30 — Nouvel essai et retour à l’erreur initiale
Pour neuf observations, la variance de la somme vaut \(9\times9=81\). Celle de la moyenne vaut \[\left(\frac19\right)^2\times81=\frac{81}{81}=1.\] Pour les données de Noah, la variance de la somme vaut \(25\times4=100\), d’où \[\operatorname{V}(M_{25})=\left(\frac1{25}\right)^2\times100 =\frac{100}{625} =\frac{25\times4}{25\times25} =\frac4{25}=0{,}16.\] L’écart type de cette moyenne vaut \(\sqrt{0{,}16}=0{,}4\). Avant de poursuivre, explique oralement quelle variance Noah avait oubliée : c’est celle de la somme des \(25\) observations.
À reprendre plus tard, avant de relire
À toi 4.31 — Récupérer la méthode sans son modèle sous les yeux
Lors d’une prochaine séance, cache les formules précédentes. Des observations indépendantes de même loi finie ont pour espérance \(30\) et pour écart type \(6\). On en moyenne \(100\).
Retrouve les moments de la moyenne.
Donne une garantie pour qu’elle soit strictement entre \(28{,}5\) et \(31{,}5\).
Que devient la borne du risque si on utilise \(400\) observations ?
Aide de reprise. Passe de \(\sigma\) à \(V\), de la somme à la moyenne, puis de l’intervalle à sa demi-largeur. Essaie à nouveau avant de lire la réponse.
Correction expliquée 4.32 — Correction locale de la reprise
Ici \(V=6^2=36\). Pour \(100\) observations, la somme a pour variance \(100\times36=3\,600\) ; la moyenne a donc pour variance \[\left(\frac1{100}\right)^2\times3\,600 =\frac{3\,600}{10\,000}=0{,}36.\] Son espérance vaut \(30\) et son écart type vaut \(\sqrt{0{,}36}=0{,}6\). La demi-largeur de l’intervalle est \(\delta=1{,}5\), donc \[\mathbb{P}(|M_{100}-30|\geq1{,}5) \leq\frac{36}{100(1{,}5)^2} =\frac{36}{100\times2{,}25} =\frac{36}{225}=0{,}16.\] La probabilité intérieure est au moins \(1-0{,}16=0{,}84\).
Avec \(400\) observations, le même calcul donne \[\frac{36}{400\times2{,}25}=\frac{36}{900}=0{,}04.\] La borne du risque est divisée par \(4\) ; la garantie intérieure devient \(1-0{,}04=0{,}96\). L’écart type de la moyenne vaut alors \(6/\sqrt{400}=6/20=0{,}3\), soit la moitié de \(0{,}6\).
Synthèse 4.33 — Les trois contrôles à conserver
Pour une moyenne de \(n\geq1\) répétitions indépendantes de même loi finie : \[\operatorname{E}(M_n)=\mu,\qquad \operatorname{V}(M_n)=\frac Vn,\qquad \mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2}\quad(\delta>0).\] Vérifie toujours : quelle variable est moyennée ; quelle variance est individuelle ; quelles hypothèses rendent l’additivité des variances utilisable. La moyenne peut se concentrer sans que chaque observation soit plus précise.
5. Choisir une taille, une précision et un risque
Objectif. Transformer une garantie probabiliste en une condition sur un effectif, une tolérance ou un risque, sans confondre suffisance et nécessité.
Commencer par traduire la demande
À toi 5.1 — Avant la formule, identifier ce que l’on veut
Réponds avant de consulter la correction.
On veut une probabilité de réussite au moins égale à \(0{,}97\). Quel risque maximal d’échec cela représente-t-il ?
Une tolérance vaut \(0{,}4\). Quel nombre remplacera \(\delta^2\) ?
Une inéquation donne \(n\geq12{,}4\), avec \(n\) entier positif. Quel est le plus petit effectif admissible ?
Le calcul donne une borne de risque \(0{,}08\), alors que l’on souhaite un risque au plus \(0{,}05\). A-t-on prouvé que le risque réel dépassait \(0{,}05\) ?
Correction expliquée 5.2 — Quatre décisions qui évitent de faux seuils
1. Le risque maximal vaut \(1-0{,}97=0{,}03\), soit \(3\,\%\).
2. \(\delta^2=(0{,}4)^2=0{,}4\times0{,}4=0{,}16\).
3. Il faut choisir \(13\). L’entier \(12\) est plus proche de \(12{,}4\), mais il ne vérifie pas \(12\geq12{,}4\).
4. Non. Le majorant \(0{,}08\) est trop grand pour certifier l’objectif, mais le risque réel peut être plus petit que ce majorant.
Pour t’orienter. Si tu as confondu \(0{,}97\) et \(0{,}03\), commence par le vocabulaire du risque et la réparation de fin d’unité. Si tu as arrondi à \(12\), vérifie toujours les deux entiers autour du seuil. Si tu as conclu que l’objectif était impossible, lis particulièrement le contre-exemple effectif garanti et minimum réel.
Définition 5.3 — Tolérance, risque et probabilité de réussite
On note \(\mu\) l’espérance d’une observation et \(M_n\) la moyenne de \(n\) observations. On fixe une tolérance absolue \(\delta>0\) : réussir signifie ici \[|M_n-\mu|<\delta.\] La tolérance est la distance maximale retenue, pas la largeur totale de l’intervalle. L’intervalle correspondant est \(]\mu-\delta\,;\,\mu+\delta[\), de largeur \(2\delta\).
On fixe un risque maximal \(\alpha\), avec \(0<\alpha<1\). Demander \[\mathbb{P}(|M_n-\mu|<\delta)\geq1-\alpha\] équivaut à demander \[\mathbb{P}(|M_n-\mu|\geq\delta)\leq\alpha.\] C’est le passage au complément : les deux événements sont contraires et leurs probabilités ont pour somme \(1\). Une tolérance plus petite exige d’être plus près de \(\mu\) ; un risque plus petit exige une garantie plus forte.
Rappel 5.4 — Le modèle et la garantie utilisés dans toute cette unité
Une observation est décrite par une variable finie, d’espérance \(\mu\) et de variance \(V\geq0\). Si l’énoncé donne l’écart type \(\sigma\), alors \(V=\sigma^2\). On répète indépendamment la même expérience et l’on pose, pour \(n\geq1\), \[S_n=X_1+\cdots+X_n,\qquad M_n=\frac{S_n}{n}.\] La linéarité de l’espérance donne \(\operatorname{E}(M_n)=\mu\). L’additivité des variances indépendantes, résultat antérieur admis au niveau du programme, donne \(\operatorname{V}(S_n)=nV\). La règle \(\operatorname{V}(aY)=a^2\operatorname{V}(Y)\) découle de la définition : chaque écart \(y-\operatorname{E}(Y)\) est multiplié par \(a\), et son carré par \(a^2\). Par conséquent, \[\operatorname{V}(M_n)=\left(\frac1n\right)^2(nV) =\frac{nV}{n\times n}=\frac Vn.\] La simplification est permise car \(n\geq1\).
Bienaymé–Tchebychev affirme que \(\mathbb{P}(|Y-\operatorname{E}(Y)|\geq d)\leq\operatorname{V}(Y)/d^2\) pour une variable finie \(Y\) et \(d>0\). Appliqué à \(M_n\), ce résultat donne \[\boxed{\mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2}.}\] L’indépendance et la même loi sont des hypothèses du modèle, pas des mots que l’on ajoute après le calcul.
Choisir un effectif suffisant
Critère suffisant 5.5 — Un seuil qui garantit le risque demandé
Sous les hypothèses du rappel, avec \(\delta>0\) et \(0<\alpha<1\), il suffit de choisir un entier \(n\geq1\) tel que \[\boxed{n\geq\frac{V}{\alpha\delta^2}}\] pour obtenir \(\mathbb{P}(|M_n-\mu|\geq\delta)\leq\alpha\).
Démonstration. On ne résout pas directement l’inégalité portant sur la probabilité inconnue. On impose à son majorant d’être suffisamment petit : \[\begin{aligned} \frac{V}{n\delta^2}\leq\alpha &\iff V\leq\alpha n\delta^2 &&\text{car }n\delta^2>0,\\ &\iff \frac{V}{\alpha\delta^2}\leq n &&\text{car }\alpha\delta^2>0. \end{aligned}\] On a d’abord multiplié les deux membres par \(n\delta^2\), puis divisé les deux membres par \(\alpha\delta^2\). Les deux nombres sont positifs, donc le sens des inégalités ne change pas. La concentration permet alors d’enchaîner \[\mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2}\leq\alpha.\]
Pourquoi suffisant ? Le calcul assure l’objectif si la condition est satisfaite. Si elle ne l’est pas, il n’affirme pas que l’objectif échoue : la probabilité réelle peut être bien inférieure à son majorant.
Vocabulaire 5.6 — Prendre le premier entier admissible
L’effectif doit être entier. Après avoir calculé le seuil réel \(V/(\alpha\delta^2)\), on choisit le premier entier supérieur ou égal à ce seuil, tout en gardant \(n\geq1\). Cette opération est parfois appelée arrondi par excès ou plafond.
Si le seuil est déjà entier, on le garde pour une inégalité large. S’il se trouve entre deux entiers, on prend celui au-dessus. On ne choisit pas nécessairement l’entier le plus proche.
Si \(V=0\), le seuil réel vaut \(0\), mais une moyenne de zéro observation n’est pas définie : le plus petit effectif reste \(1\). Dans ce cas, toute observation vaut \(\mu\) avec probabilité \(1\), donc tout effectif positif convient.
Exemple de référence 5.7 — Trouver un effectif suffisant, puis contrôler l’arrondi
On moyenne \(n\) mesures indépendantes de même loi, de variance \(V=5\). On veut une erreur strictement inférieure à \(0{,}6\) avec une probabilité au moins \(0{,}95\). Le risque contraire doit donc être au plus \(\alpha=1-0{,}95=0{,}05\). La concentration donne \[\mathbb{P}(|M_n-\mu|\geq0{,}6)\leq\frac{5}{n(0{,}6)^2}.\] Pour que ce majorant soit au plus \(0{,}05\), il suffit de résoudre : \[\begin{aligned} \frac5{0{,}36n}\leq0{,}05 &\iff 5\leq0{,}05\times0{,}36n &&(0{,}36n>0)\\ &\iff 5\leq0{,}018n\\ &\iff \frac5{0{,}018}\leq n &&(0{,}018>0)\\ &\iff n\geq\frac{2500}{9}=277+\frac79. \end{aligned}\] On choisit le premier entier supérieur ou égal au seuil, soit \(278\). La règle est l’arrondi par excès ; ici, l’arrondi au plus proche coïncide avec lui, mais ce n’est pas une règle valable dans tous les cas. Pour vérifier réellement la frontière : \[0{,}018\times277=4{,}986<5, \qquad0{,}018\times278=5{,}004\geq5.\] Avec \(n=278\), la borne vaut \(5/100{,}08\approx0{,}04996\leq0{,}05\). Conclusion exacte. \(278\) est le plus petit effectif entier satisfaisant ce certificat par la borne. Le risque réel peut déjà être inférieur à \(0{,}05\) pour un effectif plus petit ; cette méthode ne permet pas de l’exclure.
Méthode 5.8 — Une rédaction complète en cinq gestes
Rassembler les paramètres. Écrire \(V\), \(\delta\) et \(\alpha\) ; convertir un écart type en variance et une probabilité de réussite en risque.
Écrire la garantie. Nommer \(M_n\), les répétitions indépendantes de même loi et l’événement d’écart.
Résoudre pour le majorant. Montrer le carré de \(\delta\) et les opérations effectuées sur les deux membres.
Choisir un entier. Contrôler la valeur choisie et l’entier précédent dans l’inéquation déterminante.
Conclure sans excès. Dire effectif suffisant ou plus petit effectif certifié par cette borne, pas automatiquement effectif minimal réel.
Proposition 5.9 — Un risque strict et un risque large ne demandent pas le même certificat
Pour garantir un risque strictement inférieur à \(\alpha\) par le majorant, on peut imposer \[\frac{V}{n\delta^2}<\alpha \quad\Longleftrightarrow\quad n>\frac{V}{\alpha\delta^2}.\]
Démonstration. Les mêmes multiplications et divisions positives que dans le critère précédent conservent cette fois les signes stricts. Le risque est au plus le majorant ; si le majorant est strictement inférieur à \(\alpha\), le risque l’est aussi.
On prend alors le premier entier strictement supérieur au seuil réel, avec \(n\geq1\). La différence apparaît lorsque ce seuil est entier.
Exemple de référence 5.10 — Lorsque le seuil tombe exactement sur un entier
Prenons \(V=2\), \(\delta=0{,}5\) et \(\alpha=0{,}10\). Le seuil vaut \[\frac{2}{0{,}10(0{,}5)^2} =\frac2{0{,}10\times0{,}25} =\frac2{0{,}025}=80.\] Pour un majorant au plus égal à \(0{,}10\), \(n=80\) suffit : \[\frac2{80\times0{,}25}=\frac2{20}=0{,}10.\] Pour rendre ce majorant strictement inférieur à \(0{,}10\), on choisit \(n=81\) : \[\frac2{81\times0{,}25}=\frac{8}{81}<\frac8{80}=0{,}10,\] car \(81>80>0\) et le numérateur est positif.
Avec \(80\), la borne donne une probabilité de réussite au moins égale à \(90\,\%\). Avec \(81\), elle donne une probabilité de réussite strictement supérieure à \(90\,\%\). On ne prétend pas que la vraie probabilité ne pourrait pas déjà dépasser \(90\,\%\) pour \(80\) observations : seul le certificat a changé.
Remarque 5.11 — Si l’intervalle demandé est fermé
Pour garantir \(\mathbb{P}(|M_n-\mu|\leq\delta)\geq1-\alpha\), le risque contraire est \(\mathbb{P}(|M_n-\mu|>\delta)\). L’événement strict \(|M_n-\mu|>\delta\) est inclus dans \(|M_n-\mu|\geq\delta\) ; sa probabilité bénéficie donc du même majorant.
Les garanties précédentes restent suffisantes, mais cela n’autorise pas à confondre les deux événements : dans une loi discrète, les valeurs exactement aux extrémités peuvent avoir une probabilité non nulle.
L’inconnue n’est pas toujours l’effectif
Propriété 5.12 — Choisir une tolérance pour un effectif imposé
Pour \(V>0\), \(n\geq1\) et \(0<\alpha<1\) fixés, le certificat de concentration est satisfait dès que \[\delta\geq\sqrt{\frac{V}{n\alpha}}.\]
Démonstration. On part d’une tolérance \(\delta>0\). En multipliant par \(n\delta^2>0\), puis en divisant par \(n\alpha>0\), \[\frac{V}{n\delta^2}\leq\alpha \iff V\leq n\alpha\delta^2 \iff \frac{V}{n\alpha}\leq\delta^2.\] Les deux membres sont non négatifs. La racine carrée conserve leur ordre ; comme \(\delta>0\), \(\sqrt{\delta^2}=\delta\). On obtient l’inégalité annoncée.
Il s’agit de la plus petite tolérance certifiée par ce calcul, pas nécessairement de la meilleure tolérance permise par la loi exacte. Si \(V=0\), toute tolérance strictement positive convient ; il n’existe alors pas de plus petite tolérance strictement positive.
Exemple de référence 5.13 — La précision accessible avec un effectif fixé
La variance individuelle est \(V=9\), l’effectif est \(n=400\) et on souhaite un risque au plus \(0{,}04\). La tolérance \(\delta\) doit être strictement positive. On impose au majorant : \[\begin{aligned} \frac9{400\delta^2}\leq0{,}04 &\iff 9\leq0{,}04\times400\delta^2 &&(400\delta^2>0)\\ &\iff 9\leq16\delta^2\\ &\iff \frac9{16}\leq\delta^2 &&(16>0)\\ &\iff \frac34\leq\delta &&(\delta>0). \end{aligned}\] Pour la dernière équivalence, on prend la racine carrée des deux membres, qui sont non négatifs. La fonction racine carrée conserve l’ordre ; \(\sqrt{\delta^2}=\delta\) parce que \(\delta>0\), et \(\sqrt{9/16}=3/4\). La plus petite tolérance positive certifiée ici est donc \(\delta=0{,}75\). Vérifions : \[\frac9{400(0{,}75)^2} =\frac9{400\times0{,}5625} =\frac9{225} =0{,}04.\] Ainsi \(\mathbb{P}(|M_{400}-\mu|<0{,}75)\geq0{,}96\). Une tolérance plus grande est aussi certifiée : elle demande d’être moins près de \(\mu\). Une tolérance plus petite n’est pas certifiée par cette borne, ce qui ne prouve pas que la probabilité réelle serait insuffisante.
Méthode 5.14 — Calculer ce que l’on peut garantir avec les moyens disponibles
Si \(n\) et \(\delta\) sont imposés, on ne résout plus pour \(n\). On calcule \[b=\frac{V}{n\delta^2}.\] Si \(b\leq1\), le risque est au plus \(b\) et la probabilité de réussite est au moins \(1-b\). Si \(b>1\), on conserve seulement les bornes triviales \(0\leq\mathbb{P}(\text{événement})\leq1\) : le calcul n’apporte pas de garantie numérique utile à cette précision.
Exemple. Avec \(V=4\), \(n=100\) et \(\delta=0{,}5\), \[b=\frac4{100(0{,}5)^2} =\frac4{100\times0{,}25} =\frac4{25}=0{,}16.\] La probabilité d’une erreur strictement inférieure à \(0{,}5\) est donc au moins \(1-0{,}16=0{,}84\). Ce n’est pas automatiquement un risque exactement égal à \(16\,\%\).
Propriété 5.15 — La précision a un coût quadratique
À variance \(V\) et risque \(\alpha\) fixés, le seuil réel d’effectif est \(V/(\alpha\delta^2)\). Remplacer la tolérance \(\delta\) par \(\delta/2\) multiplie ce seuil par \(4\) : \[\begin{aligned} \frac{V}{\alpha(\delta/2)^2} &=\frac{V}{\alpha\delta^2/4} =V\times\frac4{\alpha\delta^2} =4\frac{V}{\alpha\delta^2}. \end{aligned}\]
Démonstration. Le carré de \(\delta/2\) vaut \(\delta^2/4\). Son dénominateur \(\alpha\delta^2/4\) est strictement positif ; diviser par ce quotient revient à multiplier par son inverse \(4/(\alpha\delta^2)\).
Ainsi, si \(n\) certifie une tolérance \(\delta\), \(4n\) certifie une tolérance \(\delta/2\) avec le même risque. Le seuil réel est exactement quadruplé ; les plus petits effectifs entiers subissent en plus les arrondis.
À tolérance fixée, diviser le risque demandé par \(2\) multiplie le seuil réel par \(2\), car \[\frac{V}{(\alpha/2)\delta^2}=2\frac{V}{\alpha\delta^2}.\]
Lecture. À variance et risque fixés, l’effectif suffisant est gouverné par l’inverse du carré de la tolérance. Diviser la tolérance par deux conduit à quadrupler le seuil réel d’effectif ; la dernière étape reste un choix d’entier admissible.
Question que tu peux te poser 5.16 — Pourquoi ne fixe-t-on pas directement un risque nul ?
Pour \(V>0\), \(n\) fini et \(\delta>0\), le majorant \(V/(n\delta^2)\) est strictement positif. Cette borne ne peut donc pas certifier un risque nul par le même calcul.
Cela ne signifie pas que le risque réel soit toujours positif. Par exemple, les valeurs possibles peuvent toutes être dans l’intervalle demandé. Il faut alors exploiter la loi ou ses bornes, et non demander à la concentration une conclusion qu’elle ne donne pas. Pour \(V=0\), le risque est effectivement nul à toute tolérance positive.
Contre-exemple 5.17 — Effectif garanti et minimum réel
Une observation \(X\) vaut \(-1\) ou \(1\) avec la même probabilité \(1/2\). Son espérance est \(0\) et sa variance vaut \(1\). On souhaite \[\mathbb{P}(|M_n|\geq1{,}5)\leq0{,}10\] pour une moyenne de répétitions indépendantes de cette loi.
La concentration fournit le seuil \[n\geq\frac1{0{,}10(1{,}5)^2} =\frac1{0{,}225}=\frac{40}{9},\] donc le premier entier certifié par cette borne est \(5\).
Mais chaque observation est comprise entre \(-1\) et \(1\). En additionnant les \(n\) encadrements, on obtient \(-n\leq S_n\leq n\), puis, en divisant par \(n>0\), \(-1\leq M_n\leq1\). L’événement \(|M_n|\geq1{,}5\) est donc impossible : son risque vaut \(0\), même pour \(n=1\).
Le plus petit effectif réel est ici \(1\), alors que le plus petit effectif certifié par la borne est \(5\). Il n’y a pas contradiction : la borne a ignoré une information utile sur les valeurs possibles.
Essais progressifs et justifications
À toi 5.18 — Construire le certificat, ligne après ligne
On moyenne des observations indépendantes de même loi finie, de variance \(3\). On souhaite une erreur strictement inférieure à \(0{,}4\) avec une probabilité au moins égale à \(95\,\%\).
Précise \(\delta\) et \(\alpha\).
Écris l’inéquation imposée au majorant de concentration et résous-la.
Choisis le plus petit entier certifié ; vérifie la frontière.
Quel premier entier rendrait le majorant strictement inférieur au risque demandé ?
Indices. Le risque vaut \(1-0{,}95\). Le carré de la tolérance vaut \(0{,}16\). Multiplie les deux membres par \(0{,}16n>0\), puis divise par le coefficient positif de \(n\).
Correction expliquée 5.19 — Seuil large puis seuil strict
On a \(\delta=0{,}4\) et \(\alpha=0{,}05\). Il suffit d’imposer \[\begin{aligned} \frac3{n(0{,}4)^2}\leq0{,}05 &\iff\frac3{0{,}16n}\leq0{,}05\\ &\iff3\leq0{,}05\times0{,}16n &&(0{,}16n>0)\\ &\iff3\leq0{,}008n\\ &\iff n\geq\frac3{0{,}008}=375 &&(0{,}008>0). \end{aligned}\] Le premier entier est \(375\). Vérifions : \(0{,}008\times374=2{,}992<3\), alors que \(0{,}008\times375=3\). La borne au seuil vaut \[\frac3{375\times0{,}16}=\frac3{60}=0{,}05.\] On garantit donc une probabilité de réussite au moins égale à \(0{,}95\).
Pour imposer un majorant strictement inférieur à \(0{,}05\), on obtient \(n>375\), dont le premier entier est \(376\). Le risque réel n’est pas nécessairement égal au majorant dans l’un ou l’autre cas.
À toi 5.20 — À résoudre sans formule de seuil sous les yeux
Une erreur de mesure de loi finie a pour écart type \(1{,}5\). Les mesures répétées sont indépendantes et de même loi. On souhaite que l’erreur moyenne soit à une distance strictement inférieure à \(0{,}4\) de son espérance, avec une probabilité au moins égale à \(97\,\%\).
Propose un effectif suffisant aussi petit que le permet la concentration. Justifie le choix entier et explique exactement ce que signifie ta conclusion.
Indice 1. Il faut une variance et un risque, alors que l’énoncé donne un écart type et une probabilité de réussite.
Indice 2. Teste les deux entiers qui entourent le seuil réel, sans arrondir prématurément les coefficients.
Correction expliquée 5.21 — Toutes les conversions avant l’arrondi
La variance vaut \(V=(1{,}5)^2=2{,}25\) ; le risque maximal vaut \(\alpha=1-0{,}97=0{,}03\). Avec \(\delta=0{,}4\), la concentration est \[\mathbb{P}(|M_n-\mu|\geq0{,}4)\leq\frac{2{,}25}{n(0{,}4)^2}.\] On impose \[\begin{aligned} \frac{2{,}25}{0{,}16n}\leq0{,}03 &\iff2{,}25\leq0{,}03\times0{,}16n &&(0{,}16n>0)\\ &\iff2{,}25\leq0{,}0048n\\ &\iff n\geq\frac{2{,}25}{0{,}0048}=468{,}75 &&(0{,}0048>0). \end{aligned}\] Le premier entier admissible est \(469\). Contrôle : \[0{,}0048\times468=2{,}2464<2{,}25,\qquad 0{,}0048\times469=2{,}2512\geq2{,}25.\] Pour \(469\) observations, le risque est au plus \[\frac{2{,}25}{469\times0{,}16} =\frac{2{,}25}{75{,}04} \approx0{,}029984<0{,}03.\] La probabilité de réussite est donc au moins \(0{,}97\). \(469\) est le plus petit entier satisfaisant ce certificat ; le calcul ne prouve pas que \(468\) échouerait pour la probabilité réelle.
À toi 5.22 — Pourquoi la condition ne devient-elle pas nécessaire ?
Un élève a trouvé \(n\geq469\) par la concentration. Il écrit : Avec \(468\) observations, le risque est forcément trop élevé. Explique précisément l’erreur de raisonnement, sans te contenter de dire que la borne est grossière.
Correction expliquée 5.23 — Une réponse possible
La concentration donne une inégalité du type \(r_n\leq b_n\), où \(r_n\) est le risque réel. Si \(b_n\leq\alpha\), alors \(r_n\leq\alpha\). Mais si \(b_n>\alpha\), cela ne compare pas \(r_n\) à \(\alpha\) : un nombre inférieur à \(b_n\) peut être inférieur ou supérieur à \(\alpha\). On a trouvé une condition suffisante pour le risque, pas une équivalence avec ce risque.
Critères de contenu. Il faut distinguer les deux nombres \(r_n\) et \(b_n\), écrire le bon sens de l’inégalité et expliquer pourquoi une borne trop grande ne prouve pas un risque trop grand. Le contre-exemple de cette unité montre que la différence peut être réelle.
À toi 5.24 — Choisir ce qui doit changer
Sans refaire tous les calculs numériques, explique comment modifier un protocole qui certifie une tolérance \(\delta\) avec un risque \(\alpha\) :
on exige la même tolérance mais un risque divisé par \(2\) ;
on exige la même garantie de risque mais une tolérance divisée par \(2\) ;
on garde le nombre de mesures mais on les remplace par des copies d’une seule mesure.
Indice. Dans les deux premières questions, regarde séparément les facteurs \(\alpha\) et \(\delta^2\) au dénominateur. Dans la troisième, examine le modèle avant les nombres.
Correction expliquée 5.25 — Paramètres et hypothèses ne jouent pas le même rôle
1. Doubler l’effectif suffit : le majorant \(V/(n\delta^2)\) est divisé par \(2\).
2. Quadrupler l’effectif suffit, car \[\frac{V}{(4n)(\delta/2)^2} =\frac{V}{4n\times\delta^2/4} =\frac{V}{n\delta^2}.\] La tolérance plus exigeante est compensée par le facteur \(4\) sur l’effectif.
3. Aucun changement purement numérique de la formule ne répare la perte d’indépendance. La moyenne de copies d’une seule valeur reste cette valeur. On ne dispose plus de la variance \(V/n\) ; il faut revenir au modèle.
Réparer la confusion entre réussite et risque
Point de vigilance 5.26 — Une erreur qui rend l’effectif artificiellement petit
Pour \(V=1\), \(\delta=0{,}5\) et une réussite d’au moins \(95\,\%\), Sarah remplace \(\alpha\) par \(0{,}95\). Elle obtient un seuil voisin de \(4{,}21\) et choisit \(5\) observations.
Le mauvais nombre est le risque : \(0{,}95\) décrit la réussite demandée. Le risque contraire est \(1-0{,}95=0{,}05\). Avec \(n=5\), le majorant réel de la méthode vaut \[\frac1{5(0{,}5)^2}=\frac1{5\times0{,}25}=0{,}8.\] La garantie de réussite obtenue est seulement \(1-0{,}8=0{,}2\), pas \(0{,}95\).
Rappel 5.27 — Écrire l’événement contraire avant le seuil
Si \(A\) est l’événement de réussite, alors \(\mathbb{P}(A)+\mathbb{P}(\overline A)=1\). Ainsi \(\mathbb{P}(A)\geq c\) équivaut à \(\mathbb{P}(\overline A)\leq1-c\). Le paramètre \(\alpha\) est ce dernier nombre \(1-c\).
Exemple de référence 5.28 — Un cas simple pour rétablir le sens
Pour une variance \(1\), une tolérance \(1\) et une réussite souhaitée d’au moins \(80\,\%\), le risque vaut \(1-0{,}8=0{,}2\). Le certificat devient \[\frac1{n\times1^2}\leq0{,}2 \iff1\leq0{,}2n \iff n\geq5.\] On a multiplié par \(n>0\), puis divisé par \(0{,}2>0\). Au seuil, le risque est au plus \(1/5=0{,}2\) et la réussite est au moins \(4/5=0{,}8\).
À toi 5.29 — Nouvel essai puis retour aux données initiales
Trouve un effectif suffisant lorsque \(V=2\), \(\delta=1\) et que l’on veut une réussite d’au moins \(90\,\%\). Reprends ensuite les données de Sarah : \(V=1\), \(\delta=0{,}5\), réussite d’au moins \(95\,\%\).
Indice. Écris d’abord deux soustractions : \(1-0{,}90\) et \(1-0{,}95\).
Correction expliquée 5.30 — Le bon risque dans chacun des deux cas
Pour le nouvel essai, \(\alpha=0{,}10\), donc \[\frac2n\leq0{,}10 \iff2\leq0{,}10n \iff n\geq20.\] Le premier entier est \(20\), et \(2/20=0{,}10\) vérifie la frontière.
Pour Sarah, \(\alpha=0{,}05\) et \((0{,}5)^2=0{,}25\), donc \[\frac1{0{,}25n}\leq0{,}05 \iff1\leq0{,}05\times0{,}25n \iff1\leq0{,}0125n \iff n\geq80.\] Les multiplications et divisions portent sur des nombres positifs. Avec \(80\) observations, le majorant vaut \(1/(80\times0{,}25)=1/20=0{,}05\) et la réussite est au moins \(0{,}95\). Le choix \(5\) provenait bien de la confusion entre l’événement et son contraire.
À reprendre plus tard, sans regarder la méthode
À toi 5.31 — Une nouvelle décision de protocole
Lors d’une prochaine séance, cherche d’abord sans relire : des mesures indépendantes de même loi finie ont une variance \(0{,}72\). On veut une erreur moyenne strictement inférieure à \(0{,}2\) avec une probabilité au moins égale à \(98\,\%\).
Donne le plus petit effectif certifié par la concentration, avec un contrôle de l’entier précédent.
Quelle garantie obtiendrait-on avec \(3\,600\) observations, à la même tolérance ?
Quel premier entier rendrait le majorant strictement inférieur à \(2\,\%\) ?
Aide de reprise. Le produit à calculer avant l’arrondi est \((1-0{,}98)\times(0{,}2)^2\).
Correction expliquée 5.32 — Correction complète de la décision
On a \(\alpha=0{,}02\) et \(\delta^2=0{,}04\), donc \[\begin{aligned} \frac{0{,}72}{0{,}04n}\leq0{,}02 &\iff0{,}72\leq0{,}02\times0{,}04n\\ &\iff0{,}72\leq0{,}0008n\\ &\iff n\geq\frac{0{,}72}{0{,}0008}=900. \end{aligned}\] La première opération multiplie par \(0{,}04n>0\), la dernière divise par \(0{,}0008>0\). Le seuil est entier. Avec \(899\), le produit \(0{,}0008\times899=0{,}7192\) reste inférieur à \(0{,}72\) ; avec \(900\), il vaut exactement \(0{,}72\).
Avec \(3\,600\) observations, \[\frac{0{,}72}{3\,600(0{,}2)^2} =\frac{0{,}72}{3\,600\times0{,}04} =\frac{0{,}72}{144}=0{,}005.\] Le risque est au plus \(0{,}5\,\%\) et la réussite au moins \(99{,}5\,\%\).
Pour imposer un majorant strictement inférieur à \(0{,}02\), il faut \(n>900\) ; le premier entier est \(901\). Ces seuils concernent le certificat, pas une connaissance de la probabilité exacte.
Synthèse 5.33 — Une même inégalité, trois inconnues possibles
Dans le modèle de répétitions indépendantes de même loi finie, avec \(V\geq0\), \(n\geq1\), \(\delta>0\) et \(0<\alpha<1\), on travaille avec \[\mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2}.\] On peut choisir \(n\), choisir \(\delta\) ou calculer le risque que l’on sait majorer. Le noyau du raisonnement est toujours le même : comprendre l’événement, contrôler les conditions, imposer une borne suffisante, puis interpréter sans transformer la borne en égalité.
6. La loi des grands nombres : énoncé, preuve et portée
Objectif. Démontrer que le risque d’un écart fixé devient petit, puis distinguer ce résultat des idées de compensation, de certitude et de rapprochement monotone.
Quel type d’affirmation va-t-on démontrer ?
À toi 6.1 — Quatre phrases à examiner
Indique si chaque phrase est vraie ou fausse, puis donne une raison.
Si une probabilité tend vers \(0\), elle finit nécessairement par être égale à \(0\).
Une moyenne de résultats indépendants est nécessairement plus proche de son espérance après chaque nouvelle observation.
Pour \(V\) et \(\delta>0\) fixés, le nombre \(V/(n\delta^2)\) est divisé par \(4\) lorsque l’on remplace \(n\) par \(4n\).
Après plusieurs échecs indépendants, un succès devient plus probable pour rattraper le retard.
Correction expliquée 6.2 — Limite, moyenne observée et prochain essai
1. Faux. La suite \(1/n\) tend vers \(0\), mais \(1/n>0\) pour chaque entier \(n\geq1\). Une limite n’est pas nécessairement une valeur atteinte.
2. Faux. Une nouvelle observation peut éloigner la moyenne du centre. Un contre-exemple entièrement calculé est donné dans cette unité.
3. Vrai. En gardant \(V\) et \(\delta\) inchangés, \[\frac{V}{(4n)\delta^2} =\frac14\,\frac{V}{n\delta^2}.\] Ce calcul porte sur une borne, pas sur la probabilité exacte ni sur un résultat observé.
4. Faux. Dans un modèle d’essais indépendants de même loi, le prochain essai conserve sa probabilité de succès.
Pour t’orienter. Une hésitation à la première question invite à lire le rappel sur l’encadrement. Pour les deuxième et quatrième, cherche la différence entre une loi de probabilité et une trajectoire observée. Pour la troisième, surveille ce qui est fixé et ce qui varie.
Rappel 6.3 — Le cadre complet : loi finie, répétitions et moyenne
Une variable finie \(X\) prend des valeurs \(x_j\) avec probabilités \(q_j\geq0\), de somme \(1\). Son espérance et sa variance sont \[\mu=\sum_j x_jq_j,\qquad V=\sum_j(x_j-\mu)^2q_j\geq0.\] Ces sommes additionnent un nombre fini de termes. On note \(\sigma=\sqrt V\).
On répète indépendamment cette même expérience. \(X_i\) désigne le résultat numérique du \(i\)-ème essai, et \[S_n=X_1+\cdots+X_n,\qquad M_n=\frac{S_n}{n}\quad(n\geq1).\] \(\mu\) et \(V\) décrivent la loi individuelle, qui ne change pas avec \(n\). Le nombre \(n\) compte les observations utilisées dans la moyenne.
Rappel 6.4 — La garantie quantitative disponible
La linéarité de l’espérance donne \(\operatorname{E}(S_n)=n\mu\) et \(\operatorname{E}(M_n)=\mu\). L’additivité des variances de répétitions indépendantes, résultat antérieur admis dans le programme, donne \(\operatorname{V}(S_n)=nV\).
Pourquoi le coefficient \(1/n\) est-il mis au carré ? Pour une variable finie \(Y\), de valeurs \(y_j\), probabilités \(q_j\) et espérance \(m\), la linéarité donne \(\operatorname{E}(aY)=am\), puis la définition donne \[\operatorname{V}(aY) =\sum_j(ay_j-am)^2q_j =\sum_j a^2(y_j-m)^2q_j =a^2\operatorname{V}(Y).\] On a factorisé \(ay_j-am=a(y_j-m)\) avant de mettre au carré. Ainsi \[\operatorname{V}(M_n) =\left(\frac1n\right)^2(nV) =\frac{nV}{n\times n}=\frac Vn,\] puisque \(n\geq1\).
L’inégalité de Bienaymé–Tchebychev, pour une variable finie \(Y\) et un nombre \(d>0\), est \(\mathbb{P}(|Y-\operatorname{E}(Y)|\geq d)\leq\operatorname{V}(Y)/d^2\). Appliquée à \(M_n\), elle donne la concentration : \[\mathbb{P}(|M_n-\mu|\geq\delta) \leq\frac{V/n}{\delta^2} =\frac{V}{n\delta^2}\qquad(\delta>0).\] Ce rappel reprend tous les paramètres dont la preuve suivante dépend.
Notation 6.5 — Une suite de probabilités, pas une suite de mesures
Pour une tolérance \(\delta>0\) fixée, on peut noter \[r_n=\mathbb{P}(|M_n-\mu|\geq\delta).\] Chaque \(r_n\) est un nombre réel entre \(0\) et \(1\). La moyenne \(M_n\) est aléatoire avant l’expérience ; sa valeur observée \(m_n\) dépend des résultats obtenus. Les nombres \(r_n\) décrivent les risques attachés aux différentes tailles d’échantillon.
Rappel 6.6 — Le principe d’encadrement utilisé
Si, pour tout \(n\) assez grand, \(0\leq u_n\leq b_n\) et si \(b_n\) tend vers \(0\), alors \(u_n\) tend vers \(0\). C’est le théorème d’encadrement des suites numériques.
L’idée est que \(b_n\) finit par être plus petit que n’importe quelle marge positive choisie à l’avance ; \(u_n\), qui reste entre \(0\) et \(b_n\), est alors lui aussi dans cette marge. Il n’est pas nécessaire que \(u_n\) décroisse à chaque étape.
Théorème 6.7 — Loi des grands nombres
On répète indépendamment une même expérience de loi finie, d’espérance \(\mu\) et de variance \(V\). On note \(M_n=(X_1+\cdots+X_n)/n\) la moyenne des \(n\) premières observations. Pour toute précision fixée \(\delta>0\), \[\boxed{\lim_{n\to+\infty}\mathbb{P}(|M_n-\mu|\geq\delta)=0.}\]
Démonstration. La concentration, rappelée ici avec ses hypothèses, donne \[0\leq\mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2} =\frac{V}{\delta^2}\times\frac1n.\] Le nombre \(V/\delta^2\) est une constante : ni la loi individuelle ni la précision ne changent quand \(n\) augmente. Or \(1/n\) tend vers \(0\) ; la borne de droite tend donc vers \(0\). La borne de gauche vaut toujours \(0\). Le théorème d’encadrement des suites donne alors la limite annoncée. Ce qui converge ici. La quantité encadrée est un nombre réel, une probabilité pour chaque \(n\). Ce n’est pas une affirmation selon laquelle chaque moyenne observée devient exactement \(\mu\) après un certain nombre d’essais. Condition décisive. On a fixé \(\delta\) avant de faire tendre \(n\) vers l’infini. Si l’on remplace \(\delta\) par \(1/\sqrt n\), le majorant devient \(V/[n(1/\sqrt n)^2]=V\), et cette preuve ne donne plus une limite nulle.
Corollaire 6.8 — La probabilité d’être dans un voisinage fixé tend vers un
Sous les hypothèses du théorème, pour toute tolérance fixée \(\delta>0\), \[\lim_{n\to+\infty}\mathbb{P}(\mu-\delta<M_n<\mu+\delta)=1.\]
Démonstration. L’événement intérieur équivaut à \(|M_n-\mu|<\delta\). Son contraire exact est \(|M_n-\mu|\geq\delta\), donc \[\mathbb{P}(|M_n-\mu|<\delta)=1-r_n.\] Comme \(r_n\) tend vers \(0\), le membre de droite tend vers \(1-0=1\).
Le résultat reste vrai pour l’intervalle fermé \([\mu-\delta\,;\,\mu+\delta]\). En effet, l’événement ouvert y est inclus, donc \[\mathbb{P}(|M_n-\mu|<\delta) \leq\mathbb{P}(|M_n-\mu|\leq\delta)\leq1.\] Les deux bornes tendent vers \(1\), et l’encadrement conclut. Les probabilités ouverte et fermée ne sont pas nécessairement égales pour un \(n\) donné.
Proposition 6.9 — Ce que signifie concrètement devient petit
On fixe une tolérance \(\delta>0\) et un risque \(\alpha\) avec \(0<\alpha<1\). Sous les hypothèses du théorème, choisir un entier \(N\geq1\) tel que \[N\geq\frac{V}{\alpha\delta^2}\] assure que, pour chaque \(n\geq N\), \[\mathbb{P}(|M_n-\mu|\geq\delta)\leq\alpha.\]
Démonstration. Pour \(n\geq N\geq1\), on a \(1/n\leq1/N\). Comme \(V/\delta^2\geq0\), \[\mathbb{P}(|M_n-\mu|\geq\delta) \leq\frac{V}{n\delta^2} \leq\frac{V}{N\delta^2} \leq\alpha.\] La dernière inégalité vient du choix de \(N\).
Le nombre \(N\) dépend de la précision et du risque choisis. Cette proposition donne un seuil pour des probabilités. Elle ne dit pas que toutes les expériences possibles, ni tous leurs résultats futurs pris simultanément, seront à l’intérieur de l’intervalle après ce seuil.
Intuition et représentation 6.10 — Une bande fixe dans laquelle les moyennes se concentrent
Imagine que l’on recommence un protocole complet de \(n\) observations, puis que l’on place un point pour chaque moyenne obtenue. On garde la même bande autour de \(\mu\) pendant que l’on augmente \(n\). La loi des grands nombres explique pourquoi le risque qu’un point soit hors de cette bande tend vers \(0\).
Cette représentation rend visible la concentration. Elle ne transforme pas le résultat en tous les points sont dans la bande, ni en chaque ligne observée se rapproche sans jamais repartir. Une simulation illustre le théorème ; elle ne le démontre pas.
Une application complète, puis ce que le théorème ne dit pas
Exemple de référence 6.11 — Des délais individuels variables, une moyenne contrôlée
Un dispositif pédagogique numérique ajoute un délai de \(4\) ou \(8\) unités avec probabilités \(1/2\) et \(1/2\). Les appels sont modélisés par des répétitions indépendantes de cette même loi finie. Pour un délai \(X\), \[\mu=\operatorname{E}(X)=4\times\frac12+8\times\frac12=2+4=6,\] \[V=\operatorname{V}(X)=(4-6)^2\times\frac12+(8-6)^2\times\frac12 =4\times\frac12+4\times\frac12=4.\] Fixons la tolérance \(\delta=0{,}5\). Pour la moyenne de \(n\) appels, \[\mathbb{P}(|M_n-6|\geq0{,}5) \leq\frac4{n(0{,}5)^2} =\frac4{0{,}25n} =\frac{16}{n}.\] Le nombre \(16\) reste fixe ; \(16/n\) tend vers \(0\). Par encadrement, le risque tend vers \(0\), et la probabilité de \(5{,}5<M_n<6{,}5\) tend vers \(1\).
Voici trois garanties finies obtenues avec la même tolérance : \[\begin{array}{c|ccc} n&100&400&1\,600\\ \hline 16/n&0{,}16&0{,}04&0{,}01\\ 1-16/n&0{,}84&0{,}96&0{,}99 \end{array}.\] La dernière ligne est un minorant de la probabilité intérieure, pas une liste de probabilités exactes.
Contre-exemple 6.12 — Un risque peut tendre vers zéro sans jamais s’annuler
Dans le modèle des délais \(4\) ou \(8\) équiprobables, pour chaque effectif fini \(n\), il est possible d’obtenir uniquement des \(4\). Par indépendance, cet événement a pour probabilité \((1/2)^n>0\). La moyenne vaut alors \(4\), à distance \(2\) de \(\mu=6\).
L’événement uniquement des \(8\) a lui aussi pour probabilité \((1/2)^n\) et donne une moyenne à distance \(2\). Ces deux événements sont disjoints, donc, pour la tolérance \(0{,}5\), \[\mathbb{P}(|M_n-6|\geq0{,}5) \geq2\left(\frac12\right)^n>0.\] Le risque peut donc tendre vers \(0\) tout en restant strictement positif pour chaque \(n\) fini. Très probable et certain ne sont pas synonymes.
Contre-exemple 6.13 — La moyenne observée ne se rapproche pas à chaque pas
Considérons des essais indépendants donnant \(0\) ou \(1\) avec la même probabilité. L’espérance individuelle vaut \(\mu=1/2\). Une suite possible de quatre résultats est \(1,0,1,1\), de probabilité \((1/2)^4=1/16>0\). \[\begin{array}{c|cccc} n&1&2&3&4\\ \hline m_n&1&1/2&2/3&3/4\\ |m_n-1/2|&1/2&0&1/6&1/4 \end{array}\] Au deuxième essai, la moyenne vaut exactement \(1/2\). Au troisième, elle s’en éloigne : \(2/3-1/2=(4-3)/6=1/6\). Au quatrième, l’écart devient \(3/4-1/2=(3-2)/4=1/4\), encore plus grand.
Cette trajectoire possible suffit à contredire un rapprochement obligatoire à chaque étape. Elle ne contredit pas la concentration des lois des moyennes lorsque l’effectif devient grand.
Lecture. Pour cette figure, les essais suivent une loi de Bernoulli de paramètre \(p=0{,}35\). La bande colorée est \([0{,}25;0{,}45]\), soit une tolérance de \(0{,}10\) autour de \(p\). Les courbes sont trois moyennes cumulées simulées ; elles peuvent traverser le centre et s’en éloigner provisoirement. Le théorème porte sur le risque d’un écart fixé lorsque la taille augmente, pas sur une décroissance de chaque courbe.
Contre-exemple 6.14 — Même le risque réel n’est pas nécessairement décroissant à chaque rang
Reprenons des essais \(0/1\) indépendants et équiprobables, avec \(\mu=1/2\), mais fixons maintenant \(\delta=0{,}1\).
Pour \(n=2\), les quatre suites équiprobables sont \(00\), \(01\), \(10\) et \(11\). Les moyennes sont \(0\), \(1/2\), \(1/2\) et \(1\). Deux suites sur quatre donnent un écart au moins égal à \(0{,}1\) : \[\mathbb{P}(|M_2-1/2|\geq0{,}1)=\frac24=\frac12.\] Pour \(n=3\), les moyennes possibles sont \(0\), \(1/3\), \(2/3\) et \(1\). Même les deux valeurs les plus proches de \(1/2\) sont à distance \[\frac12-\frac13=\frac{3-2}{6}=\frac16>0{,}1.\] Toutes les issues donnent donc un écart au moins égal à \(0{,}1\), et \[\mathbb{P}(|M_3-1/2|\geq0{,}1)=1.\] Le risque a augmenté entre ces deux rangs. Le théorème affirme une limite, pas une décroissance à chaque rang. Le majorant de concentration décroît, mais une quantité située sous un majorant décroissant peut elle-même connaître des hausses.
Contre-exemple 6.15 — Les essais suivants ne réparent pas les précédents
Dans des essais \(0/1\) indépendants et équiprobables, supposons que les trois premiers résultats soient \(000\). Le prochain résultat vaut toujours \(1\) avec probabilité \(1/2\).
On peut le vérifier par des probabilités conditionnelles, rappelées ici : pour un événement \(A\) de probabilité non nulle, la probabilité de \(B\) sachant \(A\) vaut \(\mathbb{P}(A\cap B)/\mathbb{P}(A)\). Ici \[\mathbb{P}(000)=\left(\frac12\right)^3=\frac18,\qquad \mathbb{P}(0001)=\left(\frac12\right)^4=\frac1{16}.\] Comme \(\mathbb{P}(000)=1/8>0\), \[\mathbb{P}(\text{prochain résultat }1\mid000) =\frac{1/16}{1/8} =\frac1{16}\times\frac81 =\frac12.\] Le diviseur \(1/8\) est non nul ; son inverse est \(8\). Les trois zéros n’ont pas rendu un \(1\) plus probable. La loi des grands nombres ne crée pas un mécanisme de rattrapage.
Remarque 6.16 — Ce n’est pas l’observation individuelle qui se rapproche
Dans le modèle \(0/1\) équiprobable, chaque observation \(X_n\) vaut toujours \(0\) ou \(1\), donc \[|X_n-1/2|=1/2\] à chaque essai. Les observations individuelles ne deviennent pas proches de \(1/2\). C’est leur moyenne, construite avec de plus en plus de termes, dont la loi se concentre.
Examiner les conditions au lieu de les réciter
Contre-exemple 6.17 — Sans indépendance, la conclusion peut échouer
On tire une seule variable \(Z\) qui vaut \(-1\) ou \(1\) avec probabilités \(1/2\) et \(1/2\), puis on pose \(X_1=X_2=\cdots=Z\). Toutes les variables ont la même loi, d’espérance \(0\) et de variance \(1\), mais elles ne sont pas indépendantes.
Pour chaque \(n\), la moyenne vaut \(M_n=nZ/n=Z\). Pour la tolérance fixe \(\delta=0{,}5\), \[\mathbb{P}(|M_n-0|\geq0{,}5)=1\] puisque \(|Z|=1\). Ce risque ne tend pas vers \(0\). Le défaut se situe avant l’encadrement : la variance de la moyenne vaut \(1\), et non \(1/n\). On ne peut donc pas utiliser la concentration sous sa forme d’échantillon indépendant.
Propriété 6.18 — Si la variance est nulle, la conclusion est immédiate
Si \(V=0\), alors \(X=\mu\) avec probabilité \(1\). En effet, dans \[0=\sum_j(x_j-\mu)^2q_j,\] tous les termes sont non négatifs ; pour chaque \(q_j>0\), on doit donc avoir \((x_j-\mu)^2=0\), puis \(x_j=\mu\).
Chaque moyenne \(M_n\) vaut alors \(\mu\) avec probabilité \(1\), et \(\mathbb{P}(|M_n-\mu|\geq\delta)=0\) pour tout \(\delta>0\). On n’a pas besoin d’attendre un grand effectif.
Attention. Avec \(\sigma=0\), le nombre \(k\sigma\) est nul. On ne l’utilise pas comme tolérance dans une formule exigeant \(\delta>0\) : on traite directement le cas nul comme ci-dessus.
Point de vigilance 6.19 — Une tolérance qui change avec \(n\) exige un nouvel examen
La preuve du théorème fixe \(\delta\) avant de faire tendre \(n\) vers l’infini. Si on choisit une nouvelle tolérance \(\delta_n=1/\sqrt n\), elle est positive, mais elle rétrécit avec \(n\). Le majorant devient \[\frac{V}{n\delta_n^2} =\frac{V}{n(1/\sqrt n)^2} =\frac{V}{n\times1/n}=V.\] On a utilisé \((\sqrt n)^2=n\), puisque \(n>0\). Le facteur \(n\) du dénominateur est compensé par le carré de la tolérance.
Si \(V>0\), cette borne constante ne tend pas vers \(0\). Conclusion correcte : cet encadrement ne démontre pas une limite nulle pour ce seuil mobile. Conclusion incorrecte : la probabilité ne tend donc pas vers \(0\). Une borne qui ne tend pas vers \(0\) ne suffit pas à décider : par exemple, \(0\leq1/n\leq1\) alors que \(1/n\) tend bien vers \(0\).
Avec \(\delta_n=1/n\), le majorant devient \(V/[n(1/n)^2]=Vn\) : ce changement de tolérance rend aussi la preuve précédente inopérante. Il faudrait une autre étude, non fournie par la seule loi des grands nombres à tolérance fixée.
Mettre le théorème en œuvre soi-même
Méthode 6.20 — Écrire une preuve de concentration asymptotique
Nommer la moyenne. Préciser les répétitions indépendantes, la loi finie commune, son espérance \(\mu\) et sa variance \(V\).
Fixer la tolérance. Écrire \(\delta>0\) et vérifier qu’elle ne dépend pas de \(n\).
Encadrer la probabilité. Le membre de gauche est \(0\) ; celui de droite est \(V/(n\delta^2)\).
Justifier la limite du majorant. Mettre en évidence la constante \(V/\delta^2\) multipliée par \(1/n\).
Conclure sur une probabilité. Citer l’encadrement, puis traduire si nécessaire le résultat pour l’événement contraire.
Un graphique encourage à conjecturer ; ces cinq gestes justifient le résultat.
À toi 6.21 — Une limite accompagnée d’un seuil
On moyenne \(n\) observations indépendantes d’une même loi finie, d’espérance \(3\) et de variance \(9\). On fixe \(\delta=0{,}3\).
Montre que le risque d’un écart au moins égal à \(0{,}3\) est au plus \(100/n\).
Déduis sa limite et celle de \(\mathbb{P}(2{,}7<M_n<3{,}3)\).
Propose un seuil d’effectif au-delà duquel le risque est garanti au plus égal à \(5\,\%\).
Indices. \((0{,}3)^2=0{,}09\). Le nombre \(9/0{,}09\) est fixe. Pour le seuil, résous \(100/n\leq0{,}05\) en tenant compte de \(n>0\).
Correction expliquée 6.22 — De l’encadrement à une phrase précise
Les hypothèses de la concentration sont réunies, donc \[0\leq\mathbb{P}(|M_n-3|\geq0{,}3) \leq\frac9{n(0{,}3)^2} =\frac9{0{,}09n} =\frac{100}{n}.\] La tolérance \(0{,}3\) ne change pas avec \(n\). Comme \(100/n\) tend vers \(0\), le théorème d’encadrement donne \[\mathbb{P}(|M_n-3|\geq0{,}3)\longrightarrow0.\] Le complément est \(|M_n-3|<0{,}3\), soit \(2{,}7<M_n<3{,}3\). Sa probabilité tend vers \(1\).
Pour la garantie à \(5\,\%\) : \[\frac{100}{n}\leq0{,}05 \iff100\leq0{,}05n \iff n\geq\frac{100}{0{,}05}=2\,000.\] On a multiplié par \(n>0\), puis divisé par \(0{,}05>0\). Pour chaque \(n\geq2\,000\), le risque est au plus \(0{,}05\) ; la probabilité intérieure est au moins \(0{,}95\). Cela ne signifie pas qu’aucune réalisation extérieure ne puisse se produire.
À toi 6.23 — À chercher avant la correction
Une observation \(X\) vaut \(-1\), \(1\) ou \(3\) avec probabilités \(1/4\), \(1/2\) et \(1/4\). On répète l’expérience indépendamment et on note \(M_n\) la moyenne.
Calcule l’espérance et la variance individuelles.
Étudie la limite de \(\mathbb{P}(|M_n-1|\geq0{,}25)\).
Trouve un effectif suffisant pour avoir \(\mathbb{P}(0{,}75<M_n<1{,}25)\geq0{,}99\).
Pour un effectif fini, la probabilité extérieure doit-elle être nulle ?
Indice 1. Reviens aux sommes pondérées pour les moments.
Indice 2. \(0{,}25=1/4\), donc son carré vaut \(1/16\).
Indice 3. Pour la dernière question, examine l’issue où toutes les observations valent \(-1\).
Correction expliquée 6.24 — Calcul, limite, seuil et portée
L’espérance vaut \[\mu=(-1)\times\frac14+1\times\frac12+3\times\frac14 =-\frac14+\frac24+\frac34=\frac44=1.\] Les écarts à \(1\) sont \(-2\), \(0\) et \(2\), donc \[V=(-2)^2\times\frac14+0^2\times\frac12+2^2\times\frac14 =4\times\frac14+0+4\times\frac14=2.\] Pour \(\delta=0{,}25=1/4\), fixé, \[0\leq\mathbb{P}(|M_n-1|\geq0{,}25) \leq\frac2{n(1/4)^2} =\frac2{n/16} =\frac{32}{n}.\] Le diviseur \(n/16\) est positif, et son inverse est \(16/n\). Comme \(32/n\) tend vers \(0\), le risque tend vers \(0\) par encadrement.
La réussite souhaitée est d’au moins \(0{,}99\), donc le risque demandé est au plus \(0{,}01\). Il suffit que \[\frac{32}{n}\leq0{,}01 \iff32\leq0{,}01n \iff n\geq3\,200.\] Les opérations sont autorisées par \(n>0\) et \(0{,}01>0\). \(3\,200\) est donc un effectif suffisant.
Pour tout \(n\) fini, obtenir uniquement des \(-1\) a pour probabilité \((1/4)^n>0\). La moyenne vaut alors \(-1\), à distance \(2\) de l’espérance \(1\). Le risque extérieur n’est donc pas nul : le théorème annonce sa limite, pas son annulation à un rang fini.
À toi 6.25 — Dire exactement ce que démontre l’encadrement
Rédige en quelques phrases la démonstration de la loi des grands nombres dans le cadre fini. Ta rédaction doit expliquer pourquoi le majorant tend vers \(0\) et nommer la quantité dont on obtient la limite.
Correction expliquée 6.26 — Une réponse possible et ses critères
Les observations sont indépendantes et de même loi finie, de variance \(V\). Je fixe \(\delta>0\), indépendant de \(n\). La concentration donne \[0\leq\mathbb{P}(|M_n-\mu|\geq\delta) \leq\frac{V}{\delta^2}\times\frac1n.\] Comme \(V/\delta^2\) est une constante et \(1/n\) tend vers \(0\), le majorant tend vers \(0\). Par le théorème d’encadrement, la probabilité d’un écart au moins égal à \(\delta\) tend vers \(0\).
Critères de contenu. Il faut les hypothèses du modèle, la tolérance fixe, les deux bornes, la limite du majorant et une conclusion portant sur la probabilité. Les résultats se compensent ou on le voit sur la courbe ne remplace pas cette démonstration.
À toi 6.27 — Ce qui est fixé et ce qui ne l’est plus
Deux élèves considèrent le même modèle de répétitions indépendantes, avec \(V=2\). Le premier garde une tolérance égale à \(0{,}2\). Le second choisit la tolérance \(1/\sqrt n\) à la taille \(n\).
Écris le majorant de concentration de chacun.
Pour lequel la preuve par encadrement démontre-t-elle une limite nulle ?
Pour l’autre, que peux-tu conclure, et que ne peux-tu pas conclure ?
Correction expliquée 6.28 — Une constante cachée dans la preuve
Pour la tolérance fixe \(0{,}2\), le majorant vaut \[\frac2{n(0{,}2)^2} =\frac2{0{,}04n} =\frac{50}{n},\] qui tend vers \(0\). L’encadrement donne donc une limite nulle pour le risque correspondant.
Pour la tolérance \(1/\sqrt n\), le majorant vaut \[\frac2{n(1/\sqrt n)^2} =\frac2{n\times1/n}=2.\] Il dépasse même \(1\) ; la borne utile reste donc seulement \(1\). Cette preuve ne conclut pas à une limite nulle. Elle ne démontre pas non plus l’absence de limite nulle : un encadrement trop large ne tranche pas la question.
Réparer le passage abusif de petit à nul
Point de vigilance 6.29 — Une conclusion plus forte que l’inégalité
Emma a obtenu \(r_n\leq2/n\) et écrit : À partir de \(n=100\), il n’y a plus d’erreur. Or \(2/100=0{,}02\), pas \(0\). Une borne de \(2\,\%\) ne prouve pas l’impossibilité de l’événement.
Rappel 6.30 — Ne pas changer de quantificateur
Une probabilité au plus égale à un petit nombre reste compatible avec des échecs. Si \(0\leq r_n\leq b_n\), on sait seulement que la probabilité de réussite est au moins \(1-b_n\). Si \(b_n\to0\), cette garantie tend vers \(1\) ; cela ne donne pas \(b_n=0\) pour un effectif fini.
Exemple de référence 6.31 — Une borne petite et un risque réellement non nul
Quatre observations indépendantes valent chacune \(-1\) ou \(1\) avec probabilités \(1/2\) et \(1/2\). Leur espérance est \(0\) et leur variance individuelle \(1\). Pour la tolérance \(\delta=1\), la concentration donne \[\mathbb{P}(|M_4|\geq1)\leq\frac1{4\times1^2}=\frac14.\] La moyenne atteint \(1\) uniquement si les quatre valeurs sont \(1\), et atteint \(-1\) uniquement si elles sont toutes \(-1\). Ces deux issues ont chacune probabilité \((1/2)^4=1/16\), donc le risque exact est \[\frac1{16}+\frac1{16}=\frac18.\] Il est bien inférieur à \(1/4\), mais il n’est pas nul. Voilà une situation réelle où majoré ne signifie pas impossible.
À toi 6.32 — Nouvel essai, puis retour à la phrase d’Emma
Une autre situation donne un risque \(r_n\) vérifiant \(0\leq r_n\leq3/n\). Que peux-tu affirmer à \(n=300\) sur le risque et la réussite ? Réécris ensuite correctement la phrase d’Emma, qui disposait de \(r_n\leq2/n\) à \(n=100\).
Indice. Calcule le majorant puis son complément ; ne remplace ni l’un ni l’autre par une valeur idéale.
Correction expliquée 6.33 — La conclusion corrigée
À \(n=300\), on a \(r_{300}\leq3/300=0{,}01\). Le risque est donc au plus \(1\,\%\) et la réussite au moins \(1-0{,}01=0{,}99\), soit \(99\,\%\).
Pour Emma, \(r_{100}\leq2/100=0{,}02\). Une phrase correcte est : À partir de \(100\) observations, la borne garantit un risque au plus égal à \(2\,\%\), donc une probabilité de réussite au moins égale à \(98\,\%\). Le à partir de se justifie car \(2/n\leq2/100\) pour \(n\geq100\). Il ne transforme pas la réussite en certitude.
À reprendre plus tard avant toute relecture
À toi 6.34 — Retrouver la preuve et son interprétation
Lors d’une prochaine séance, repars d’une feuille vide. Des variables finies indépendantes de même loi ont pour espérance \(40\) et pour variance \(25\) ; \(M_n\) est leur moyenne.
Étudie la probabilité que \(M_n\) soit à distance au moins \(0{,}5\) de \(40\) quand \(n\) augmente.
Donne une garantie numérique pour \(n=2\,000\), puis pour \(n=4\,000\).
Explique pourquoi ces garanties ne démontrent ni l’annulation du risque ni sa décroissance à chaque rang.
Aide de reprise. Écris \(0\leq\text{risque}\leq25/[n(0{,}5)^2]\), puis identifie la constante qui multiplie \(1/n\).
Correction expliquée 6.35 — Correction locale de la reprise
Puisque \(\delta=0{,}5\) est fixe et que les hypothèses de l’échantillon sont satisfaites, \[0\leq\mathbb{P}(|M_n-40|\geq0{,}5) \leq\frac{25}{n(0{,}5)^2} =\frac{25}{0{,}25n} =\frac{100}{n}.\] Le majorant tend vers \(0\) ; par encadrement, le risque tend vers \(0\). Par complément, \(\mathbb{P}(39{,}5<M_n<40{,}5)\) tend vers \(1\).
Pour \(n=2\,000\), le majorant vaut \(100/2\,000=0{,}05\) : la probabilité intérieure est au moins \(0{,}95\). Pour \(n=4\,000\), le majorant vaut \(100/4\,000=0{,}025\) : la probabilité intérieure est au moins \(0{,}975\).
Ces nombres sont des bornes, et ils sont positifs. Ils ne démontrent donc pas un risque nul. Leur décroissance ne force pas le risque réel à décroître à chaque rang : seule la convergence vers \(0\) est obtenue par cet encadrement.
Synthèse 6.36 — La phrase à savoir expliquer
Pour des répétitions indépendantes d’une même loi finie, la probabilité que la moyenne s’écarte de l’espérance d’au moins une tolérance positive fixée tend vers zéro lorsque le nombre d’observations augmente.
La preuve utilise \(\operatorname{V}(M_n)=V/n\), la concentration et l’encadrement. Elle n’annonce ni compensation imposée du passé, ni rapprochement monotone, ni égalité finale certaine avec l’espérance. Une tolérance qui dépend de \(n\) exige de reprendre le calcul, au lieu de réutiliser le théorème sans vérifier sa portée.
7. Fréquences et événements : choisir la bonne variable
Objectif. Transformer la réalisation d’un événement en une variable de Bernoulli, puis choisir la variance qui convient pour contrôler une fréquence.
Se repérer avant de calculer
Rappel 7.1 — Les outils nécessaires dans cette unité
Une variable aléatoire finie associe un nombre à chaque résultat d’une expérience. Si ses valeurs sont \(x_1,\ldots,x_r\), de probabilités \(q_1,\ldots,q_r\), alors \[\operatorname{E}(X)=x_1q_1+\cdots+x_rq_r,\qquad \operatorname{V}(X)=(x_1-\operatorname{E}(X))^2q_1+\cdots+(x_r-\operatorname{E}(X))^2q_r.\] L’espérance est une moyenne théorique pondérée ; la variance mesure la dispersion autour de cette moyenne. Pour des variables indépendantes, les variances s’ajoutent. Pour un réel \(c\), \(\operatorname{V}(cX)=c^2\operatorname{V}(X)\). L’additivité des variances sous indépendance est un résultat antérieur, admis à ce niveau.
Une fréquence observée se calcule en divisant le nombre de réalisations de l’événement par le nombre total d’essais. Le dénominateur est donc un entier strictement positif. La probabilité est un nombre fixé par le modèle ; la fréquence dépend des résultats obtenus.
À toi 7.2 — Un premier choix à faire
Huit lots ont été examinés. Les nombres de défauts relevés sont \[1\ ;\ 0\ ;\ 3\ ;\ 1\ ;\ 2\ ;\ 0\ ;\ 2\ ;\ 1.\] Sans regarder la réponse, calcule :
le nombre moyen de défauts par lot ;
la fréquence des lots qui contiennent au moins deux défauts.
Explique pourquoi les deux questions ne portent pas sur la même quantité.
Correction expliquée 7.3 — Une moyenne de nombres ou une proportion de lots ?
Le nombre total de défauts est \(1+0+3+1+2+0+2+1=10\). Le nombre moyen est donc \(10/8=1{,}25\) défaut par lot.
Pour la seconde question, un lot est compté une seule fois dès qu’il possède au moins deux défauts. Ce sont les troisième, cinquième et septième lots : la fréquence vaut \(3/8=0{,}375\), soit \(37{,}5\,\%\).
Si tu as répondu \(10/8\) à la seconde question, il faut remplacer le nombre de défauts par un code \(0\) ou \(1\) indiquant si le lot possède la propriété recherchée. C’est précisément la construction qui suit. Une fréquence reste entre \(0\) et \(1\) ; une moyenne de nombres de défauts peut dépasser \(1\).
Coder la réalisation d’un événement
Définition 7.4 — Variable de Bernoulli associée à un événement
Soit \(A\) un événement de probabilité \(p\), avec \(0\leq p\leq1\). On définit une variable \(Y\) ainsi : \[Y=\begin{cases} 1&\text{si l'événement $A$ se réalise},\\ 0&\text{si l'événement $A$ ne se réalise pas}. \end{cases}\] Alors \(\mathbb{P}(Y=1)=p\) et \(\mathbb{P}(Y=0)=1-p\). Cette loi est appelée loi de Bernoulli de paramètre \(p\). Le mot indicatrice signifie que la variable indique la réalisation de \(A\) ; aucune notation supplémentaire n’est nécessaire pour l’utiliser.
Un succès est seulement le nom donné à l’événement choisi : il peut s’agir d’un défaut, d’une panne ou d’un échec scolaire. Le sens courant du mot ne change pas la définition mathématique.
Propriété 7.5 — Espérance et variance d’une variable de Bernoulli
Si \(Y\) suit une loi de Bernoulli de paramètre \(p\in[0;1]\), alors \[\operatorname{E}(Y)=p,\qquad \operatorname{V}(Y)=p(1-p).\]
Démonstration. Les deux valeurs possibles sont \(0\) et \(1\). La moyenne pondérée vaut \[\operatorname{E}(Y)=0\times(1-p)+1\times p=0+p=p.\] En utilisant cette valeur dans la définition de la variance, on obtient \[\begin{aligned} \operatorname{V}(Y) &=(0-p)^2(1-p)+(1-p)^2p\\ &=p^2(1-p)+p(1-p)(1-p)\\ &=p(1-p)\times p+p(1-p)\times(1-p)\\ &=p(1-p)\bigl[p+(1-p)\bigr]\\ &=p(1-p)\times1=p(1-p). \end{aligned}\] La factorisation rassemble deux termes ayant le facteur commun \(p(1-p)\) ; elle n’exige aucune division par \(p\) ni par \(1-p\). La démonstration reste donc valable pour \(p=0\) et \(p=1\). Dans ces deux cas, la variable est constante avec probabilité \(1\), et sa variance est nulle.
Intuition et représentation 7.6 — Un compteur qui enregistre seulement « oui » ou « non »
Pour connaître la proportion de lots ayant au moins deux défauts, imagine un compteur : il avance d’une unité si le lot répond à la condition, et reste immobile sinon. Un lot contenant cinq défauts fait avancer ce compteur d’une unité, pas de cinq.
La correspondance est exacte : \(Y=1\) représente une avance, \(Y=0\) l’absence d’avance. Cette image aide à choisir ce qu’il faut compter. Elle ne démontre ni l’indépendance des lots ni la valeur de leur probabilité \(p\) : ces hypothèses viennent du modèle.
Lecture. Une expérience peut produire un nombre \(K\). Le test d’une condition sur \(K\) produit ensuite un code \(Y\) égal à \(0\) ou \(1\). Additionner ces codes compte les réalisations de l’événement ; diviser cette somme par le nombre d’essais donne leur fréquence, et non la moyenne des valeurs de \(K\).
Définition 7.7 — Nombre de réalisations et fréquence aléatoire
On répète une expérience \(n\geq1\) fois, indépendamment et dans les mêmes conditions. L’événement choisi a la même probabilité \(p\) à chaque essai. Pour \(i\) allant de \(1\) à \(n\), on note \(Y_i\) le code \(0\) ou \(1\) de sa réalisation au \(i\)-ième essai.
Le nombre de réalisations et la fréquence sont respectivement \[S_n=Y_1+\cdots+Y_n,\qquad F_n=\frac{S_n}{n}.\] Les \(Y_i\) sont indépendantes et de même loi de Bernoulli. La variable \(S_n\) prend des valeurs entières de \(0\) à \(n\) ; \(F_n\) prend des valeurs parmi \(0,1/n,2/n,\ldots,1\). Après l’expérience, les nombres effectivement obtenus sont une réalisation de \(S_n\) et une réalisation de \(F_n\).
Propriété 7.8 — Les moments d’une fréquence
Sous les hypothèses de répétitions indépendantes de même probabilité \(p\), \[\operatorname{E}(F_n)=p,\qquad \operatorname{V}(F_n)=\frac{p(1-p)}n.\]
Démonstration. Chaque \(Y_i\) a pour espérance \(p\) et pour variance \(p(1-p)\). La linéarité de l’espérance donne \[\operatorname{E}(S_n)=\underbrace{p+\cdots+p}_{n\text{ termes}}=np, \qquad \operatorname{E}(F_n)=\frac1n\operatorname{E}(S_n)=\frac{np}{n}=p.\] L’indépendance permet d’ajouter les variances : \(\operatorname{V}(S_n)=np(1-p)\). La multiplication par \(1/n\) impose le carré de ce coefficient dans la variance : \[\operatorname{V}(F_n)=\left(\frac1n\right)^2\operatorname{V}(S_n) =\frac{np(1-p)}{n\times n} =\frac{p(1-p)}n.\] La simplification par \(n\) est autorisée car \(n\geq1\). C’est la variance de la fréquence qui diminue avec \(n\), pas celle du compte \(S_n\).
Théorème 7.9 — Concentration d’une fréquence et loi des grands nombres
Pour \(n\) essais indépendants de même probabilité de succès \(p\), notons \(F_n\) la fréquence des succès. Pour tout \(\delta>0\), \[\mathbb{P}(|F_n-p|\geq\delta)\leq\frac{p(1-p)}{n\delta^2}, \qquad \mathbb{P}(|F_n-p|<\delta)\geq1-\frac{p(1-p)}{n\delta^2}.\] Si les répétitions se poursuivent et si \(\delta>0\) est fixé, alors \[\lim_{n\to+\infty}\mathbb{P}(|F_n-p|\geq\delta)=0.\]
Démonstration. L’inégalité de Bienaymé–Tchebychev affirme que, pour une variable finie \(Z\) et un seuil \(\delta>0\), \[\mathbb{P}(|Z-\operatorname{E}(Z)|\geq\delta)\leq\frac{\operatorname{V}(Z)}{\delta^2}.\] On l’applique à \(Z=F_n\), dont l’espérance est \(p\) et la variance \(p(1-p)/n\). Cela donne la première borne. Le contraire de \(|F_n-p|\geq\delta\) est \(|F_n-p|<\delta\) ; soustraire la majoration à \(1\) donne la minoration intérieure.
Enfin, \(p(1-p)/\delta^2\) est une constante positive ou nulle lorsque \(p\) et \(\delta\) sont fixés. Donc \[0\leq\mathbb{P}(|F_n-p|\geq\delta) \leq\frac{p(1-p)}{\delta^2}\times\frac1n\longrightarrow0.\] Le théorème d’encadrement des suites donne la limite annoncée. Il s’agit d’une limite de probabilités, pas de l’affirmation qu’une fréquence observée se rapproche de \(p\) à chaque nouvel essai.
Propriété 7.10 — Une variance bornée même si la probabilité est inconnue
Pour \(0\leq p\leq1\), on a \(0\leq p(1-p)\leq1/4\).
Démonstration. Les facteurs \(p\) et \(1-p\) sont positifs ou nuls, donc leur produit aussi. Pour le majorer, développons réellement le carré : \[\begin{aligned} \left(p-\frac12\right)^2 &=p\times p+p\times\left(-\frac12\right) +\left(-\frac12\right)\times p +\left(-\frac12\right)\times\left(-\frac12\right)\\ &=p^2-\frac p2-\frac p2+\frac14\\ &=p^2-p+\frac14. \end{aligned}\] On en déduit, en distribuant le signe moins : \[\frac14-\left(p-\frac12\right)^2 =\frac14-p^2+p-\frac14 =p-p^2=p(1-p).\] Un carré est positif ou nul ; lui soustraire à \(1/4\) donne un nombre au plus égal à \(1/4\). L’égalité se produit exactement lorsque \(p-1/2=0\), donc lorsque \(p=1/2\). Utilité. Pour une fréquence \(F_n\) de \(n\) essais indépendants de même probabilité \(p\), la concentration donne ainsi, pour \(\delta>0\), \[\mathbb{P}(|F_n-p|\geq\delta)\leq\frac{p(1-p)}{n\delta^2} \leq\frac1{4n\delta^2}.\] La seconde borne n’exige pas la valeur de \(p\) ; elle n’autorise pas à affirmer que \(p=1/2\).
Remarque 7.11 — Ce que signifie « sans connaître \(p\) »
La borne \(1/(4n\delta^2)\) convient à toutes les valeurs de \(p\) de l’intervalle \([0;1]\). On l’utilise lorsque la probabilité est inconnue ou lorsqu’on veut une garantie commune à tous les modèles de Bernoulli.
Elle ne signifie pas que les événements sont équiprobables. Elle est parfois moins précise que \(p(1-p)/(n\delta^2)\) lorsque \(p\) est connu. Si un majorant dépasse \(1\), on sait seulement que la probabilité est au plus \(1\) : la formule ne produit pas une probabilité supérieure à \(100\,\%\).
Une méthode de choix, puis un exemple complet
Méthode 7.12 — Choisir la variable avant de choisir une formule
Je vois une question qui demande la proportion d’essais répondant à une condition.
Je pense : pour chaque essai, la réponse à cette condition est oui ou non. Le nombre brut éventuellement mesuré n’est pas encore la bonne variable.
Je fais :
Je nomme l’événement \(A\) et je définis \(Y=1\) si \(A\) se réalise, \(Y=0\) sinon.
Je calcule \(p=\mathbb{P}(A)\) si les données le permettent ; sinon je conserve \(p\) inconnu.
Je vérifie que les essais entiers sont indépendants et que la probabilité \(p\) ne change pas.
Je définis \(F_n=(Y_1+\cdots+Y_n)/n\) et j’utilise \(\operatorname{V}(Y)=p(1-p)\), ou le majorant \(1/4\).
Je traduis la demande avec un seuil \(\delta>0\) ; je calcule la borne et j’interprète une garantie, non une probabilité exacte.
Contrôle. La fréquence et \(p\) sont entre \(0\) et \(1\). Un écart de \(0{,}05\) représente cinq points de pourcentage, pas nécessairement une erreur relative de \(5\,\%\).
Exemple de référence 7.13 — Une réussite définie par plusieurs résultats
Un petit programme produit une séquence de quatre symboles. Chaque symbole vaut \(0\) ou \(1\) avec probabilité \(1/2\), indépendamment des autres. On déclare la séquence gagnante si elle contient exactement deux symboles \(1\). On produit \(1\,500\) séquences indépendantes selon ce même modèle. Comment majorer le risque que la fréquence des séquences gagnantes s’écarte de sa probabilité de \(0{,}05\) ou davantage ?
1. Deux variables différentes. Pour une séquence, \(K\) désigne le nombre de symboles \(1\). Mais la question finale concerne le fait d’être gagnante : on définit donc \(Y=1\) si \(K=2\), et \(Y=0\) sinon.
2. La probabilité de gagner. Les positions des deux symboles \(1\) sont \[\{1,2\},\ \{1,3\},\ \{1,4\},\ \{2,3\},\ \{2,4\},\ \{3,4\}.\] Ces six cas sont distincts. Chaque séquence particulière a pour probabilité \((1/2)^4=1/16\). On additionne les six probabilités : \[p=6\times\frac1{16}=\frac6{16}=\frac38.\] 3. La bonne variance. La variable \(Y\) est de Bernoulli de paramètre \(3/8\), donc \[\operatorname{V}(Y)=\frac38\left(1-\frac38\right) =\frac38\times\frac58=\frac{15}{64}.\] Notons \(F_{1500}\) la fréquence des séquences gagnantes. La tolérance est \(\delta=0{,}05=1/20\). La concentration donne \[\begin{aligned} \mathbb{P}\left(\left|F_{1500}-\frac38\right|\geq\frac1{20}\right) &\leq\frac{15/64}{1500\times(1/20)^2}\\ &=\frac{15/64}{1500/400} =\frac{15/64}{15/4} =\frac{15}{64}\times\frac4{15} =\frac1{16}. \end{aligned}\] Le diviseur \(15/4\) est strictement positif ; diviser par cette fraction revient à multiplier par \(4/15\). Le risque est donc au plus \(6{,}25\,\%\).
4. Vérifier l’interprétation. Puisque \(3/8=0{,}375\), le complément donne \[\mathbb{P}(0{,}325<F_{1500}<0{,}425)\geq\frac{15}{16}=0{,}9375.\] Ce n’est pas une annonce du résultat de la prochaine simulation. Si elle donne \(600\) séquences gagnantes, sa fréquence est \(600/1500=0{,}4\) et son écart observé vaut \(0{,}4-0{,}375=0{,}025\) : cette simulation particulière se trouve dans la bande.
Une garantie sans le calcul de \(p\). La borne universelle aurait donné \[\frac1{4\times1500\times(1/20)^2} =\frac1{15}\approx0{,}0667.\] Elle est un peu moins fine, mais demeure valable. La variance de \(K\), égale à \(4\times(1/2)\times(1/2)=1\), n’est pas la variance de l’indicatrice \(Y\) à introduire dans la formule pour cette fréquence.
S’entraîner avec une aide, puis choisir seul
À toi 7.14 — Un dispositif à deux essais
Un dispositif effectue deux essais indépendants. Chacun réussit avec probabilité \(1/4\). Le dispositif est déclaré utilisable si au moins un essai réussit. On examine \(630\) dispositifs indépendants de même fonctionnement.
Définis une variable \(Y\) qui permet de compter les dispositifs utilisables.
Calcule \(p=\mathbb{P}(Y=1)\) en considérant d’abord le cas où les deux essais échouent.
Calcule \(\operatorname{V}(Y)\), puis majore le risque que la fréquence \(F_{630}\) s’écarte de \(p\) d’au moins \(1/8\).
Indice, après une tentative. L’événement contraire de « au moins un succès » est « aucun succès ». Le code \(Y\) ne vaut jamais \(2\), même si les deux essais réussissent.
Correction expliquée 7.15 — Compter les dispositifs et non leurs succès
On pose \(Y=1\) si le dispositif est utilisable et \(Y=0\) sinon. Un essai échoue avec probabilité \(1-1/4=3/4\). Par indépendance des deux essais, la probabilité que les deux échouent est \((3/4)\times(3/4)=9/16\). Ainsi, \[p=1-\frac9{16}=\frac{16}{16}-\frac9{16}=\frac7{16}, \qquad \operatorname{V}(Y)=\frac7{16}\left(1-\frac7{16}\right)=\frac7{16}\times\frac9{16}=\frac{63}{256}.\] Les dispositifs sont indépendants et de même fonctionnement. Pour leur fréquence et le seuil positif \(1/8\), \[\begin{aligned} \mathbb{P}\left(\left|F_{630}-\frac7{16}\right|\geq\frac18\right) &\leq\frac{63/256}{630\times(1/8)^2} =\frac{63/256}{630/64}\\ &=\frac{63}{256}\times\frac{64}{630} =\frac{63}{4\times630}=\frac1{40}=0{,}025. \end{aligned}\] Le risque est au plus \(2{,}5\,\%\). Pour obtenir un point de contrôle, les deux extrémités de la bande sont \(7/16-1/8=5/16\) et \(7/16+1/8=9/16\) ; la probabilité d’être strictement entre elles est au moins \(39/40\).
À toi 7.16 — À résoudre avant de consulter
On choisit \(600\) fois un chiffre parmi \(0,1,\ldots,9\), de manière uniforme et indépendante à chaque choix. On s’intéresse à la proportion de chiffres multiples de \(3\).
Définis les variables nécessaires et trouve la probabilité de l’événement étudié.
Propose une garantie sur le risque que la proportion obtenue s’écarte de cette probabilité de \(0{,}1\) ou davantage.
Que devient cette garantie si l’on ne connaît pas la probabilité, mais qu’on conserve des essais indépendants de même probabilité ?
Écris une phrase indiquant pourquoi le numéro du chiffre lui-même n’est pas la variable à moyenner ici.
Remarque 7.17 — Indices à ouvrir seulement après avoir cherché
Les multiples de \(3\) présents sont \(0,3,6,9\) ; \(0=3\times0\) est bien un multiple de \(3\). Pour chaque choix, code l’appartenance à cette liste par \(1\) et son absence par \(0\). Le dénominateur de concentration sera \(600\times0{,}1^2=6\).
Correction expliquée 7.18 — Choisir un événement parmi dix issues
On définit \(Y_i=1\) si le \(i\)-ième chiffre est dans la liste \(0,3,6,9\), et \(Y_i=0\) sinon. Il y a quatre chiffres favorables sur dix équiprobables, donc \(p=4/10=2/5=0{,}4\). Les \(Y_i\) sont indépendantes de même loi de Bernoulli.
La fréquence est \(F_{600}=(Y_1+\cdots+Y_{600})/600\). La variance d’une variable individuelle vaut \[p(1-p)=\frac25\times\frac35=\frac6{25}=0{,}24.\] Pour \(\delta=0{,}1>0\), la concentration fournit \[\mathbb{P}(|F_{600}-0{,}4|\geq0{,}1) \leq\frac{0{,}24}{600\times0{,}01} =\frac{0{,}24}{6}=0{,}04.\] Le risque est au plus \(4\,\%\). Si \(p\) est inconnu, on utilise \(p(1-p)\leq1/4\) et l’on obtient la garantie commune \[\mathbb{P}(|F_{600}-p|\geq0{,}1)\leq\frac1{4\times600\times0{,}01}=\frac1{24}\approx0{,}0417.\] Moyenner les chiffres produirait leur valeur moyenne ; cela ne compterait pas les choix qui sont multiples de \(3\).
Critères de réussite. La définition \(0/1\), les quatre issues favorables, les hypothèses de répétition, le carré de \(0{,}1\) et le mot « au plus » doivent apparaître. Une formule seule sans variable identifiée ne suffit pas.
Justifier, varier et réparer
Question que tu peux te poser 7.19 — Pourquoi ne pas conserver la variable de comptage initiale ?
Un programme simule \(n\) connexions, avec au plus cinq tentatives par connexion. Pour chacune, \(K_i\) est le nombre de tentatives effectivement réalisées ; une connexion qui réussit s’arrête aussitôt, les autres s’arrêtent à la cinquième tentative. Il renvoie ensuite la proportion de connexions réussies en trois tentatives ou moins. Explique quelle variable fournit la variance à utiliser pour cette proportion.
Réponse possible. Je définis \(Y_i=1\) si \(K_i\leq3\), et \(Y_i=0\) sinon. Si les connexions sont indépendantes et de même loi, les \(Y_i\) sont indépendantes de Bernoulli de paramètre \(p=\mathbb{P}(K_i\leq3)\). La proportion renvoyée est leur moyenne ; sa variance vaut donc \(p(1-p)/n\). La variance des nombres \(K_i\) répondrait à une question sur le nombre moyen de tentatives.
Critères. La réponse doit nommer l’événement, définir les deux valeurs de \(Y_i\), distinguer les deux moyennes et mentionner les hypothèses. Il n’est pas nécessaire de calculer \(p\) si la loi de \(K_i\) n’est pas fournie.
À toi 7.20 — Changer la question, sans changer les données
On dispose des mêmes résultats \(K_1,\ldots,K_n\).
Pour étudier le nombre moyen de tentatives, que faut-il moyenner ?
Pour étudier la proportion de connexions demandant plus de trois tentatives, quel code faut-il moyenner ?
Si toutes les connexions d’une série subissent la même panne commune, peut-on appliquer automatiquement la concentration avec le facteur \(1/n\) ?
Correction expliquée 7.21 — La variable dépend de ce que l’on cherche
Pour le nombre moyen, on utilise \((K_1+\cdots+K_n)/n\) : les valeurs \(K_i\) conservent leur grandeur. Pour la proportion, on utilise \(Z_i=1\) si \(K_i>3\) et \(Z_i=0\) sinon, puis \((Z_1+\cdots+Z_n)/n\). Une panne commune peut créer de la dépendance ; les mots « plusieurs connexions » ne suffisent donc pas à garantir l’indépendance. Sans justification du modèle, l’addition des variances utilisée pour obtenir \(\operatorname{V}(M_n)=V/n\) n’est pas disponible.
Point de vigilance 7.22 — Une erreur qui change la question
On observe les nombres de défauts \(0,2,1,3,2\). Pour la fréquence des lots ayant au moins deux défauts, un élève propose \[\frac{0+2+1+3+2}{5}=\frac85.\] Première erreur. Il a additionné les défauts, pas les lots répondant à la condition. Le résultat dépasse \(1\) : c’est un signal immédiat d’incohérence pour une fréquence.
Rappel utile. Pour compter des essais répondant à une condition, chaque essai apporte \(1\) ou \(0\), jamais son nombre brut de défauts.
Exemple plus simple corrigé. Avec deux lots de nombres \(0\) et \(2\), les codes sont \(0\) et \(1\). Un lot sur deux convient : la fréquence est \((0+1)/2=1/2\), tandis que le nombre moyen de défauts serait \((0+2)/2=1\).
Nouvel essai, avant la réponse. Pour les quatre nombres \(1,3,0,2\), écris les quatre codes et calcule la fréquence.
Correction du nouvel essai. Les codes sont \(0,1,0,1\). La fréquence vaut \((0+1+0+1)/4=2/4=1/2\). Le nombre moyen de défauts, autre question, serait \(6/4=1{,}5\).
Retour à l’erreur initiale. Les codes des cinq lots sont \(0,1,0,1,1\). La bonne fréquence est \(3/5=0{,}6\). Il faut donc construire les codes avant d’additionner, aussi bien à la main que dans un programme.
Une reprise à faire plus tard
À toi 7.23 — Demain ou dans quelques jours, avant toute relecture
Chaque contrôle comporte deux tests indépendants. Chaque test est validé avec probabilité \(2/3\). Le contrôle est accepté uniquement si les deux tests sont validés. On répète \(500\) contrôles indépendants selon ce même modèle.
Définis la fréquence des contrôles acceptés, calcule sa probabilité théorique de référence et majore le risque d’un écart d’au moins \(0{,}1\). Compare à la borne qui ne nécessite pas de connaître cette probabilité.
Aide après une tentative. Pour une proportion de contrôles acceptés, le code vaut \(1\) lorsque les deux tests sont validés, et \(0\) dans les autres cas. Les deux tests d’un contrôle et les différents contrôles ont chacun leur hypothèse d’indépendance.
Correction expliquée 7.24 — Deux niveaux à ne pas confondre
Pour le \(i\)-ième contrôle, posons \(Y_i=1\) s’il est accepté et \(Y_i=0\) sinon. L’indépendance des deux tests donne \[p=\frac23\times\frac23=\frac49, \qquad \operatorname{V}(Y_i)=\frac49\left(1-\frac49\right)=\frac49\times\frac59=\frac{20}{81}.\] L’indépendance des contrôles autorise la concentration de \(F_{500}=(Y_1+\cdots+Y_{500})/500\) : \[\mathbb{P}\left(\left|F_{500}-\frac49\right|\geq0{,}1\right) \leq\frac{20/81}{500\times0{,}01} =\frac{20/81}{5}=\frac{20}{81}\times\frac15=\frac4{81}\approx0{,}0494.\] La borne universelle serait \(1/(4\times500\times0{,}01)=1/20=0{,}05\). Les deux donnent un risque au plus égal à \(5\,\%\), mais la première utilise la probabilité connue et est légèrement plus fine.
Pour te situer. Si le code est faux, reprends le petit exemple à deux lots de cette unité. Si le code est juste mais la variance fausse, repars du tableau \(0/1\) et des calculs de la propriété de Bernoulli. Si seule la fin est fausse, recalcule d’abord \(500\times0{,}1^2\) avant toute division. Tu peux ensuite refaire cette tâche sans regarder la correction ; cela ne préjuge pas encore de ta réussite différée.
Synthèse 7.25 — Ce que tu dois pouvoir faire
Pour une question de fréquence, tu dois pouvoir nommer l’événement, construire son code \(0/1\), expliquer pourquoi sa variance est \(p(1-p)\) et utiliser, sous indépendance et même probabilité, \[\mathbb{P}(|F_n-p|\geq\delta)\leq\frac{p(1-p)}{n\delta^2} \leq\frac1{4n\delta^2}\qquad(n\geq1,\ \delta>0).\] Le compte mesure combien, la fréquence mesure quelle proportion. La loi des grands nombres justifie que, pour une tolérance fixée, les grands écarts de fréquence deviennent peu probables ; elle ne transforme pas une fréquence observée en une probabilité exacte.
8. Calcul binomial exact et comparaison des garanties
Objectif. Choisir entre calcul d’une probabilité et majoration, traiter correctement les bornes entières et distinguer minimum réel et seuil suffisant.
Avant de calculer : quel objet compte-t-on ?
Dans cette unité, on répète \(n\geq1\) épreuves de Bernoulli indépendantes, de même probabilité de succès \(p\). La variable \(S_n\) compte les succès et la fréquence est \(F_n=S_n/n\). Une probabilité exacte désigne ici celle du modèle binomial, par opposition à un majorant universel ; son affichage décimal par un outil peut néanmoins être arrondi.
À toi 8.1 — Repérage : le signe et le caractère entier
Un nombre de succès \(K\) est entier. Traduire \(K<7\), puis \(|K-10|>3\), sans valeur absolue. Tester ensuite \(K=7\) dans la seconde condition. Correction. \(K<7\) équivaut à \(K\leq6\), car aucun entier n’est strictement entre \(6\) et \(7\). On a \[|K-10|>3\iff K-10<-3\ \text{ou}\ K-10>3 \iff K<7\ \text{ou}\ K>13.\] En ajoutant \(10\) aux deux membres de chaque inégalité, on conserve leur sens. Ainsi les valeurs retenues sont \(K\leq6\) ou \(K\geq14\). Pour \(K=7\), \(|7-10|=3\) : cette valeur n’est pas retenue. Si tu avais inclus \(7\), reprends ce test de frontière avant d’utiliser une commande de calculatrice.
Rappel 8.2 — La loi binomiale et ses paramètres
Pour \(0<p<1\) et \(k\in\{0,\ldots,n\}\), \[\mathbb{P}(S_n=k)=\binom nk p^k(1-p)^{n-k},\qquad \operatorname{E}(S_n)=np,\qquad \operatorname{V}(S_n)=np(1-p).\] Le coefficient \(\binom nk\) compte les choix des \(k\) places des succès. Pour chacun de ces choix, l’indépendance donne le produit \(p^k(1-p)^{n-k}\). Les choix sont incompatibles : leurs probabilités s’ajoutent. Cette explication rappelle l’origine de la formule ; la construction complète de la loi binomiale relève du chapitre correspondant.
Si \(p=0\), \(S_n=0\) avec probabilité \(1\) ; si \(p=1\), \(S_n=n\) avec probabilité \(1\). On traite directement ces deux cas. Pour \(0\leq p\leq1\), les formules des moments restent valables et \[\operatorname{E}(F_n)=p,\qquad \operatorname{V}(F_n)=\frac{p(1-p)}n.\] Bienaymé–Tchebychev affirme que, pour une variable \(Y\) de moyenne \(\mu\), de variance \(v\) et tout \(d>0\), \(\mathbb{P}(|Y-\mu|\geq d)\leq v/d^2\). Cette inégalité est aussi vraie avec \(>d\), par inclusion d’événements. Elle donne une borne, non en général la probabilité exacte.
Méthode 8.3 — Calculer une probabilité de dépassement
Je reconnais. Le nombre d’essais, la probabilité de succès et l’indépendance sont connus ; l’énoncé demande une probabilité, ou permet de comparer un calcul à une garantie.
Écrire la variable, sa loi et ce qu’elle compte. Si l’énoncé parle de fréquence, remplacer \(F_n\) par \(S_n/n\).
Transformer l’événement avant tout appel à un outil. Multiplier par \(n>0\) conserve les inégalités.
Repérer les entiers admissibles et tester les valeurs situées aux frontières. Une borne réelle non entière n’autorise pas le même arrondi selon que l’inégalité est stricte ou large.
Additionner les probabilités de ces valeurs, ou utiliser une fonction de répartition cumulée. Préciser l’arrondi final.
Contrôler les valeurs extrêmes, l’appartenance du résultat à \([0;1]\) et, lorsqu’elle est utile, la majoration de Bienaymé–Tchebychev.
Premier geste. Écrire l’événement recherché sur une ligne séparée. La commande numérique arrive après, pas à la place de cette traduction.
Exemple de référence 8.4 — Les bornes entières font partie du calcul
Soit \(S_{100}\sim\mathcal{B}(100;0{,}35)\). Alors \(100p=35\) et \(\sqrt{100}=10\). L’événement proposé est strict : \[|S_{100}-35|>10 \iff S_{100}<25\ \text{ou}\ S_{100}>45 \iff S_{100}\leq24\ \text{ou}\ S_{100}\geq46.\] La dernière équivalence utilise le fait que le nombre de succès est entier. Les deux régions ne se recouvrent pas. Avec la loi binomiale rappelée dans cette unité, \[\begin{aligned} \mathbb{P}(|S_{100}-35|>10) &=\sum_{k=0}^{24}\binom{100}{k}(0{,}35)^k(0{,}65)^{100-k}\\ &\quad+\sum_{k=46}^{100}\binom{100}{k}(0{,}35)^k(0{,}65)^{100-k}\\ &\approx0{,}0271397706. \end{aligned}\] La variance vaut \(100\times0{,}35\times0{,}65=22{,}75\) ; Bienaymé–Tchebychev fournit le majorant \(22{,}75/10^2=0{,}2275\). On compare une probabilité calculée à une garantie universelle, pas deux calculs censés coïncider. Contrôle des frontières. \(S_{100}=25\) donne \(|25-35|=10\), donc n’est pas retenu ici. Si l’énoncé utilisait \(\geq10\), il faudrait inclure \(25\) et \(45\) : le résultat serait environ \(0{,}0457441846\). Le seul changement d’un signe peut donc changer sensiblement la réponse.
Bon réflexe 8.5 — Utiliser un cumul sans oublier un entier
Notons \(C(t)=\mathbb{P}(S_n\leq t)\) pour un entier \(t\). On convient que \(C(-1)=0\) et \(C(n)=1\). Pour des entiers \(0\leq a\leq b\leq n\), \[\mathbb{P}(a\leq S_n\leq b)=C(b)-C(a-1),\qquad \mathbb{P}(S_n\geq b)=1-C(b-1).\] Pourquoi ? \(C(b)\) compte les valeurs de \(0\) à \(b\) ; on retire celles de \(0\) à \(a-1\), et il reste exactement \(a,\ldots,b\). Pour la seconde formule, le complément de \(S_n\geq b\) est \(S_n\leq b-1\).
Application. Dans l’exemple \(S_{100}\sim\mathcal{B}(100;0{,}35)\), la probabilité recherchée est \(C(24)+1-C(45)\). Écrire \(C(24)+1-C(46)\) retirerait à tort la valeur \(46\). Gain et limite. Les cumuls évitent une longue addition manuelle, mais ne déterminent pas à ta place les bornes. Les noms des menus et des fonctions varient selon l’outil : choisir la fonction probabilité cumulée de la loi binomiale avec les paramètres \(n,p\), puis vérifier la convention \(\leq\) de la commande.
Lecture. Pour \(S_{100}\sim\mathcal{B}(100;0{,}35)\), chaque bâton représente une probabilité \(\mathbb{P}(S_{100}=k)\). Les régions retenues pour \(|S_{100}-35|>10\) sont \(k\leq24\) et \(k\geq46\). Les bâtons \(25\) et \(45\) restent exclus ; la somme des hauteurs retenues vaut environ \(0{,}02714\), beaucoup moins que le majorant \(0{,}2275\).
Proposition 8.6 — Le majorant pour un écart supérieur à la racine du nombre d’essais
Si \(S_n\sim\mathcal{B}(n;p)\) avec \(n\geq1\), alors \[\mathbb{P}\bigl(|S_n-np|>\sqrt n\bigr)\leq p(1-p)\leq\frac14.\]
Démonstration. Le seuil \(\sqrt n\) est strictement positif. L’événement strict est inclus dans \(|S_n-np|\geq\sqrt n\). Ainsi, \[\mathbb{P}\bigl(|S_n-np|>\sqrt n\bigr) \leq\frac{np(1-p)}{(\sqrt n)^2} =\frac{np(1-p)}n=p(1-p).\] La simplification est licite parce que \(n\neq0\). Enfin \(p(1-p)=1/4-(p-1/2)^2\leq1/4\) : le carré soustrait est non négatif.
Portée. Ce majorant ne tend pas vers \(0\) lorsque \(p\) est fixé. Cela ne contredit pas la loi des grands nombres : ici le seuil sur la fréquence serait \(1/\sqrt n\), qui se rétrécit avec \(n\), alors que le théorème de concentration vers l’espérance utilise une tolérance fixée à l’avance.
Algorithme 8.7 — Sélection exacte des entiers, somme numérique des probabilités
On écrit la probabilité \(p=a/b\) avec \(a,b\) entiers, \(b\geq1\) et \(0\leq a\leq b\). Le programme suivant calcule numériquement la probabilité de \(|S_n-np|>\sqrt n\). La sélection des valeurs de \(k\) est faite avec des entiers, pour éviter une erreur d’arrondi exactement sur une frontière.
Comme \(b>0\), l’inégalité recherchée équivaut à \(|bk-an|>b\sqrt n\). Les deux membres sont non négatifs : on peut comparer leurs carrés, d’où \((bk-an)^2>b^2n\).
from math import comb

def risque_binomial(n, a, b):
    if n < 1 or b < 1 or a < 0 or a > b:
        raise ValueError("parametres non autorises")
    if a == 0 or a == b:
        return 0.0
    p = a / b
    total = 0.0
    for k in range(n + 1):
        if (b*k - a*n)**2 > b*b*n:
            terme = comb(n, k) * p**k * (1-p)**(n-k)
            total = total + terme
    return total
Rôle des variables. k parcourt tous les nombres de succès de \(0\) à \(n\), inclus ; terme est la probabilité d’une seule valeur ; total, initialisé à \(0\), accumule seulement les probabilités retenues. La boucle possède \(n+1\) étapes, donc elle s’arrête.
Trace pour \(n=10\), \(p=2/5\). Le test retient \(k=0,8,9,10\). Le total vaut successivement \[0{,}0060466176;\quad0{,}0166634496;\quad 0{,}0182363136;\quad0{,}0183411712.\] Par exemple, le terme \(k=8\) vaut \(\binom{10}{8}(0{,}4)^8(0{,}6)^2=0{,}010616832\). Il est ajouté au premier total \(0{,}0060466176\). Le résultat est bien inférieur à \(0{,}4\times0{,}6=0{,}24\).
Limite numérique. Le programme utilise des décimaux machine pour la somme et convient aux exemples de cette unité. Pour de très grands \(n\), un logiciel de probabilités peut employer des méthodes numériques plus stables. Le caractère exact du test sur les entiers ne rend pas tous les calculs décimaux exacts.
À ton tour : la traduction commande le calcul
À toi 8.8 — Un calcul partiellement guidé
Soit \(S_{16}\sim\mathcal{B}(16;1/2)\). Calculer \(\mathbb{P}(|S_{16}-8|>4)\) puis comparer au majorant de Bienaymé–Tchebychev. Guidage. Traduire d’abord par \(S_{16}<\ldots\) ou \(S_{16}>\ldots\) ; compléter les bornes entières ; exploiter la symétrie entre \(k\) et \(16-k\).
Correction expliquée 8.9 — Deux queues symétriques
L’événement est \(S_{16}<4\) ou \(S_{16}>12\), donc \(S_{16}\leq3\) ou \(S_{16}\geq13\). Pour \(p=1/2\), chaque probabilité est \(\binom{16}{k}/2^{16}\). La symétrie \(\binom{16}{k}=\binom{16}{16-k}\) donne \[\begin{aligned} \mathbb{P}(|S_{16}-8|>4) &=2\,\frac{\binom{16}{0}+\binom{16}{1}+\binom{16}{2}+\binom{16}{3}}{2^{16}}\\ &=2\,\frac{1+16+120+560}{65536} =\frac{1394}{65536}=\frac{697}{32768}\approx0{,}02127. \end{aligned}\] Le facteur \(2\) ne s’applique ici que parce que les deux queues sont symétriques. La variance est \(16\times(1/2)\times(1/2)=4\), donc le majorant est \(4/4^2=4/16=1/4\). La probabilité exacte est plus petite. Les valeurs \(4\) et \(12\), à distance exactement \(4\) de \(8\), sont bien exclues.
À toi 8.10 — À tenter avant de consulter
Soit \(S_9\sim\mathcal{B}(9;1/3)\). Calculer la probabilité de \(|S_9-3|>3\) et donner le majorant correspondant. Justifier pourquoi une seule queue intervient. Indice. Le nombre de succès ne peut pas être négatif ; écris les deux régions avant d’en éliminer une.
Correction expliquée 8.11 — Une région impossible
On obtient \(S_9<0\) ou \(S_9>6\). La première région est impossible et la seconde donne \(S_9\in\{7,8,9\}\). Ainsi, \[\begin{aligned} \mathbb{P}(|S_9-3|>3) &=\binom97\left(\frac13\right)^7\left(\frac23\right)^2 +\binom98\left(\frac13\right)^8\left(\frac23\right) +\left(\frac13\right)^9\\ &=\frac{36\times4+9\times2+1}{3^9} =\frac{144+18+1}{19683} =\frac{163}{19683}\approx0{,}00828. \end{aligned}\] Chaque terme a le même dénominateur \(3^9\) : les exposants de \(3\) s’ajoutent dans les produits. La variance est \(9\times(1/3)\times(2/3)=2\). Bienaymé–Tchebychev donne le majorant \(2/3^2=2/9\approx0{,}2222\). Le contrôle confirme que \(0{,}00828<0{,}2222\) ; cette comparaison ne remplace pas la traduction de l’événement.
Question que tu peux te poser 8.12 — Pourquoi le signe strict n’autorise-t-il pas un arrondi automatique ?
Explique, avec une réponse personnelle, pourquoi \(K<7{,}2\) et \(K<7\) n’ont pas la même traduction pour un entier \(K\). Réponse possible. Dans le premier cas, \(7\) satisfait \(7<7{,}2\), donc on retient \(K\leq7\). Dans le second, \(7<7\) est faux, donc on retient \(K\leq6\). Le symbole \(<\) est le même, mais le statut entier de la borne change la dernière valeur admissible. Critères. Mentionner que \(K\) est entier ; tester le dernier entier ; conserver le caractère strict. Une phrase on arrondit vers le bas ne suffit pas lorsqu’elle inclut à tort une borne entière.
Point de vigilance 8.13 — Réparer une borne avant de relancer un programme
Première erreur. Traduire \(|S_4-2|>2\) par \(S_4\leq0\) ou \(S_4\geq4\) inclut les deux frontières à tort. Rappel et exemple plus simple. \(|x|>2\) n’inclut ni \(x=-2\) ni \(x=2\). Pour \(S_4\in\{0,1,2,3,4\}\), la traduction correcte est \(S_4<0\) ou \(S_4>4\) : elle ne retient aucune valeur, donc la probabilité vaut \(0\). Nouvel essai. Avec \(S_4\sim\mathcal{B}(4;1/2)\), remplacer \(>2\) par \(\geq2\) et calculer. Correction. Les valeurs \(0\) et \(4\) sont désormais retenues. Chacune a probabilité \((1/2)^4=1/16\), donc le résultat est \(1/16+1/16=2/16=1/8\). Retour. Dans l’exemple à \(100\) essais, teste de la même façon \(25\) et \(45\). Leur distance à \(35\) vaut \(10\) : ils appartiennent à l’événement large, pas à l’événement strict.
Exemple de référence 8.14 — Deux questions différentes sur une taille d’échantillon
On répète des essais indépendants de probabilité \(1/2\). On veut \(\mathbb{P}(|F_n-1/2|\geq1/2)\leq0{,}1\).
Question 1 : quelle taille garantit le résultat par concentration ? La variance d’une Bernoulli vaut \(1/4\). Le majorant est \[\frac{1/4}{n(1/2)^2}=\frac{1/4}{n/4}=\frac1n.\] Le diviseur \(n/4\) est non nul ; son inverse est \(4/n\), ce qui justifie \((1/4)\times(4/n)=1/n\). La condition \(1/n\leq1/10\) équivaut à \(n\geq10\) : multiplier par \(10n>0\) donne \(10\leq n\). Le certificat fournit donc \(n=10\).
Question 2 : quelle est la plus petite taille qui fonctionne réellement ? Comme \(0\leq F_n\leq1\), une distance au moins \(1/2\) à \(1/2\) n’est possible qu’aux valeurs \(0\) et \(1\). Il faut donc soit aucun succès, soit uniquement des succès. Ces événements sont disjoints pour \(n\geq1\) et leur probabilité totale est \[\left(\frac12\right)^n+\left(\frac12\right)^n=\frac2{2^n}.\] Cette expression est divisée par \(2\) lorsqu’on augmente \(n\) de \(1\), donc elle décroît. Pour \(n=4\), elle vaut \(2/16=1/8=0{,}125>0{,}1\) ; pour \(n=5\), elle vaut \(2/32=1/16=0{,}0625\leq0{,}1\). Le minimum réel est donc \(5\), et non \(10\). Conclusion. \(10\) était le plus petit entier satisfaisant le certificat choisi. La comparaison exacte ne contredit pas ce certificat : il promet une condition suffisante, pas une condition nécessaire.
À toi 8.15 — À reprendre plus tard, avant relecture
Soit \(S_4\sim\mathcal{B}(4;1/4)\). Calculer \(\mathbb{P}(|S_4-1|>2)\), comparer à Bienaymé–Tchebychev et justifier les bornes. Indice. \(S_4\) est compris entre \(0\) et \(4\) ; commence par une union de deux inégalités strictes. Correction. \(|S_4-1|>2\) donne \(S_4<-1\) ou \(S_4>3\). Seule la valeur \(4\) est possible. Ainsi la probabilité est \((1/4)^4=1/256=0{,}00390625\). La variance est \(4\times(1/4)\times(3/4)=3/4\). Le majorant vaut \((3/4)/4=3/16=0{,}1875\). Les deux nombres ne sont pas à confondre. Une réponse réussie nomme la loi, sélectionne \(4\) sans inclure \(3\), calcule la probabilité et qualifie \(3/16\) comme majorant.
Synthèse 8.16 — Choisir ce que l’on veut obtenir
Une loi connue permet un calcul de probabilité ; les seuls moments permettent une majoration générale. Pour comparer les deux, garder le même événement. Avant d’arrondir une probabilité, ne pas arrondir aveuglément ses bornes. Une taille suffisante issue d’un majorant n’est pas automatiquement la plus petite taille réelle.
9. Simuler des moyennes et une marche aléatoire
Objectif. Lire les états d’un programme, comparer une dispersion observée à une dispersion théorique et interpréter une trajectoire sans la prendre pour une démonstration.
Deux nombres à ne pas confondre : taille et nombre d’échantillons
Un échantillon de taille \(n\) contient \(n\) répétitions indépendantes de la même variable aléatoire \(X\). On recommence cette expérience complète \(N\) fois et on conserve les \(N\) moyennes obtenues. Ici, \(n\) désigne le nombre d’observations dans chaque échantillon ; \(N\) désigne le nombre de moyennes que l’on compare.
À toi 9.1 — Repérage : combien de valeurs sont produites ?
On simule \(N=5\) échantillons de taille \(n=20\). Combien de tirages de \(X\) réalise-t-on ? Combien de moyennes conserve-t-on ? Correction. Chaque échantillon demande \(20\) tirages et donne une moyenne. Les \(5\) échantillons demandent \(5\times20=100\) tirages et donnent \(5\) moyennes. Si tu avais répondu \(20\) moyennes, distingue la boucle qui construit un échantillon de celle qui recommence l’expérience complète.
Rappel 9.2 — Ce que la théorie annonce et ce que l’on observe
Si \(X\) a une espérance \(\mu\), une variance \(V=\sigma^2\) et si les observations de chaque échantillon sont indépendantes et de même loi, leur moyenne \(M_n\) vérifie \[\operatorname{E}(M_n)=\mu,\qquad \operatorname{V}(M_n)=\frac Vn, \qquad \sigma(M_n)=\frac\sigma{\sqrt n}.\] Ces résultats concernent la loi de la variable avant les tirages. Les nombres observés \(m_1,\ldots,m_N\) sont des réalisations : leur moyenne et leur écart type peuvent différer des valeurs théoriques.
La concentration donne, pour tout \(d>0\), \(\mathbb{P}(|M_n-\mu|\geq d)\leq V/(nd^2)\). Elle ne dit pas qu’une simulation de \(N\) moyennes reproduit exactement ce pourcentage. Une proportion simulée reste elle-même susceptible de fluctuer.
Définition 9.3 — Moyenne et écart type d’une série observée
Pour une liste non vide \(m_1,\ldots,m_N\), sa moyenne \(\overline m\) et son écart type descriptif \(s\) sont \[\overline m=\frac{m_1+\cdots+m_N}{N},\qquad s=\sqrt{\frac{(m_1-\overline m)^2+\cdots+(m_N-\overline m)^2}{N}}.\] Le centre utilisé dans ce calcul est la moyenne de cette liste, pas nécessairement l’espérance théorique \(\mu\). On emploie ici la convention descriptive : division par \(N\). Le calcul avec \(N-1\), utilisé dans d’autres cadres statistiques, n’est pas celui défini ici.
Exemple de référence 9.4 — Quelle moyenne sert à calculer l’écart type observé ?
Pour expliquer le calcul sur une toute petite série, supposons que les quatre moyennes observées soient \(1\), \(2\), \(3\), \(4\). Leur moyenne est \[\overline m=\frac{1+2+3+4}{4}=\frac{10}{4}=2{,}5.\] L’écart type de cette série observée se calcule autour de \(\overline m\) : \[\begin{aligned} s^2&=\frac{(1-2{,}5)^2+(2-2{,}5)^2+(3-2{,}5)^2+(4-2{,}5)^2}{4}\\ &=\frac{(-1{,}5)^2+(-0{,}5)^2+(0{,}5)^2+(1{,}5)^2}{4}\\ &=\frac{2{,}25+0{,}25+0{,}25+2{,}25}{4} =\frac54=1{,}25, \end{aligned}\] d’où \(s=\sqrt{1{,}25}\approx1{,}118\). On divise ici par \(N=4\), convention descriptive de la série, et non par \(N-1\). Si l’espérance théorique des moyennes est \(\mu=2\), centrer autour de \(2\) donnerait autre chose : \[\frac{(1-2)^2+(2-2)^2+(3-2)^2+(4-2)^2}{4} =\frac{1+0+1+4}{4}=1{,}5.\] C’est la moyenne des carrés des écarts au centre théorique, pas la variance empirique de la série. Ces valeurs diffèrent ici ; aucune n’est à remplacer par l’autre dans le programme. Ordre des opérations. On construit d’abord la liste complète, on calcule ensuite \(\overline m\), puis les écarts à cette même \(\overline m\), et enfin la racine carrée de leur moyenne. Changer le centre pendant la boucle changerait le calcul demandé.
Méthode 9.5 — Comparer deux dispersions et deux familles de bandes
Indices. On veut observer l’effet de \(n\) sur les moyennes ou comparer une expérience numérique à la formule \(\sigma/\sqrt n\).
Fixer la loi de \(X\), calculer \(\mu\) et \(\sigma\), puis choisir des entiers \(n,N\geq1\).
Produire \(N\) échantillons indépendants de taille \(n\) ; conserver leurs moyennes \(m_1,\ldots,m_N\).
Calculer \(\overline m\) puis \(s\). Comparer \(s\) à \(\sigma/\sqrt n\), sans exiger l’égalité.
Pour \(k=1,2,3\), compter séparément les moyennes qui vérifient \(|m_j-\mu|\leq ks\) et celles qui vérifient \(|m_j-\mu|\leq k\sigma/\sqrt n\).
Diviser chacun de ces effectifs par \(N\) et interpréter les proportions comme des résultats de simulation.
Premier geste. Distinguer sur le brouillon les trois nombres \(\mu\), \(\overline m\) et \(s\). Dans les bandes demandées, la distance est mesurée à \(\mu\) ; dans le calcul de \(s\), les carrés sont centrés sur \(\overline m\).
Exemple de référence 9.6 — Un modèle simple pour construire les échantillons
À chaque tirage indépendant, \(X\) vaut \(0\) ou \(4\) avec probabilité \(1/2\) chacune. Les deux valeurs ont le même poids : \[\mu=0\times\frac12+4\times\frac12=2,\] \[V=(0-2)^2\times\frac12+(4-2)^2\times\frac12 =4\times\frac12+4\times\frac12=4, \qquad \sigma=\sqrt4=2.\] Pour \(n=4\), l’écart type théorique des moyennes vaut \(2/\sqrt4=1\). Pour \(n=64\), il vaut \(2/\sqrt{64}=2/8=0{,}25\). Multiplier la taille par \(16\) divise donc cet écart type par \(4\).
Les moyennes \(1,2,3,4\) de l’exemple de centrage sont possibles dans ce modèle avec \(n=4\). Elles peuvent provenir respectivement de \(1,2,3,4\) valeurs égales à \(4\) dans les quatre échantillons. Leur liste illustre le calcul ; elle n’est pas présentée comme un résultat imposé de toute simulation.
Algorithme 9.7 — Construire la liste des moyennes
La fonction random() fournit un nombre pseudo-aléatoire entre \(0\) inclus et \(1\) exclu. Le test random()<0.5 modélise ici deux issues équiprobables. Les tirages du programme servent à simuler les répétitions indépendantes du modèle ; ils ne constituent pas une preuve mathématique de ce modèle.
from random import random, seed

def tirer_X():
    if random() < 0.5:
        return 0
    return 4

def echantillons(n, N):
    if n < 1 or N < 1:
        raise ValueError("tailles strictement positives")
    moyennes = []
    for j in range(N):
        total = 0
        for i in range(n):
            total = total + tirer_X()
        moyennes.append(total / n)
    return moyennes
Les entrées n et N sont des entiers strictement positifs. La liste est vide au départ. Pour chaque nouvelle valeur de j, total revient à \(0\) ; les \(n\) tirages sont ensuite additionnés ; total/n est ajouté à la liste.
Trace d’un échantillon. Avec les tirages \(0,4,0,4\), le total vaut successivement \(0,4,4,8\) et la moyenne vaut \(8/4=2\). Si l’échantillon suivant contient \(4,4,4,0\), le nouveau total part bien de \(0\) : il devient \(4,8,12,12\), donnant \(12/4=3\). Il ne doit pas commencer à \(8\). Arrêt et contrôle. Les deux boucles exécutent \(N\times n\) tirages. À la fin, la liste doit avoir \(N\) éléments, tous compris entre \(0\) et \(4\). Une moyenne supérieure à \(4\) révèle une erreur de programme, pas une fluctuation exceptionnelle du modèle.
Algorithme 9.8 — Décrire une liste de moyennes sans changer de centre
L’entrée moyennes est une liste non vide de nombres. Le programme renvoie la moyenne de cette liste et son écart type descriptif. La fonction sqrt, importée de math, calcule la racine carrée.
from math import sqrt

def statistiques(moyennes):
    N = len(moyennes)
    if N == 0:
        raise ValueError("liste vide")
    total = 0.0
    for m in moyennes:
        total = total + m
    centre = total / N
    carres = 0.0
    for m in moyennes:
        carres = carres + (m - centre)**2
    s = sqrt(carres / N)
    return centre, s
États sur [1,2,3,4]. Le premier total, initialisé à \(0\), vaut successivement \(1\), \(3\), \(6\), \(10\). Le centre est ensuite fixé à \(10/4=2{,}5\). Dans la seconde boucle, le total des carrés vaut successivement \(2{,}25\), \(2{,}5\), \(2{,}75\), \(5\). La sortie est donc \((2{,}5;\sqrt{5/4})\). Le nombre d’itérations est fini : chaque boucle parcourt les \(N\) éléments une seule fois. Premier geste pour contrôler. Vérifier que centre est calculé après la première boucle et n’est plus modifié dans la seconde. On ne doit ni ajouter des carrés à l’ancien total, ni remplacer centre par l’espérance théorique.
Algorithme 9.9 — Compter sans confondre centre et rayon
Les entrées sont une liste non vide de moyennes, le centre théorique mu, l’écart type descriptif s, l’écart type sigma de \(X\) et la taille n. Les deux écarts types sont non négatifs et n est un entier strictement positif.
def proportions(moyennes, mu, s, sigma, n):
    N = len(moyennes)
    if N == 0 or n < 1 or s < 0 or sigma < 0:
        raise ValueError("parametres non autorises")
    theorique = sigma / sqrt(n)
    tableau = []
    for k in (1, 2, 3):
        compte_s = 0
        compte_theorique = 0
        for m in moyennes:
            if abs(m - mu) <= k*s:
                compte_s = compte_s + 1
            if abs(m - mu) <= k*theorique:
                compte_theorique = compte_theorique + 1
        tableau.append((k, compte_s/N, compte_theorique/N))
    return tableau
abs calcule la valeur absolue. Pour chaque \(k\), les deux compteurs repartent de \(0\). Ils sont augmentés de \(1\) quand la moyenne courante appartient à la bande correspondante. Le résultat comporte trois lignes ; chaque ligne contient \(k\) et les deux proportions.
Contrôle sur \([1,2,3,4]\). Avec \(\mu=2\), les distances sont \(1,0,1,2\). Pour \(n=4\), \(\sigma=2\) et \(s=\sqrt{1{,}25}\), la bande \(k=1\) retient trois valeurs dans les deux cas : proportions \(3/4\). Pour \(k=2\) puis \(k=3\), elle les retient toutes : proportions \(1\). La valeur de \(s\) n’est pas égale à \(1\), même si ces comptages donnent ici les mêmes proportions.
Remarque 9.10 — Exécuter et lire une expérience numérique
On peut utiliser successivement les instructions suivantes, après avoir défini les fonctions :
seed(20261031)
moyennes = echantillons(64, 2000)
centre, s = statistiques(moyennes)
bandes = proportions(moyennes, 2, s, 2, 64)
Fixer une graine rend la suite de tirages reproductible dans l’environnement utilisé. Cela aide à contrôler le programme ; ce n’est ni une nouvelle hypothèse probabiliste ni la preuve que les valeurs obtenues sont typiques.
Il faut comparer centre à \(2\) et s à \(0{,}25\). Une nouvelle simulation peut changer les valeurs et les proportions. Un rapprochement observé illustre le modèle ; il ne démontre pas que les trois proportions valent des pourcentages universels. En particulier, il n’existe pas dans ce cours de règle imposant \(68\,\%\), \(95\,\%\) et \(99{,}7\,\%\) à toute variable aléatoire.
Lecture. Dans le modèle \(X\in\{0;4\}\) équiprobable, chaque moyenne utilise \(n=64\) observations et l’écart type théorique vaut \(2/\sqrt{64}=0{,}25\). L’histogramme regroupe \(N=2\,000\) moyennes ; les traits repèrent les rayons \(k\times0{,}25\) autour de \(2\), pour \(k=1,2,3\). La graine choisie est \(20261031\). Une figure de simulation montre un résultat observé, pas une garantie pour chaque moyenne.
Méthode 9.11 — Refaire le calcul sur quatre lignes de tableur
Voici un petit exemple à saisir, sans tirages automatiques, pour contrôler les formules. Les lignes \(2\) à \(5\) représentent les quatre échantillons ; les colonnes B à E contiennent leurs quatre valeurs :
| Ligne | B | C | D | E | Moyenne en F |
|---|---|---|---|---|---|
| 2 | 0 | 0 | 0 | 4 | 1 |
| 3 | 0 | 0 | 4 | 4 | 2 |
| 4 | 0 | 4 | 4 | 4 | 3 |
| 5 | 4 | 4 | 4 | 4 | 4 |
Dans un tableur à noms de fonctions français, on peut saisir les formules suivantes ; la traduction des noms et le séparateur peuvent varier selon le logiciel ou sa langue.
| Cellule | Formule et rôle |
|---|---|
| F2 | =MOYENNE(B2:E2), à recopier jusqu’à F5. |
| F7 | =MOYENNE(F2:F5) : centre observé \(2{,}5\). |
| G2 | =(F2-$F$7)^2, à recopier jusqu’à G5. |
| G7 | =RACINE(MOYENNE(G2:G5)) : écart type \(s\). |
| J1 | Saisir \(1\), puis recommencer avec \(2\) et \(3\) : valeur de \(k\). |
| H2 | =SI(ABS(F2-2)<=$J$1*$G$7;1;0). |
| I2 | =SI(ABS(F2-2)<=$J$1*1;1;0). |
| H7, I7 | Après recopie de H2 et I2 jusqu’à la ligne 5 : =MOYENNE(H2:H5) et =MOYENNE(I2:I5). |
Pourquoi les dollars ? En recopiant G2 vers G3, F2 devient F3, mais $F$7 reste F7 : toutes les distances sont calculées au même centre. Dans H et I, le centre théorique est \(2\) ; le rayon théorique par unité de \(k\) vaut ici \(\sigma/\sqrt n=1\). Contrôle. G2:G5 doit afficher \(2{,}25;0{,}25;0{,}25;2{,}25\). Pour \(k=1\), H7 et I7 valent \(0{,}75\). Si les tirages sont ensuite automatisés, les figer pour comparer une même série : un recalcul aléatoire peut sinon modifier les données entre deux lectures.
Pratiquer le calcul statistique et réparer les confusions
À toi 9.12 — Un centre à calculer d’abord
Les moyennes observées sont \(0,2,2,4\). Calculer \(\overline m\) puis \(s\). Avec \(\mu=2\) et \(\sigma/\sqrt n=1\), déterminer les deux proportions pour \(k=1\). Guidage. Commencer par la somme \(0+2+2+4\) ; garder ensuite le même centre pour les quatre carrés. Pour les bandes, mesurer les distances à \(\mu=2\).
Correction expliquée 9.13 — Centre, carrés et comptages
On trouve \(\overline m=8/4=2\). Les écarts sont \(-2,0,0,2\), leurs carrés \(4,0,0,4\), donc \[s^2=\frac{4+0+0+4}{4}=2,\qquad s=\sqrt2\approx1{,}414.\] Les distances à \(\mu=2\) valent \(2,0,0,2\). Seules les deux valeurs égales à \(2\) sont à distance au plus \(\sqrt2\) ; seules ces mêmes valeurs sont à distance au plus \(1\). Les deux proportions valent \(2/4=1/2\). Les rayons différents peuvent donc sélectionner les mêmes observations.
À toi 9.14 — À tenter avant de consulter
Cette fois, les moyennes observées sont \(0,1,1,2\). Calculer \(\overline m\) et \(s\). Le centre théorique reste \(\mu=2\) et l’écart type théorique des moyennes vaut \(1\). Calculer les deux proportions pour \(k=1\). Indice. La moyenne observée et le centre théorique ne sont plus égaux : ne mélange pas leurs deux rôles.
Correction expliquée 9.15 — Les deux bandes ne comptent plus les mêmes valeurs
La moyenne de la liste est \((0+1+1+2)/4=4/4=1\). Les écarts à \(1\) sont \(-1,0,0,1\) ; ainsi \(s^2=(1+0+0+1)/4=1/2\) et \(s=\sqrt{1/2}\approx0{,}7071\).
Pour les bandes, on revient au centre théorique \(2\). Les distances sont \(2,1,1,0\). Seule la dernière valeur est à distance au plus \(0{,}7071\), d’où la proportion \(1/4\). Les trois dernières sont à distance au plus \(1\), d’où la proportion \(3/4\). Le signe \(\leq\) inclut bien les deux distances égales à \(1\).
Question que tu peux te poser 9.16 — Justifier le centre et le nombre de divisions
Pourquoi calcule-t-on \(s\) autour de \(\overline m\), puis les proportions autour de \(\mu\) ? Pourquoi la dernière division des compteurs se fait-elle par \(N\), et non par \(n\) ? Réponse possible. \(s\) décrit la dispersion des \(N\) nombres effectivement observés, donc il utilise leur propre moyenne. Les proportions demandées mesurent la proximité au centre théorique du modèle, donc elles utilisent \(\mu\). On compte des moyennes parmi \(N\) moyennes : la proportion est cet effectif divisé par \(N\). \(n\) a déjà servi à calculer chacune des moyennes. Critères. Nommer la série décrite, distinguer les deux centres et identifier l’ensemble dans lequel on compte. Des valeurs numériques correctes avec ces rôles inversés ne suffisent pas.
Point de vigilance 9.17 — Le bon résultat d’une fonction dépend de son ordre de calcul
Première erreur. Remplacer le centre de la seconde boucle par la constante théorique \(\mu\) ne calcule plus l’écart type descriptif demandé. Rappel et exemple simple. Pour la liste \([2,4]\), le centre observé vaut \((2+4)/2=3\) et \(s^2=((2-3)^2+(4-3)^2)/2=(1+1)/2=1\). Centrer à tort sur \(2\) donnerait \((0+4)/2=2\). Nouvel essai. Calculer \(s\) pour \([0,2]\). Correction. Le centre est \(1\) ; les deux écarts sont \(-1\) et \(1\). On obtient \(s^2=(1+1)/2=1\), donc \(s=1\). Retour. Sur \([1,2,3,4]\), le centre doit être \(2{,}5\) dans tous les termes : le résultat est \(s^2=1{,}25\), pas \(1{,}5\). Vérifie l’affectation de centre avant de chercher une erreur dans la racine carrée.
Autre contrôle d’état. Si total=0 est déplacé avant la boucle des \(N\) échantillons, les sommes précédentes s’accumulent. Avec deux échantillons \([4,4]\), on obtiendrait les fausses moyennes \(4\) puis \(8\). Réinitialiser dans la boucle extérieure rétablit \(4\) puis \(4\).
À toi 9.18 — À reprendre plus tard : lire les trois paramètres
Pour la liste \([1,3,3,5]\), calculer \(\overline m\) et \(s\). Avec \(\mu=2\) et \(\sigma/\sqrt n=1\), calculer les deux proportions pour \(k=1\). Indice. Commencer par le centre de la liste ; le centre des bandes est indiqué séparément. Correction. La somme vaut \(12\), donc \(\overline m=3\). Les carrés des écarts à \(3\) sont \(4,0,0,4\), d’où \(s=\sqrt{8/4}=\sqrt2\). Les distances à \(2\) valent \(1,1,1,3\). Les trois premières sont inférieures ou égales à \(\sqrt2\) et à \(1\) ; la dernière ne l’est pas. Les deux proportions valent \(3/4\). Une réponse complète précise les deux centres et les deux rayons, même lorsque les proportions coïncident.
Une autre expérience : la marche aléatoire
À toi 9.19 — Repérage : position et nombre de pas
Une marche part de \(0\) et effectue les déplacements \(+1,-1,+1\). Donner les positions après chaque pas et la position finale divisée par le nombre de pas. Correction. Les positions sont \(1\), puis \(1-1=0\), puis \(0+1=1\). La moyenne des déplacements vaut \(1/3\). Le nombre de pas est \(3\) ; il ne faut pas le confondre avec la position \(1\).
Définition 9.20 — Une marche aléatoire simple symétrique
À chaque étape, indépendamment des précédentes, le déplacement \(D_i\) vaut \(+1\) ou \(-1\) avec probabilité \(1/2\) chacune. La position après \(n\) pas, avec départ en \(0\), est \[R_0=0,\qquad R_n=D_1+\cdots+D_n\quad(n\geq1).\] Le quotient \(R_n/n\) est la moyenne des déplacements, pas la moyenne des positions intermédiaires.
Proposition 9.21 — Une position plus dispersée, un déplacement moyen moins dispersé
Dans ce modèle, pour \(n\geq1\), \[\operatorname{E}(R_n)=0,\qquad \operatorname{V}(R_n)=n, \qquad \operatorname{E}(R_n/n)=0,\qquad \operatorname{V}(R_n/n)=\frac1n.\]
Démonstration. Pour un pas, \(\operatorname{E}(D_i)=1\times(1/2)+(-1)\times(1/2)=0\) et \(\operatorname{V}(D_i)=1^2\times(1/2)+(-1)^2\times(1/2)=1\). La linéarité de l’espérance et l’additivité de la variance des pas indépendants donnent \(0+\cdots+0=0\) et \(1+\cdots+1=n\). Pour le quotient, \[\operatorname{V}(R_n/n)=\left(\frac1n\right)^2\operatorname{V}(R_n) =\frac n{n^2}=\frac1n,\] puisque \(n>0\). L’écart type de la position vaut \(\sqrt n\) ; celui du déplacement moyen vaut \(1/\sqrt n\). Ils n’ont pas le même comportement.
En particulier, pour tout \(d>0\) fixé, \(\mathbb{P}(|R_n/n|\geq d)\leq1/(nd^2)\) tend vers \(0\). On ne peut pas en conclure que \(R_n\) se rapproche de \(0\) à chaque pas, ni que la marche est condamnée à revenir immédiatement à son origine.
Propriété 9.22 — Relier le nombre de pas positifs à la position
Si \(B_n\) compte les déplacements \(+1\), alors \(B_n\sim\mathcal{B}(n;1/2)\) et \(R_n=2B_n-n\).
Démonstration. Il y a \(B_n\) pas positifs et \(n-B_n\) pas négatifs. Le déplacement total est donc \[B_n\times1+(n-B_n)\times(-1) =B_n-n+B_n=2B_n-n.\] La loi binomiale vient du comptage de \(n\) essais indépendants dont le succès pas positif a probabilité \(1/2\). Cette relation donne un autre moyen de calculer une probabilité portant sur la position.
Algorithme 9.23 — Conserver les positions dans le bon ordre
La fonction suivante prend un entier \(n\geq1\) et renvoie la liste des positions, départ compris.
def marche(n):
    if n < 1:
        raise ValueError("nombre de pas positif")
    position = 0
    chemin = [position]
    for i in range(n):
        if random() < 0.5:
            pas = 1
        else:
            pas = -1
        position = position + pas
        chemin.append(position)
    return chemin
Trace. Pour les pas \(+1,+1,-1,+1,-1,-1\), la liste devient successivement \([0,1]\), \([0,1,2]\), \([0,1,2,1]\), \([0,1,2,1,2]\), \([0,1,2,1,2,1]\), puis \([0,1,2,1,2,1,0]\). Ordre à respecter. Le déplacement est d’abord tiré, la position est ensuite mise à jour, et cette nouvelle position est enfin ajoutée. La liste finale a \(n+1\) valeurs et deux positions consécutives diffèrent exactement de \(1\) ou \(-1\). Ces deux contrôles testent le programme, pas la loi des grands nombres.
Lecture. Le premier tracé représente \(R_n\), le second \(R_n/n\) pour les mêmes tirages. Le quotient divise la position par le nombre de pas. Des remontées locales restent possibles : sur les quatre premiers pas de la trace \(+1,+1,-1,+1\), le déplacement moyen passe de \(1/3\) au troisième pas à \(1/2\) au quatrième. La loi des grands nombres ne dit pas que ces valeurs diminuent à chaque étape.
À toi 9.24 — Lire puis contrôler une trajectoire
Pour les pas \(+1,-1,-1,+1,+1\), calculer les positions et vérifier la position finale avec le nombre de pas positifs. Donner le déplacement moyen final. Guidage. Inscrire le départ \(0\) ; ajouter chaque pas à la position précédente ; compter séparément les \(+1\). Correction. Les positions sont \(0,1,0,-1,0,1\). Il y a \(3\) pas positifs, donc \(2B_5-5=2\times3-5=1\), ce qui confirme la position finale. Le déplacement moyen vaut \(R_5/5=1/5=0{,}2\).
À toi 9.25 — À tenter avant de consulter
Une marche comporte \(100\) pas indépendants équiprobables. Donner l’espérance et l’écart type de la position finale, puis majorer \(\mathbb{P}(|R_{100}/100|\geq0{,}2)\). Cette majoration garantit-elle que toute marche reste dans une bande de largeur \(40\) autour de \(0\) pendant les \(100\) étapes ? Indice. La question probabiliste porte sur la position finale divisée par \(100\), pas sur toutes les positions de la trajectoire. Correction. L’espérance de \(R_{100}\) vaut \(0\) et son écart type vaut \(\sqrt{100}=10\). La variance du déplacement moyen est \(1/100\). Le majorant est \[\frac{1/100}{(0{,}2)^2}=\frac{0{,}01}{0{,}04}=\frac14.\] Cette borne concerne \(|R_{100}|\geq20\), événement de position finale. Elle ne concerne pas l’événement une des positions intermédiaires sort de la bande , et ne donne aucune garantie pour toute trajectoire.
Question que tu peux te poser 9.26 — Pourquoi une grande position peut-elle accompagner une petite moyenne ?
Expliquer pourquoi \(\sigma(R_n)=\sqrt n\) et \(\sigma(R_n/n)=1/\sqrt n\) ne se contredisent pas. Réponse possible. La première grandeur mesure un déplacement total en \(n\) pas ; la seconde le rapporte au nombre de pas. La position est divisée par \(n\), donc son écart type aussi : \(\sqrt n/n=1/\sqrt n\). Le total peut être plus dispersé alors que le déplacement moyen devient moins dispersé. Critères. Nommer les deux variables et le changement d’échelle ; ne pas expliquer la diminution par une obligation de compenser chaque pas.
Point de vigilance 9.27 — Réparer le quotient et l’ordre de mise à jour
Première erreur. Après trois pas \(+1,+1,-1\), diviser la position finale par le nombre de pas positifs donne \(1/2\) : ce n’est pas la moyenne des trois déplacements. Rappel et exemple simple. Une moyenne divise la somme par le nombre de valeurs. Pour deux pas \(+1,-1\), la moyenne est \((1-1)/2=0\). Nouvel essai. Pour les pas \(-1,+1,+1,+1\), calculer la position et la moyenne. Correction. La somme vaut \(-1+1+1+1=2\) ; il y a quatre déplacements, donc la moyenne vaut \(2/4=1/2\). Retour. Les trois pas initiaux ont pour somme \(1\) ; leur moyenne vaut bien \(1/3\). Dans le code, ajouter la nouvelle position après son calcul évite de décaler toutes les observations d’une étape.
À toi 9.28 — À reprendre plus tard, avant relecture
Après \(8\) pas, on a compté \(3\) déplacements positifs. Calculer la position finale et le déplacement moyen. Dire ensuite si ces données permettent de reconstituer toute la trajectoire. Indice. Les \(5\) autres déplacements sont négatifs ; plusieurs ordres sont possibles. Correction. La position vaut \(3-5=-2\), ou \(2\times3-8=-2\). Le déplacement moyen vaut \(-2/8=-1/4\). Les nombres de pas positifs et négatifs ne donnent pas leur ordre : ils déterminent la position finale, pas la trajectoire complète. Une réponse correcte distingue donc total, moyenne et suite des positions.
Synthèse 9.29 — Ce qu’une simulation permet et ne permet pas
Une simulation met en relation une loi, des échantillons et des observations. Elle permet de chercher une erreur, de comparer des dispersions et de formuler une conjecture ; elle ne remplace pas une preuve. Pour les moyennes, distinguer \(n\), \(N\), \(\mu\), \(\overline m\) et \(s\). Pour la marche, distinguer le nombre de pas, la position et le déplacement moyen. Dans les deux cas, une fluctuation locale n’invalide pas la loi des grands nombres.
10. Approfondissement : estimer et discuter un modèle
Objectif. Construire une garantie prudente autour d’une fréquence observée et distinguer l’incertitude d’échantillonnage d’un défaut du modèle.
Place de cette unité. L’estimation est un approfondissement possible du programme. Le parcours qui suit est facultatif : les unités du cours principal n’en dépendent pas. Il prolonge l’inégalité de concentration sans utiliser de loi normale ni de théorème central limite.
Estimer un paramètre : ce qui est fixé et ce qui est aléatoire
On suppose que des essais indépendants possèdent tous la même probabilité \(p\) de succès, mais que l’on ne connaît pas la valeur de \(p\). On observe \(n\) essais et leur fréquence \(F_n\). Le but n’est pas de rendre \(p\) aléatoire : on cherche une procédure qui donne souvent un intervalle contenant ce paramètre fixé.
À toi 10.1 — Repérage avant et après les observations
Dans une même population et un même modèle, on répète deux échantillonnages de taille \(100\). La fréquence observée vaut \(0{,}42\) la première fois et \(0{,}47\) la seconde. Le paramètre \(p\) doit-il avoir changé ? Correction. Non. \(F_{100}\) est une variable aléatoire : les échantillons peuvent donner des fréquences différentes avec le même \(p\). Avant observation, la fréquence est aléatoire ; après observation, sa valeur numérique est connue. Si tu pensais que \(p\) valait exactement chaque fréquence observée, distingue le modèle de ses réalisations.
Rappel 10.2 — Une borne utilisable sans connaître la probabilité
Avec \(n\geq1\) essais de Bernoulli indépendants de même probabilité \(p\in[0;1]\), \[\operatorname{E}(F_n)=p,\qquad \operatorname{V}(F_n)=\frac{p(1-p)}n.\] Pour tout \(d>0\), Bienaymé–Tchebychev donne \[\mathbb{P}(|F_n-p|\geq d)\leq\frac{p(1-p)}{nd^2} \leq\frac1{4nd^2},\] car \(p(1-p)=1/4-(p-1/2)^2\leq1/4\). Cette dernière borne est moins précise lorsque \(p\) est éloigné de \(1/2\), mais elle n’exige pas de connaître \(p\).
Une probabilité d’erreur d’au plus \(\alpha\) est une garantie sur les répétitions possibles de la procédure, sous les hypothèses du modèle. Elle ne garantit ni l’absence totale d’erreur ni la validité du modèle lui-même.
Définition 10.3 — Un intervalle construit à partir des données
Un intervalle aléatoire est un intervalle dont les bornes dépendent de l’échantillon. Avant les observations, ses bornes peuvent varier ; après les observations, on obtient un intervalle numérique fixé. La couverture d’une procédure, pour un paramètre \(p\) fixé, est la probabilité que l’intervalle ainsi construit contienne \(p\).
Le paramètre \(p\) n’a pas de loi de probabilité dans ce modèle. C’est l’intervalle qui varie d’un échantillon à l’autre.
Proposition 10.4 — Un intervalle dont la procédure est garantie
Dans \(n\) essais de Bernoulli indépendants de même probabilité \(p\), on observe la fréquence \(F_n\). Fixons \(0<\alpha<1\) et posons \[r=\sqrt{\frac1{4n\alpha}},\qquad I_n=[F_n-r;F_n+r]\cap[0;1].\] Avant l’observation, \(I_n\) est aléatoire et \(p\) est un paramètre fixé. Alors \(\mathbb{P}(p\in I_n)\geq1-\alpha\).
Démonstration. La borne uniforme rappelée ici donne \[\mathbb{P}(|F_n-p|\geq r)\leq\frac1{4nr^2} =\frac1{4n\times(1/(4n\alpha))}=\alpha.\] Le dénominateur \(4n\alpha\) est strictement positif. Par complément, \(\mathbb{P}(|F_n-p|<r)\geq1-\alpha\). Or \(|F_n-p|<r\) entraîne \(F_n-r<p<F_n+r\) et donc \(p\in I_n\), puisque \(p\in[0;1]\). L’inclusion d’événements donne la conclusion, même avec l’intervalle fermé affiché. Interprétation. La garantie concerne la méthode sur les répétitions possibles de l’échantillon. Après avoir observé une fréquence précise, l’intervalle est fixé : il contient ou non \(p\). On ne transforme pas cette garantie en une probabilité conditionnelle attribuée au paramètre fixe.
Méthode 10.5 — Passer d’une fréquence à un intervalle prudent
Indices. On observe une proportion et l’on veut une garantie de couverture valable sans connaître \(p\).
Identifier la population visée et les hypothèses : essais indépendants, même probabilité de succès, taille \(n\) fixée.
Choisir le risque \(\alpha\in]0;1[\), puis calculer le rayon \(r=\sqrt{1/(4n\alpha)}\).
Calculer la fréquence observée \(f\), puis l’intervalle \([f-r;f+r]\).
Intersecter avec \([0;1]\), puisque le paramètre est une probabilité.
Formuler la garantie sur la procédure, sans annoncer que \(p=f\) ni une certitude pour l’échantillon particulier.
Premier geste. Écrire séparément \(n\), \(\alpha\) et \(f\). Le rayon dépend de \(n\) et d’\(\alpha\), pas ici d’un remplacement de \(p\) par \(f\) dans la variance.
Exemple de référence 10.6 — Une fréquence observée dans un modèle annoncé
On suppose que \(2\,000\) essais répondent aux hypothèses précédentes. On observe \(1\,260\) succès et on choisit \(\alpha=0{,}05\). La fréquence vaut \[f=\frac{1260}{2000}=0{,}63.\] Le rayon se calcule avec les paramètres choisis : \[\begin{aligned} r&=\sqrt{\frac1{4\times2000\times0{,}05}} =\sqrt{\frac1{400}} =\frac1{20}=0{,}05. \end{aligned}\] Les deux bornes sont \(0{,}63-0{,}05=0{,}58\) et \(0{,}63+0{,}05=0{,}68\). Elles appartiennent déjà à \([0;1]\), donc l’intervalle observé est \([0{,}58;0{,}68]\).
Contrôle de la garantie. \(r^2=0{,}0025\), donc \(4nr^2=4\times2000\times0{,}0025=20\) et \(1/(4nr^2)=1/20=0{,}05\). Sous le modèle annoncé, la procédure possède une couverture d’au moins \(0{,}95\).
Ce que l’on ne dit pas. Ce calcul ne démontre pas que \(p\) appartient effectivement à cet intervalle précis. Il ne démontre pas non plus que l’échantillon est représentatif si son mode de sélection ne respecte pas les hypothèses.
Question que tu peux te poser 10.7 — À quoi se rapporte la garantie de couverture ?
Pourquoi l’énoncé \(\mathbb{P}(p\in I_n)\geq1-\alpha\) est-il une affirmation probabiliste alors que \(p\) est fixé ? Après observation, que devient l’intervalle ? Réponse possible. Avant observation, les bornes de \(I_n\) dépendent de \(F_n\) et sont donc aléatoires. L’événement l’intervalle contient \(p\) peut être réalisé ou non selon l’échantillon. Après observation de \(f\), les bornes sont numériques et l’intervalle est fixé : il contient ou non le paramètre. La garantie décrit la procédure sur les répétitions possibles, pas une nouvelle loi attribuée à \(p\). Critères. Nommer l’objet aléatoire, le paramètre fixé et le rôle du moment d’observation. Il n’est pas nécessaire de reprendre ces phrases mot pour mot.
À toi 10.8 — Construire puis recouper avec les probabilités possibles
Pour \(n=500\), on observe \(30\) succès et on choisit \(\alpha=0{,}05\). Calculer \(f\), \(r\) et l’intervalle observé. Guidage. Calculer \(4n\alpha\) avant la racine ; une borne négative doit être recoupée avec \([0;1]\).
Correction expliquée 10.9 — La borne négative ne concerne aucune probabilité
On a \(f=30/500=0{,}06\) et \[r=\sqrt{\frac1{4\times500\times0{,}05}} =\sqrt{\frac1{100}}=0{,}1.\] L’intervalle avant intersection est \([0{,}06-0{,}1;0{,}06+0{,}1]=[-0{,}04;0{,}16]\). Comme \(p\in[0;1]\), on conserve \([0;0{,}16]\). Cette intersection ne fait perdre aucun paramètre admissible : \(p\) ne pouvait pas être négatif. Elle conserve donc la garantie de couverture.
À toi 10.10 — À tenter avant de consulter
Pour \(n=8\,000\), la fréquence observée est \(0{,}73\). Avec \(\alpha=0{,}05\), déterminer le rayon et l’intervalle de la procédure. Comparer le rayon à celui obtenu avec \(2\,000\) essais au même risque. Indice. La taille est multipliée par \(4\) ; la racine carrée intervient dans le changement d’échelle.
Correction expliquée 10.11 — Quatre fois plus d’essais, un rayon divisé par deux
Le produit \(4\times8000\times0{,}05\) vaut \(1600\). Ainsi \[r=\sqrt{\frac1{1600}}=\frac1{40}=0{,}025.\] L’intervalle est \([0{,}73-0{,}025;0{,}73+0{,}025]=[0{,}705;0{,}755]\). Ses bornes sont dans \([0;1]\). À risque fixé, le rayon est proportionnel à \(1/\sqrt n\) ; remplacer \(n\) par \(4n\) remplace \(\sqrt n\) par \(2\sqrt n\), donc divise le rayon par \(2\). Il ne le divise pas par \(4\).
Contre-exemple 10.12 — Remplacer la variance inconnue par celle de la fréquence peut détruire la garantie
Supposons \(p=0{,}1\) et \(n=10\). L’événement aucun succès observé a probabilité \[(1-p)^{10}=(0{,}9)^{10}=0{,}3486784401.\] Sur cet événement, \(f=0\). Si l’on remplace à tort \(p(1-p)\) par \(f(1-f)=0\) dans une formule de rayon, on obtient un rayon nul et l’intervalle \([0;0]\). Celui-ci ne contient pas le vrai paramètre \(0{,}1\).
La probabilité d’échec de cette procédure serait donc au moins \(0{,}3486784401\), déjà supérieure à un risque annoncé de \(0{,}05\). On ne peut pas transférer la garantie précédente à cette nouvelle procédure sans une justification nouvelle. La borne \(1/4\), elle, reste valable pour tout \(p\in[0;1]\).
Point de vigilance 10.13 — Réparer la confusion entre paramètre et intervalle
Première erreur. Après avoir observé un intervalle numérique, lui attribuer la garantie comme si le paramètre se mettait à varier dans l’expérience initiale change le modèle. Exemple plus simple. Fixons \(p=1/2\) et faisons deux essais indépendants. La fréquence vaut \(0\), \(1/2\) ou \(1\), avec probabilités \(1/4\), \(1/2\) et \(1/4\). Construisons, seulement pour cette illustration, l’intervalle \([F_2-1/4;F_2+1/4]\cap[0;1]\). Il contient \(p=1/2\) uniquement lorsque \(F_2=1/2\), donc cette procédure a ici couverture \(1/2\). Le paramètre n’a pas changé entre les trois issues.
Nouvel essai. Fixons \(p=1/4\), faisons un seul essai et construisons \([F_1-1/4;F_1+1/4]\cap[0;1]\). Quelle est la couverture ? Correction. Si l’essai échoue, \(F_1=0\) et l’intervalle \([0;1/4]\) contient \(p\). Cette issue a probabilité \(3/4\). En cas de succès, \(F_1=1\) et l’intervalle \([3/4;1]\) ne contient pas \(p\). La couverture vaut donc \(3/4\). Ces deux petites procédures servent à comprendre la notion ; elles ne sont pas présentées comme les procédures de risque \(5\,\%\) du théorème.
Retour. Pour l’intervalle observé \([0{,}58;0{,}68]\), la garantie vient de la procédure qui a servi à le produire, avant observation. Une fois cet intervalle fixé, on ignore éventuellement s’il contient \(p\), mais cette ignorance ne définit pas une loi de probabilité sur \(p\).
Augmenter la taille ne répare pas un mauvais échantillonnage
Exemple de référence 10.14 — Une moyenne précise autour du mauvais centre
Une population fictive est divisée en deux groupes de même taille. La proportion de personnes possédant une caractéristique est \(0{,}8\) dans le premier groupe et \(0{,}2\) dans le second. La proportion dans l’ensemble est \[p=\frac12\times0{,}8+\frac12\times0{,}2 =0{,}4+0{,}1=0{,}5.\] Si l’on échantillonne uniquement le premier groupe, des essais indépendants dans ce groupe ont pour probabilité \(0{,}8\). Leurs fréquences se concentrent autour de \(0{,}8\), pas autour de \(0{,}5\). Un très grand échantillon peut donc donner une estimation très stable du mauvais paramètre pour la question posée.
La loi des grands nombres ne garantit pas la représentativité. Elle s’applique au modèle des observations réellement recueillies. Une absence d’indépendance, une population mal définie ou une sélection systématique doivent être étudiées avant d’utiliser la formule. Un tirage sans remise dans une population finie n’est pas une succession exactement indépendante ; une approximation éventuelle doit être annoncée et justifiée, non cachée.
À toi 10.15 — Une variation de modèle, pas seulement de nombres
Pour connaître une proportion dans tout un établissement, on interroge uniquement les personnes présentes à une activité facultative. On répète très souvent cette collecte. Peut-on garantir la précision sur la proportion de tout l’établissement par le seul choix d’un grand \(n\) ? Correction. Non. Les personnes présentes peuvent ne pas représenter le même modèle que toutes les personnes de l’établissement. Répéter la collecte peut réduire la fluctuation autour de la proportion du groupe sélectionné sans corriger l’écart avec la population visée. Il faut d’abord décrire et discuter la sélection ; la taille ne remplace pas cette analyse.
Exemple de référence 10.16 — Lire des ordres de grandeur sans les confondre avec des mesures réelles
Au risque \(\alpha=0{,}05\), le rayon universel vaut \(r=\sqrt{1/(4n\times0{,}05)}=\sqrt{5/n}\). Voici trois tailles fictives servant seulement à comparer les échelles :
| Taille \(n\) | Rayon \(r\) approché | En points de pourcentage |
|---|---|---|
| \(1\,000\) | \(0{,}0707107\) | \(7{,}07107\) |
| \(10^6\) | \(0{,}00223607\) | \(0{,}223607\) |
| \(10^{12}\) | \(0{,}00000223607\) | \(0{,}000223607\) |
Lecture. Un écart de proportion \(0{,}02\) correspond à \(2\) points de pourcentage, car \(0{,}02\times100=2\). Pour passer d’une ligne à une autre, le facteur dépend de la racine de la taille, pas directement de la taille.
Ces valeurs ne décrivent ni un sondage réellement effectué ni une expérience physique réelle. Dans toute application, il reste à définir l’événement, la bonne variable de Bernoulli et l’indépendance adaptée. La concentration permet de comparer les ordres de grandeur sous le modèle ; elle ne certifie pas les hypothèses d’une autre discipline.
À toi 10.17 — À reprendre plus tard, avant relecture
On observe \(50\) succès parmi \(2\,500\) essais répondant aux hypothèses. Au risque \(\alpha=0{,}04\), calculer la fréquence, le rayon prudent et l’intervalle observé. Formuler correctement la couverture. Indice. Calculer d’abord \(4\times2500\times0{,}04\) ; recouper l’intervalle avec \([0;1]\). Correction. La fréquence vaut \(50/2500=0{,}02\). Le produit vaut \(400\), d’où \(r=\sqrt{1/400}=0{,}05\). L’intervalle initial est \([-0{,}03;0{,}07]\) ; après intersection, on obtient \([0;0{,}07]\). La procédure possède, sous les hypothèses, une couverture d’au moins \(1-0{,}04=0{,}96\). Une réponse complète ne confond pas cette propriété de procédure avec la certitude que l’intervalle particulier contient \(p\).
Synthèse 10.18 — Une estimation n’est pas une mesure sans incertitude
Le paramètre est fixé ; la fréquence et l’intervalle varient avant observation. La borne universelle fournit une garantie prudente sous les hypothèses du modèle. Plus de données réduit la fluctuation d’échantillonnage, mais ne corrige pas automatiquement un biais de sélection. Ne remplace pas une variance inconnue par une quantité observée en lui attribuant sans preuve la même garantie.
11. Compléments facultatifs : Markov et portée des bornes
Objectif. Découvrir une autre inégalité de probabilité, comprendre ce qui rend une borne parfois atteinte, et distinguer une garantie universelle d’un calcul exact.
Remarque 11.1 — Une unité facultative, indépendante du parcours principal
Cette unité est un complément autorisé pour aller un peu au-delà du noyau du chapitre. L’inégalité de Markov et les constructions qui suivent ne sont pas nécessaires pour utiliser les résultats principaux : Bienaymé–Tchebychev et la concentration ont une justification propre dans le cours.
Les variables considérées ici ont un nombre fini de valeurs. On rappelle localement tous les outils utilisés. Tu peux travailler les unités principales et le bilan sans apprendre ce complément.
Rappel 11.2 — Espérance, variance et événements inclus
Si une variable \(X\) prend les valeurs \(x_i\) avec probabilités \(q_i\), alors \(\operatorname{E}(X)=x_1q_1+\cdots+x_rq_r\). En notant \(\mu=\operatorname{E}(X)\), \[\operatorname{V}(X)=(x_1-\mu)^2q_1+\cdots+(x_r-\mu)^2q_r =\operatorname{E}((X-\mu)^2).\] Chaque probabilité est positive ou nulle ; leur somme vaut \(1\). Une variable est non négative si toutes ses valeurs sont positives ou nulles.
Si tout résultat réalisant un événement \(A\) réalise aussi un événement \(B\), alors \(A\subset B\) et \(\mathbb{P}(A)\leq\mathbb{P}(B)\). Une majoration d’un grand événement est donc aussi une majoration de ses sous-événements. Cette propriété ne permet pas de remplacer une inclusion par une égalité.
Repérage : que permet la seule moyenne ?
À toi 11.3 — Deux quantités de même espérance
Une variable \(D\) représente une durée, toujours positive ou nulle, et vérifie \(\operatorname{E}(D)=6\) minutes. Une autre variable \(G\) représente un gain algébrique, qui peut être négatif, et vérifie \(\operatorname{E}(G)=6\) euros.
Pour laquelle de ces deux variables l’information « elle ne prend jamais de valeur négative » est-elle disponible ? Pourquoi cette différence pourrait-elle compter si l’on cherche à majorer la probabilité de dépasser un seuil positif ? Écris une première réponse avant la suite.
Correction expliquée 11.4 — Des petites valeurs négatives peuvent compenser des grandes positives
La non-négativité est fournie pour \(D\), pas pour \(G\). Une moyenne faible n’interdit pas à une variable signée de prendre souvent de grandes valeurs positives : des valeurs négatives peuvent faire baisser son espérance. Pour une durée non négative, cette compensation n’existe pas.
La preuve qui suit repose exactement sur cette différence. Si tu as seulement regardé les deux espérances égales à \(6\), relis les valeurs que chaque variable est autorisée à prendre : une formule de probabilité dépend aussi de ses hypothèses.
Théorème 11.5 — Inégalité de Markov — complément facultatif
Soit \(Y\) une variable aléatoire à valeurs positives ou nulles, en nombre fini. Pour tout \(a>0\), \[\mathbb{P}(Y\geq a)\leq\frac{\operatorname{E}(Y)}a.\]
Démonstration. Écrivons \(y_1,\ldots,y_r\) ses valeurs et \(q_i=\mathbb{P}(Y=y_i)\). Chaque produit \(y_iq_i\) est positif ou nul. Rangeons d’abord les valeurs au moins égales à \(a\), notées \(y_1,\ldots,y_s\). S’il n’y en a aucune, la probabilité vaut \(0\). Sinon, \[\operatorname{E}(Y)=y_1q_1+\cdots+y_rq_r \geq y_1q_1+\cdots+y_sq_s \geq a(q_1+\cdots+q_s).\] On a supprimé des termes positifs ou nuls, puis utilisé \(y_i\geq a\) et \(q_i\geq0\). La somme des \(s\) probabilités est celle de \(Y\geq a\). On divise les deux membres par le même nombre \(a>0\), sans inverser l’inégalité : \(\operatorname{E}(Y)/a\geq\mathbb{P}(Y\geq a)\). Pourquoi la positivité importe. Si \(Y\) vaut \(-2\) ou \(2\) avec probabilités \(1/2\) et \(1/2\), alors \(\operatorname{E}(Y)=0\), mais \(\mathbb{P}(Y\geq1)=1/2\). La conclusion \(1/2\leq0\) serait fausse : on n’avait pas le droit de supprimer un terme négatif dans la preuve.
Corollaire 11.6 — Une queue stricte est aussi majorée
Si \(Y\) est une variable finie non négative et si \(a>0\), alors \[\mathbb{P}(Y>a)\leq\frac{\operatorname{E}(Y)}a.\]
Démonstration. L’événement \(Y>a\) est inclus dans \(Y\geq a\). Par l’inégalité de Markov, \[\mathbb{P}(Y>a)\leq\mathbb{P}(Y\geq a)\leq\frac{\operatorname{E}(Y)}a.\] Les deux probabilités ne sont pas nécessairement égales. Si \(Y\) est entière et si \(a\) est un entier positif, \(Y>a\) signifie \(Y\geq a+1\) ; Markov donne alors la borne parfois meilleure \(\operatorname{E}(Y)/(a+1)\).
Méthode 11.7 — Identifier le rôle de chaque hypothèse
Je vois une queue supérieure \(Y\geq a\) et je connais seulement une espérance.
Je pense à une possible utilisation de Markov, mais je dois contrôler deux points : \(Y\geq0\) et \(a>0\).
Je fais : je définis \(Y\), je justifie sa non-négativité, je vérifie le seuil, puis je calcule \(\operatorname{E}(Y)/a\). Je termine par « la probabilité est au plus... ». Si ce quotient dépasse \(1\), la borne exploitable est seulement \(1\).
Contrôle. Si la variable peut être négative, je n’applique pas Markov directement. Une transformation pertinente peut parfois produire une variable non négative, mais elle doit aussi transformer l’événement et l’espérance : on ne change pas seulement le nom de la variable.
Exemple de référence 11.8 — Une moyenne de six minutes
On modélise un délai par une variable finie \(D\geq0\) d’espérance \(6\) minutes. On cherche à majorer \(\mathbb{P}(D\geq20)\).
La variable est non négative et le seuil \(20\) est strictement positif. Markov donne \[\mathbb{P}(D\geq20)\leq\frac{\operatorname{E}(D)}{20}=\frac6{20}=\frac3{10}=0{,}3.\] Le risque d’un délai d’au moins vingt minutes est donc au plus \(30\,\%\). On ne sait pas s’il vaut réellement \(30\,\%\).
Pour le voir, deux modèles très différents ont la même espérance :
Si \(D\) vaut toujours \(6\), alors \(\operatorname{E}(D)=6\) et \(\mathbb{P}(D\geq20)=0\).
Si \(D\) vaut \(0\) avec probabilité \(7/10\) et \(20\) avec probabilité \(3/10\), alors \(\operatorname{E}(D)=0\times(7/10)+20\times(3/10)=6\) et \(\mathbb{P}(D\geq20)=3/10\).
Dans le second modèle, la borne est atteinte. Pourtant \(\mathbb{P}(D>20)=0\) : le mot « au moins » et le mot « plus de » ne décrivent pas le même événement.
Proposition 11.9 — Appliquer Markov au carré de l’écart
Soit \(X\) une variable finie, d’espérance \(\mu\) et de variance \(V\). Pour tout \(\delta>0\), \[\mathbb{P}(|X-\mu|\geq\delta)\leq\frac{V}{\delta^2}.\]
Démonstration. La variable \(X\) n’est pas supposée non négative. On construit plutôt \[Y=(X-\mu)^2.\] Un carré est positif ou nul, donc \(Y\) satisfait la condition de Markov. Par définition de la variance, \(\operatorname{E}(Y)=\operatorname{E}((X-\mu)^2)=V\).
Le seuil adapté à \(Y\) est \(\delta^2>0\). Les deux nombres \(|X-\mu|\) et \(\delta\) sont non négatifs ; les élever au carré conserve et reflète leur ordre. Ainsi, \[|X-\mu|\geq\delta \quad\Longleftrightarrow\quad (X-\mu)^2\geq\delta^2 \quad\Longleftrightarrow\quad Y\geq\delta^2.\] On applique maintenant Markov à la bonne variable et au bon seuil : \[\mathbb{P}(|X-\mu|\geq\delta) =\mathbb{P}(Y\geq\delta^2) \leq\frac{\operatorname{E}(Y)}{\delta^2} =\frac{V}{\delta^2}.\] Cette preuve n’exige pas \(X\geq0\) : c’est \(Y=(X-\mu)^2\) qui doit être non négative. Elle donne une seconde explication du résultat, sans remplacer la preuve directe du parcours principal.
Question que tu peux te poser 11.10 — Pourquoi faut-il un carré et un seuil au carré ?
Dans cette preuve, peut-on garder le seuil \(\delta\) après avoir remplacé \(X-\mu\) par \((X-\mu)^2\) ?
Réponse possible. Non. L’événement d’un écart d’au moins \(\delta\) correspond à un carré d’écart d’au moins \(\delta^2\). Par exemple, un écart de \(3\) a pour carré \(9\), pas \(3\). Le carré assure la non-négativité et son espérance est la variance ; il transforme en même temps le seuil.
Critères. Une réponse correcte doit relier trois éléments : la non-négativité, l’identité \(\operatorname{E}((X-\mu)^2)=V\) et l’équivalence des deux événements. Dire seulement « c’est la formule » n’explique pas la preuve.
Une borne générale peut-elle être atteinte ?
Proposition 11.11 — Construire une loi atteignant la borne large
Fixons un réel \(\mu\), un réel \(a>0\) et un réel \(v\) tel que \(0\leq v\leq a^2\). Posons \(r=v/(2a^2)\). Considérons la loi \[\begin{array}{c|ccc} x&\mu-a&\mu&\mu+a\\\hline \mathbb{P}(X=x)&r&1-2r&r \end{array}\] Elle vérifie \[\operatorname{E}(X)=\mu,\qquad \operatorname{V}(X)=v,\qquad \mathbb{P}(|X-\mu|\geq a)=\frac{v}{a^2}, \qquad \mathbb{P}(|X-\mu|>a)=0.\]
Démonstration. Comme \(2a^2>0\), les conditions \(0\leq v\leq a^2\) donnent \(0\leq r\leq1/2\). Les trois probabilités sont donc positives ou nulles, et \[r+(1-2r)+r=1+(r-2r+r)=1.\] La loi est bien définie, y compris si l’une de ses probabilités est nulle.
Développons toutes les contributions à l’espérance : \[\begin{aligned} \operatorname{E}(X) &=(\mu-a)r+\mu(1-2r)+(\mu+a)r\\ &=\mu r-ar+\mu-2\mu r+\mu r+ar\\ &=\mu+(\mu r-2\mu r+\mu r)+(-ar+ar)=\mu. \end{aligned}\] Les écarts à cette espérance sont \(-a\), \(0\) et \(a\) ; leurs carrés sont \(a^2\), \(0\) et \(a^2\). Ainsi, \[\begin{aligned} \operatorname{V}(X)&=a^2r+0\times(1-2r)+a^2r\\ &=2a^2r =2a^2\times\frac{v}{2a^2}=v. \end{aligned}\] La simplification est permise puisque \(2a^2\) est non nul.
L’événement \(|X-\mu|\geq a\) contient les deux valeurs de bord \(\mu-a\) et \(\mu+a\), mais pas la valeur centrale puisque \(a>0\). Sa probabilité vaut \[r+r=2r=2\times\frac{v}{2a^2}=\frac{v}{a^2}.\] La borne de Bienaymé–Tchebychev est donc atteinte. En revanche, aucun des trois écarts possibles n’est strictement supérieur à \(a\), donc \(\mathbb{P}(|X-\mu|>a)=0\).
Lecture. Les deux valeurs extérieures sont à distance exactement \(a\) de \(\mu\) : elles sont comptées pour l’événement \(|X-\mu|\geq a\), pas pour \(|X-\mu|>a\). Dans l’exemple \(\mu=10\), \(a=2\), \(v=2\), les probabilités en \(8\), \(10\) et \(12\) sont \(1/4\), \(1/2\) et \(1/4\).
Exemple de référence 11.12 — Même espérance, même variance, probabilités différentes
Prenons \(\mu=10\), \(a=2\) et \(v=2\). Alors \[r=\frac{2}{2\times2^2}=\frac{2}{8}=\frac14, \qquad 1-2r=1-\frac24=\frac12.\] La loi de \(X\) est donc : \(8\) avec probabilité \(1/4\), \(10\) avec probabilité \(1/2\), \(12\) avec probabilité \(1/4\). Contrôlons numériquement : \[\operatorname{E}(X)=8\times\frac14+10\times\frac12+12\times\frac14 =2+5+3=10,\] \[\operatorname{V}(X)=(-2)^2\times\frac14+0^2\times\frac12+2^2\times\frac14 =1+0+1=2.\] La probabilité \(\mathbb{P}(|X-10|\geq2)\) vaut \(1/4+1/4=1/2\), exactement la borne \(2/2^2=1/2\).
Considérons maintenant une autre variable \(Z\), prenant \(10-\sqrt2\) et \(10+\sqrt2\), chacune avec probabilité \(1/2\). Son espérance est \[\frac{10-\sqrt2}{2}+\frac{10+\sqrt2}{2} =\frac{20}{2}=10.\] Les deux carrés des écarts valent \(2\), donc \(\operatorname{V}(Z)=2\times(1/2)+2\times(1/2)=2\). Pourtant, puisque \(\sqrt2<2\), les deux valeurs sont à distance strictement inférieure à \(2\) de \(10\) : \[\mathbb{P}(|Z-10|\geq2)=0.\] La même borne \(1/2\) est exacte pour une loi et très large pour l’autre. L’espérance et la variance ne déterminent pas à elles seules la probabilité de chaque événement.
Corollaire 11.13 — « Universelle » ne signifie pas « précise pour chaque loi »
On ne peut pas remplacer le coefficient \(1\) par une constante \(c<1\) dans la formule \[\mathbb{P}(|X-\operatorname{E}(X)|\geq a)\leq c\,\frac{\operatorname{V}(X)}{a^2}\] et espérer qu’elle reste vraie pour toutes les variables finies et tous les seuils \(a>0\).
Démonstration. Pour la variable \(X\) de l’exemple précédent, la probabilité vaut \(1/2\) et \(\operatorname{V}(X)/a^2=1/2\). La nouvelle formule imposerait \(1/2\leq c/2\). En multipliant par \(2>0\), on obtiendrait \(1\leq c\), ce qui contredit \(c<1\).
Cela n’empêche pas de trouver une meilleure borne lorsque l’on connaît davantage d’informations sur une loi particulière. Le calcul exact pour \(Z\) en est un exemple. Le résultat porte ici sur la frontière large \(\geq\) ; le cas strict \(>\) doit toujours être lu avec son propre événement.
Essais et choix de méthode
À toi 11.14 — Comparer une garantie et la loi complète
Une variable \(Y\) prend les valeurs \(0\), \(6\) et \(12\) avec probabilités respectives \(1/2\), \(1/3\) et \(1/6\).
Vérifie que ces probabilités forment une loi et calcule \(\operatorname{E}(Y)\).
Majore \(\mathbb{P}(Y\geq8)\) avec Markov, puis calcule cette probabilité exactement.
Pourquoi les deux résultats peuvent-ils différer ?
Indice après une tentative. Pour le calcul exact, regarde quelles valeurs de la table vérifient vraiment \(Y\geq8\). Pour Markov, seules la non-négativité et l’espérance sont utilisées.
Correction expliquée 11.15 — Ne pas confondre deux informations
Les trois probabilités sont positives et \[\frac12+\frac13+\frac16=\frac36+\frac26+\frac16=1.\] L’espérance vaut \[\operatorname{E}(Y)=0\times\frac12+6\times\frac13+12\times\frac16=0+2+2=4.\] Comme \(Y\geq0\) et \(8>0\), Markov donne \(\mathbb{P}(Y\geq8)\leq4/8=1/2\). Mais dans la loi fournie, seule la valeur \(12\) atteint le seuil \(8\) ; la probabilité exacte vaut donc \(1/6\).
Il n’y a aucune contradiction : \(1/6\leq1/2\). La loi complète contient davantage d’informations que sa seule espérance. Affirmer que la probabilité vaut \(1/2\) aurait, en revanche, été faux.
À toi 11.16 — À résoudre sans consulter
Une variable finie \(W\), qui peut être négative, a pour espérance \(7\) et pour variance \(9\). On souhaite majorer \(\mathbb{P}(|W-7|\geq6)\) en utilisant Markov.
Quelle variable faut-il construire ? Quel est le seuil correspondant ? Rédige le raisonnement complet, puis explique pourquoi le signe éventuel de \(W\) ne bloque pas la démarche.
Remarque 11.17 — Un indice si le départ résiste
Cherche une variable toujours positive ou nulle dont l’espérance est fournie par la variance de \(W\). Le seuil \(6\) pour un écart devient \(36\) pour son carré.
Correction expliquée 11.18 — La transformation répare la condition de signe
On pose \(Y=(W-7)^2\). C’est une variable non négative et \[\operatorname{E}(Y)=\operatorname{E}((W-\operatorname{E}(W))^2)=\operatorname{V}(W)=9.\] Le seuil est \(6^2=36>0\). Comme \(|W-7|\geq6\) équivaut à \((W-7)^2\geq36\), \[\mathbb{P}(|W-7|\geq6)=\mathbb{P}(Y\geq36)\leq\frac9{36}=\frac14.\] Markov n’a pas été appliqué à \(W\), mais à \(Y\). Des valeurs négatives de \(W\) ne posent donc pas de problème.
Critères. Il faut donner la définition de \(Y\), sa non-négativité, son espérance, le seuil \(36\) et l’égalité des événements. Le résultat \(1/4\) seul ne montre pas que la condition essentielle a été comprise.
À toi 11.19 — Une borne inférieure connue peut aussi servir
Une variable finie \(X\) vérifie \(X\geq-5\) et \(\operatorname{E}(X)=1\). Cherche une majoration de \(\mathbb{P}(X\geq7)\) à l’aide de Markov. On n’a pas le droit de supposer \(X\geq0\).
Indice. Ajoute la même constante à la variable et au seuil pour obtenir une variable non négative.
Correction expliquée 11.20 — Déplacer à la fois la variable et l’événement
Posons \(Y=X+5\). Puisque \(X\geq-5\), on a \(Y\geq0\). Par linéarité de l’espérance, \(\operatorname{E}(Y)=\operatorname{E}(X)+5=6\).
L’événement \(X\geq7\) devient \(X+5\geq7+5\), donc \(Y\geq12\). Le seuil \(12\) est positif et Markov donne \[\mathbb{P}(X\geq7)=\mathbb{P}(Y\geq12)\leq\frac6{12}=\frac12.\] Employer \(\operatorname{E}(X)/7=1/7\) aurait ignoré la condition de non-négativité. Modifier seulement le seuil ou seulement la moyenne aurait également changé le problème.
Réparer un raisonnement et le réinvestir
Point de vigilance 11.21 — Une probabilité négative révèle une hypothèse oubliée
Une variable \(G\) vaut \(-3\) ou \(1\), chacune avec probabilité \(1/2\). Un élève calcule \(\operatorname{E}(G)=-1\) puis écrit \(\mathbb{P}(G\geq1)\leq-1\).
Première erreur. La division est possible, mais Markov n’était pas applicable à \(G\), qui prend une valeur négative. La probabilité exacte vaut d’ailleurs \(1/2\), et une probabilité ne peut pas être inférieure à \(-1\).
Rappel. On peut supprimer des contributions dans une somme pour la minorer seulement si ces contributions sont positives ou nulles. C’est cette étape de la preuve de Markov qui échoue ici.
Exemple simple corrigé. Une variable \(H\) valant \(0\) ou \(4\) avec probabilités \(1/2\) et \(1/2\) est non négative et d’espérance \(2\). Pour \(4>0\), Markov donne \(\mathbb{P}(H\geq4)\leq2/4=1/2\), ici exactement la probabilité calculée dans la loi.
Nouvel essai, avant la réponse. Pour \(G\) ci-dessus, pose \(H=G+3\). Quelles valeurs prend \(H\) ? À quel événement sur \(H\) correspond \(G\geq1\) ?
Correction du nouvel essai. Les valeurs deviennent \(0\) et \(4\). L’événement devient \(H\geq4\) et l’espérance devient \(-1+3=2\). On retrouve la borne \(1/2\) de l’exemple simple.
Retour au problème. La bonne démarche ne consiste pas à remplacer une réponse négative par \(0\) : elle consiste à vérifier les hypothèses, construire une variable admissible et transformer l’événement de façon équivalente.
À toi 11.22 — À reprendre plus tard, avant de relire les preuves
On donne une variable \(X\) prenant les valeurs \(2\), \(5\) et \(8\) avec probabilités \(1/6\), \(2/3\) et \(1/6\).
Calcule \(\operatorname{E}(X)\) et \(\operatorname{V}(X)\) à partir de la loi.
Calcule exactement \(\mathbb{P}(|X-5|\geq3)\) et \(\mathbb{P}(|X-5|>3)\).
Compare la première probabilité à la borne de Bienaymé–Tchebychev et explique ce que prouve cette comparaison.
Aide après une tentative. Les trois écarts à \(5\) sont \(-3\), \(0\) et \(3\) ; vérifie d’abord que \(5\) est bien l’espérance, puis observe si les valeurs sur la frontière sont admises dans chaque événement.
Correction expliquée 11.23 — Les deux bords portent toute la probabilité de queue
Les probabilités totalisent \(1/6+4/6+1/6=1\). L’espérance est \[\operatorname{E}(X)=2\times\frac16+5\times\frac23+8\times\frac16 =\frac26+\frac{20}{6}+\frac86=\frac{30}{6}=5.\] La variance est \[\operatorname{V}(X)=(2-5)^2\times\frac16+(5-5)^2\times\frac23+(8-5)^2\times\frac16 =\frac96+0+\frac96=3.\] Les valeurs \(2\) et \(8\) sont à distance exactement \(3\) de \(5\). Elles sont incluses dans l’événement large, donc \(\mathbb{P}(|X-5|\geq3)=1/6+1/6=1/3\). Aucune valeur n’est à distance strictement supérieure à \(3\) : \(\mathbb{P}(|X-5|>3)=0\).
La borne de Tchebychev est \(V/3^2=3/9=1/3\) : elle est atteinte pour l’événement large. Cela montre qu’une borne générale peut être exacte ; cela ne dit pas qu’elle l’est pour toutes les lois.
Orientation. Si les deux probabilités ont été confondues, teste une valeur de bord, ici \(2\), dans chacun des événements. Si la variance pose problème, écris les trois écarts, puis leurs carrés, avant d’appliquer les probabilités. Si la conclusion annonce une égalité universelle, compare les deux lois de mêmes moments étudiées dans cette unité.
Synthèse 11.24 — Ce que ce complément apporte
Markov utilise une variable non négative, une espérance et un seuil positif. Appliqué au carré de l’écart à l’espérance, il redonne Tchebychev. Une loi à trois points montre qu’une borne universelle peut être atteinte ; une autre loi de mêmes moments montre qu’elle peut aussi être très large.
Le bon réflexe demeure le même : nommer la variable, contrôler les hypothèses, traduire l’événement avec ses frontières, puis distinguer calcul exact et garantie. Aucune démonstration de ce complément n’autorise à remplacer automatiquement une inégalité par une égalité.
12. Synthèse, choix de méthode et bilan corrigé
Objectif. Mobiliser les résultats du chapitre sans confondre variable, événement, borne et observation ; vérifier tes choix sur un bilan entièrement corrigé.
Le noyau du chapitre, avec ses conditions
Rappel 12.1 — Les résultats dont tu peux avoir besoin ici
Dans cette unité, les variables sont finies. Pour une variable \(X\) de valeurs \(x_i\) et de probabilités \(q_i\), on note \[\mu=\operatorname{E}(X)=\sum_{i=1}^r x_iq_i,\qquad V=\operatorname{V}(X)=\sum_{i=1}^r(x_i-\mu)^2q_i,\qquad \sigma=\sqrt V.\] La somme signifie qu’on additionne les contributions pour toutes les valeurs possibles. La variance est positive ou nulle ; ses unités sont celles de \(X\) élevées au carré.
Pour une variable et un seuil \(\delta>0\) : \[\mathbb{P}(|X-\mu|\geq\delta)\leq\frac{V}{\delta^2}, \qquad \mathbb{P}(\mu-\delta<X<\mu+\delta)\geq1-\frac{V}{\delta^2}.\] Il s’agit de l’inégalité de Bienaymé–Tchebychev et de sa conséquence par complément. Une borne de queue supérieure à \(1\) n’apporte rien de plus que \(\mathbb{P}(A)\leq1\).
Pour un échantillon : \(X_1,\ldots,X_n\) sont indépendantes, de même loi d’espérance \(\mu\) et de variance \(V\), et \(n\geq1\). Alors \[S_n=X_1+\cdots+X_n,\qquad M_n=\frac{S_n}{n},\] \[\operatorname{E}(S_n)=n\mu,\quad \operatorname{V}(S_n)=nV,\quad \operatorname{E}(M_n)=\mu,\quad \operatorname{V}(M_n)=\frac Vn,\quad \sigma(M_n)=\frac{\sigma}{\sqrt n}.\] L’espérance est linéaire. L’additivité de la variance est utilisée sous indépendance ; c’est un résultat antérieur admis au niveau. La multiplication par \(1/n\) multiplie une variance par \(1/n^2\).
Concentration, puis loi des grands nombres : \[\mathbb{P}(|M_n-\mu|\geq\delta)\leq\frac{V}{n\delta^2}, \qquad \lim_{n\to+\infty}\mathbb{P}(|M_n-\mu|\geq\delta)=0 \quad(\delta>0\text{ fixé}).\] Pour garantir un risque au plus \(\alpha\in]0;1[\), il suffit que \(V/(n\delta^2)\leq\alpha\). Le plus petit entier satisfaisant cette condition n’est pas nécessairement le plus petit effectif pour la probabilité réelle.
Fréquence : si \(Y_i\) code par \(0\) ou \(1\) la réalisation d’un événement de probabilité \(p\) et si les essais sont indépendants de même probabilité, alors \[F_n=\frac{Y_1+\cdots+Y_n}{n},\quad \operatorname{E}(F_n)=p,\quad \operatorname{V}(F_n)=\frac{p(1-p)}n,\] \[\mathbb{P}(|F_n-p|\geq\delta) \leq\frac{p(1-p)}{n\delta^2} \leq\frac1{4n\delta^2}.\] La dernière borne utilise \(p(1-p)\leq1/4\), pas l’hypothèse \(p=1/2\).
Loi binomiale : le nombre \(S_n\) de succès de \(n\) essais indépendants de même probabilité \(p\in[0;1]\) suit \(\mathcal{B}(n;p)\). Lorsque \(0<p<1\), pour \(0\leq k\leq n\) entier, \[\mathbb{P}(S_n=k)=\binom nk p^k(1-p)^{n-k},\quad \operatorname{E}(S_n)=np,\quad\operatorname{V}(S_n)=np(1-p).\] Les formules d’espérance et de variance restent valables aux extrémités. Pour \(p=0\), on a \(S_n=0\) avec probabilité \(1\) ; pour \(p=1\), on a \(S_n=n\) avec probabilité \(1\). On traite ces cas directement, sans utiliser une expression \(0^0\).
Pour une probabilité exacte sur plusieurs valeurs, on additionne les termes concernés ; une simulation fournit seulement une fréquence observée.
Série de moyennes simulées : pour \(N\geq1\) nombres \(m_1,\ldots,m_N\), leur moyenne est \(\overline m=(m_1+\cdots+m_N)/N\). L’écart-type de cette série, avec le diviseur \(N\), est \[s=\sqrt{\frac{(m_1-\overline m)^2+\cdots+(m_N-\overline m)^2}{N}}.\] Le centre est la moyenne de la série réellement obtenue, pas l’espérance théorique imposée de l’expérience.
Synthèse 12.2 — Quatre événements à distinguer
Pour un réel \(\mu\) et \(\delta>0\) : \[\begin{array}{c|c} \text{Écart}&\text{Traduction}\\\hline |X-\mu|<\delta&\mu-\delta<X<\mu+\delta\\ |X-\mu|\leq\delta&\mu-\delta\leq X\leq\mu+\delta\\ |X-\mu|\geq\delta&X\leq\mu-\delta\ \text{ou}\ X\geq\mu+\delta\\ |X-\mu|>\delta&X<\mu-\delta\ \text{ou}\ X>\mu+\delta \end{array}\] Les première et troisième lignes sont contraires ; les deuxième et quatrième le sont aussi. Si \(X\) est entière, on ajuste ensuite les bornes aux valeurs entières réellement possibles. On ne change pas les extrémités avant d’avoir traduit l’événement.
Méthode 12.3 — Décider à partir de ce qui est connu
| Ce que la question fournit ou demande | Premier geste utile |
|---|---|
| Une variable, son espérance et sa variance | Traduire l’événement en écart à l’espérance ; envisager Tchebychev. |
| La moyenne d’essais indépendants de même loi | Écrire \(M_n\) et identifier la variance individuelle \(V\) ; utiliser \(V/n\). |
| Une proportion d’essais répondant à une condition | Construire le code \(0/1\) de cette condition, puis sa fréquence. |
| Une taille à choisir pour une tolérance et un risque | Résoudre une condition suffisante, puis traiter l’entier et le signe strict ou large. |
| Une loi connue et une probabilité exacte | Énumérer les valeurs de l’événement et additionner leurs probabilités. |
| Des moyennes obtenues par simulation | Distinguer la taille de chaque échantillon et leur nombre ; centrer la dispersion observée sur leur moyenne observée. |
| Un comportement lorsque \(n\) augmente | Fixer la tolérance avant d’étudier une limite de probabilités ; distinguer cette limite d’une trajectoire particulière. |
Je vois les données et l’objet demandé ; je pense aux conditions de la méthode ; je fais le premier geste avant toute substitution numérique. Une formule qui donne un nombre plausible ne valide pas à elle seule le modèle.
Dix situations à examiner avant les indices et les solutions
Remarque 12.4 — Mode d’emploi du bilan
Commence par une tentative sans consulter les corrections. Pour chaque question, écris la variable, l’événement, les conditions utilisées et une phrase de conclusion. Tu peux revenir aux rappels de cette unité en cas de blocage, puis refaire la question sans les relire.
Les indices sont regroupés après les dix énoncés, et les solutions après les indices. Un résultat numérique juste sans choix expliqué ne suffit pas pour vérifier la compréhension. Le bilan ne prétend pas constater une maîtrise tant qu’il n’a pas réellement été réalisé et examiné.
À toi 12.5 — 1. Un relevé entier
Une variable \(N\) prend des valeurs entières. Traduis chacun des événements suivants par des bornes entières : \[A:\ |N-12|<3,\qquad B:\ |N-12|\geq3,\qquad C:\ |N-12|>3.\] Quels sont les événements contraires parmi ces trois ? Teste la valeur \(N=9\) pour vérifier tes réponses.
À toi 12.6 — 2. Une annonce à évaluer
Une variable finie \(X\) a pour espérance \(50\) et pour variance \(16\). Un élève affirme : « La probabilité d’un écart d’au moins \(8\) à la moyenne est exactement \(1/4\). »
Corrige ce qui doit l’être. Explique, à partir de la définition de la variance comme somme pondérée des carrés des écarts, pourquoi on obtient une majoration. Il ne suffit pas de citer le nom d’une formule.
À toi 12.7 — 3. Une zone de réglage
Une variable finie \(X\) a pour espérance \(40\) et pour écart-type \(3\). On cherche une garantie pour l’événement \[32<X<45.\] Propose une minoration de sa probabilité à partir de ces seules informations, en expliquant le choix de l’événement auquel tu appliques le résultat du cours. Les extrémités ne sont pas à la même distance de l’espérance.
À toi 12.8 — 4. Cent mesures
Les variables \(X_1,\ldots,X_{100}\) sont indépendantes, de même loi d’espérance \(80\) et de variance \(25\). On note \(S=X_1+\cdots+X_{100}\) et \(M=S/100\).
Calcule \(\operatorname{E}(S)\), \(\operatorname{V}(S)\), \(\operatorname{E}(M)\), \(\operatorname{V}(M)\) et \(\sigma(M)\). Puis majore \(\mathbb{P}(|M-80|\geq1)\). Explique pourquoi utiliser \(25\) comme variance de \(M\) serait une erreur.
À toi 12.9 — 5. Une règle d’effectif
On dispose d’observations indépendantes de même loi, de variance \(9\). Leur moyenne est \(M_n\) et leur espérance commune est \(\mu\). On veut contrôler les écarts d’au moins \(1{,}5\).
Trouve le plus petit entier \(n\) pour lequel la borne de concentration garantit un risque au plus égal à \(0{,}05\).
Reprends la question pour un risque strictement inférieur à \(0{,}05\).
Ces effectifs sont-ils nécessairement minimaux pour la probabilité réelle ? Justifie.
À toi 12.10 — 6. Une phrase sur le long terme
Les observations sont indépendantes, de même loi finie, d’espérance \(\mu\) et de variance \(2\). Leur moyenne est \(M_n\).
Démontre que \(\mathbb{P}(|M_n-\mu|\geq0{,}2)\) tend vers \(0\) lorsque \(n\) tend vers \(+\infty\).
Cette conclusion affirme-t-elle que \(|M_{n+1}-\mu|\leq|M_n-\mu|\) à chaque nouvelle observation ?
Lors de lancers indépendants d’une pièce équilibrée, une longue série de piles rend-elle face plus probable au lancer suivant ? Explique le lien, ou l’absence de lien, avec la loi des grands nombres.
À toi 12.11 — 7. Un protocole en deux étapes
Chaque opération comporte deux étapes indépendantes. Chaque étape réussit avec probabilité \(0{,}6\). L’opération est validée si les deux étapes réussissent. On effectue \(400\) opérations indépendantes selon ce même protocole.
Définis la variable individuelle à utiliser pour étudier la proportion d’opérations validées. Calcule sa probabilité de succès et sa variance. Majore ensuite le risque que cette proportion s’écarte de sa probabilité de \(0{,}1\) ou davantage.
Un camarade utilise à la place la variance du nombre d’étapes réussies dans une opération. Explique pourquoi il a changé la question.
À toi 12.12 — 8. Deux façons d’obtenir un nombre
La variable \(S\) suit la loi binomiale \(\mathcal{B}(9;1/3)\). On veut calculer \[\mathbb{P}\bigl(|S-3|>\sqrt9\bigr).\]
Donne la liste exacte des valeurs de \(S\) dans cet événement.
Calcule sa probabilité exacte, sous forme d’une fraction. Tu peux utiliser \(\binom97=36\), \(\binom98=9\) et \(\binom99=1\).
Compare cette valeur à une borne de Bienaymé–Tchebychev. La borne répond-elle à la demande « calculer exactement » ?
À toi 12.13 — 9. Quatre moyennes enregistrées
On a simulé \(N=4\) échantillons, chacun de taille \(n=25\), d’une loi d’espérance \(\mu=2\) et de variance \(36\). Les quatre moyennes enregistrées sont \[1\ ;\ 2\ ;\ 4\ ;\ 5.\]
Calcule la moyenne puis l’écart-type de cette série de quatre nombres, avec le diviseur \(N\).
Le programme ci-dessous calcule-t-il cet écart-type ? Sinon, explique puis corrige son principe.
Compare l’écart-type observé à l’écart-type théorique de la moyenne d’un échantillon de taille \(25\). Leur différence réfute-t-elle le résultat théorique ?
from math import sqrt

def dispersion(moyennes, mu):
    N = len(moyennes)
    carres = 0
    for m in moyennes:
        carres = carres + (m - mu)**2
    return sqrt(carres / N)
On suppose ici la liste non vide. Le mot « observé » concerne les valeurs simulées, pas une preuve de l’identité théorique.
À toi 12.14 — 10. Un déplacement sur une droite
On part de la position \(0\). À chaque étape, on effectue un pas de \(+1\) ou de \(-1\), avec probabilités \(1/2\) et \(1/2\), indépendamment des autres pas. Après \(36\) pas, on note \(D\) le nombre de pas vers la droite et \(T\) la position finale.
Exprime \(T\) en fonction de \(D\), puis calcule son espérance et sa variance.
Propose une majoration de \(\mathbb{P}(|T|\geq12)\).
Écris un programme qui renvoie la position finale après \(n\) pas. Pour vérifier les mises à jour, donne à la main les positions successives correspondant aux cinq pas \(-1,+1,+1,-1,+1\).
Indices : à utiliser après une vraie tentative
Remarque 12.15 — Un point de départ, sans remplacer le raisonnement
Traduis d’abord avec les bornes réelles \(9\) et \(15\) ; adapte ensuite aux entiers.
Parmi les carrés des écarts, ceux correspondant à un écart d’au moins \(8\) valent au moins \(64\).
Cherche un intervalle centré en \(40\) entièrement contenu dans \(]32;45[\).
Pour la moyenne, le coefficient est \(1/100\) et son carré \(1/10000\).
La borne se simplifie en \(4/n\). Multiplie les deux membres par \(n>0\) avant de traiter l’entier.
Avec le seuil fixé \(0{,}2\), la borne est \(50/n\). Une limite de probabilités n’est pas une comparaison de deux observations successives.
Une opération validée apporte \(1\), les autres apportent \(0\). Il faut réussir les deux étapes, pas en compter le nombre.
\(\sqrt9=3\) ; teste les valeurs de bord \(S=0\) et \(S=6\) dans l’événement strict.
Le centre de la série des quatre moyennes doit être calculé à partir de ces quatre nombres. Il n’est pas imposé égal à \(\mu\).
Il y a \(D\) pas vers la droite et \(36-D\) vers la gauche. Une simulation doit tirer un nouveau pas à chaque passage dans la boucle.
Corrections expliquées et critères de réussite
Correction expliquée 12.16 — 1. Les extrémités décident
L’événement \(|N-12|<3\) signifie \(-3<N-12<3\). Ajouter \(12\) aux trois membres donne \(9<N<15\). Puisque \(N\) est entier, \[A:\ 10\leq N\leq14.\] Pour l’événement large extérieur, \[B:\ N\leq9\ \text{ou}\ N\geq15.\] Pour l’extérieur strict, on obtient d’abord \(N<9\) ou \(N>15\), puis, puisque \(N\) est entier, \[C:\ N\leq8\ \text{ou}\ N\geq16.\] \(A\) et \(B\) sont contraires. Le contraire de \(C\) serait \(9\leq N\leq15\), qui n’est pas \(A\). Pour \(N=9\), l’écart vaut \(|9-12|=3\) : cette valeur appartient à \(B\), mais ni à \(A\) ni à \(C\).
Critères. Les bornes de chaque événement et le test de \(9\) doivent être cohérents. Si tu as seulement décalé toutes les bornes d’une unité, reprends le passage en deux temps : inégalité réelle, puis valeurs entières possibles.
Correction expliquée 12.17 — 2. Une majoration, pas une égalité
La conclusion correcte est \[\mathbb{P}(|X-50|\geq8)\leq\frac{16}{8^2}=\frac{16}{64}=\frac14.\] Voici pourquoi. Notons \(x_i\) les valeurs de \(X\) et \(q_i\) leurs probabilités. La variance est la somme des termes \((x_i-50)^2q_i\), tous positifs ou nuls. Conservons seulement ceux pour lesquels \(|x_i-50|\geq8\). Supprimer les autres ne peut pas augmenter la somme.
Si aucune valeur ne remplit la condition, la probabilité cherchée est nulle et la borne est immédiate. Sinon, nommons \(x_1,\ldots,x_s\) les valeurs concernées. Pour chacune, \((x_i-50)^2\geq64\), donc \[16=\operatorname{V}(X)\geq (x_1-50)^2q_1+\cdots+(x_s-50)^2q_s \geq64(q_1+\cdots+q_s).\] Les événements \(X=x_i\) sont disjoints ; la somme \(q_1+\cdots+q_s\) est donc \(\mathbb{P}(|X-50|\geq8)\). On divise par \(64>0\), sans changer le sens de l’inégalité. On obtient un majorant, pas une égalité : des termes ont éventuellement été supprimés ou remplacés par des termes plus petits.
Critères. La positivité, le carré \(64\), la somme des probabilités et la division positive doivent être expliqués. Si tu as employé \(4\) au numérateur, tu as confondu l’écart-type \(\sqrt{16}=4\) avec la variance \(16\).
Correction expliquée 12.18 — 3. Une inclusion rend la méthode possible
L’écart-type vaut \(3\), donc la variance vaut \(3^2=9\). Le bord supérieur \(45\) est à distance \(5\) de l’espérance \(40\) ; le bord inférieur \(32\) est à distance \(8\). Le rayon \(5\) donne un intervalle centré contenu dans l’intervalle demandé : \[]35;45[\ \subset\ ]32;45[.\] Par le complément de Tchebychev avec le seuil \(5>0\), \[\mathbb{P}(35<X<45)=\mathbb{P}(|X-40|<5) \geq1-\frac9{5^2}=1-\frac9{25}=\frac{16}{25}=0{,}64.\] Tout résultat dans \(]35;45[\) se trouve aussi dans \(]32;45[\). Ainsi, \[\mathbb{P}(32<X<45)\geq\mathbb{P}(35<X<45)\geq0{,}64.\] Ce n’est pas une égalité entre les deux événements : les valeurs de \(]32;35]\) ne sont prises en compte que dans le plus grand.
Critères. Il faut choisir un intervalle centré réellement inclus, écrire la variance \(9\) et justifier l’inclusion de probabilités. Si tu as pris le milieu \(38{,}5\) de l’intervalle demandé, rappelle-toi que la formule donnée centre les écarts sur l’espérance \(40\), pas sur un centre choisi librement.
Correction expliquée 12.19 — 4. Total et moyenne n’ont pas la même dispersion
La linéarité de l’espérance donne \(\operatorname{E}(S)=100\times80=8\,000\). L’indépendance permet de sommer les variances : \(\operatorname{V}(S)=100\times25=2\,500\).
Puisque \(M=S/100\), \[\operatorname{E}(M)=\frac{8\,000}{100}=80, \qquad \operatorname{V}(M)=\left(\frac1{100}\right)^2\times2\,500 =\frac{2\,500}{10\,000}=\frac14.\] Son écart-type est \(\sqrt{1/4}=1/2\). Le seuil demandé est \(1>0\), donc \[\mathbb{P}(|M-80|\geq1)\leq\frac{1/4}{1^2}=\frac14.\] Le nombre \(25\) est la variance d’une mesure individuelle \(X_i\), pas celle de leur moyenne. Le partage par \(100\) se traduit par un partage de la variance de la somme par \(100^2\).
Critères. Les cinq moments et le risque doivent être reliés au bon objet. Si tu as obtenu \(25/10000\), tu as oublié de former d’abord la variance de la somme \(100\times25\) ; si tu as obtenu \(25\), tu as oublié le carré du coefficient de la moyenne.
Correction expliquée 12.20 — 5. Deux signes, deux effectifs
Pour \(n\geq1\), l’indépendance et la même loi donnent la concentration avec variance individuelle \(9\). Comme \(1{,}5^2=2{,}25\), \[\mathbb{P}(|M_n-\mu|\geq1{,}5)\leq\frac9{2{,}25n}=\frac4n.\] Pour un risque au plus \(0{,}05=1/20\), il suffit de résoudre \(4/n\leq1/20\). On multiplie les deux membres par \(20n>0\) : \[\frac4n\times20n\leq\frac1{20}\times20n \quad\Longleftrightarrow\quad80\leq n.\] Le premier entier est \(80\). À cet effectif, la borne vaut \(4/80=1/20\) ; pour \(79\), elle vaut \(4/79>1/20\) car \(80>79\).
Pour un risque strictement inférieur à \(1/20\), la condition devient \(4/n<1/20\), donc \(80<n\). Le premier entier est alors \(81\) ; \(4/81<1/20\) car \(80<81\).
Ces effectifs sont minimaux pour ces conditions sur le majorant. Ils ne prouvent pas la minimalité pour la probabilité réelle, qui peut être beaucoup plus petite que \(4/n\).
Critères. Les opérations sur une quantité positive, la différence entre \(n\geq80\) et \(n>80\), et la réserve de suffisance sont indispensables. Si les deux réponses étaient \(80\), vérifie l’égalité de la borne à cet effectif.
Correction expliquée 12.21 — 6. Une limite n’organise pas chaque prochain résultat
Le seuil \(0{,}2\) est fixé et positif. Comme \(0{,}2^2=0{,}04\), \[0\leq\mathbb{P}(|M_n-\mu|\geq0{,}2) \leq\frac2{0{,}04n}=\frac{50}{n}.\] Le nombre \(50\) ne dépend pas de \(n\), et \(50/n\) tend vers \(0\). Le théorème d’encadrement donne la limite \(0\) pour la probabilité cherchée.
Cela ne compare pas les deux valeurs observées \(|M_n-\mu|\) et \(|M_{n+1}-\mu|\). Une nouvelle observation peut éloigner la moyenne ; le théorème ne prescrit pas l’ordre de ses déplacements. La loi dit que, pour une tolérance fixée, la proportion théorique d’échantillons présentant un grand écart devient petite lorsque leur taille augmente.
Pour la pièce, l’indépendance signifie que les résultats précédents ne modifient pas la probabilité du prochain lancer : face garde la probabilité \(1/2\). La loi des grands nombres ne crée pas un mécanisme qui compenserait les piles déjà obtenus.
Critères. Il faut montrer l’encadrement, expliquer pourquoi le membre droit tend vers \(0\), et distinguer une probabilité d’un parcours réalisé. Si tu as annoncé une amélioration à chaque pas, teste mentalement deux succès de suite après une fréquence déjà trop élevée : une telle suite reste possible.
Correction expliquée 12.22 — 7. Une opération compte une fois, pas deux
Pour l’opération \(i\), on définit \(Y_i=1\) si les deux étapes réussissent et \(Y_i=0\) sinon. L’indépendance des deux étapes donne \[p=0{,}6\times0{,}6=0{,}36=\frac9{25}.\] La loi de \(Y_i\) est donc Bernoulli de paramètre \(9/25\). Son espérance est \(9/25\) et sa variance vaut \[p(1-p)=\frac9{25}\left(1-\frac9{25}\right) =\frac9{25}\times\frac{16}{25}=\frac{144}{625}=0{,}2304.\] Les \(400\) opérations sont indépendantes de même protocole. Leur fréquence \(F_{400}=(Y_1+\cdots+Y_{400})/400\) vérifie \[\mathbb{P}(|F_{400}-0{,}36|\geq0{,}1) \leq\frac{0{,}2304}{400\times0{,}01} =\frac{0{,}2304}{4}=0{,}0576.\] Le risque est au plus \(5{,}76\,\%\). La variance du nombre d’étapes réussies est \(2\times0{,}6\times0{,}4=0{,}48\), mais ce nombre peut valoir \(0\), \(1\) ou \(2\). Le moyenner étudierait le nombre moyen d’étapes réussies, pas la proportion d’opérations validées.
Critères. Il faut distinguer les deux niveaux d’indépendance, définir un code \(0/1\), calculer \(p\) puis sa variance, et donner une borne avec son interprétation. Si tu as obtenu une moyenne pouvant dépasser \(1\) pour la fréquence, vérifie ce que ton compteur additionne.
Correction expliquée 12.23 — 8. Le calcul exact utilise toutes les valeurs de l’événement
On a \(\sqrt9=3\). L’événement strict \(|S-3|>3\) signifie \(S<0\) ou \(S>6\). Une variable binomiale \(\mathcal{B}(9;1/3)\) prend les valeurs entières de \(0\) à \(9\) : l’événement est donc \(S\in\{7,8,9\}\). Les valeurs \(0\) et \(6\), à distance exactement \(3\), sont exclues.
Ces trois possibilités sont disjointes. La formule binomiale donne \[\begin{aligned} \mathbb{P}(S\geq7) &=36\left(\frac13\right)^7\left(\frac23\right)^2 +9\left(\frac13\right)^8\left(\frac23\right) +\left(\frac13\right)^9\\ &=\frac{36\times4}{3^9}+\frac{9\times2}{3^9}+\frac1{3^9}\\ &=\frac{144+18+1}{19683}=\frac{163}{19683}\approx0{,}00828. \end{aligned}\] Les facteurs \(3^7\times3^2\) et \(3^8\times3\) ont tous deux été réunis en \(3^9\), d’où le même dénominateur.
L’espérance vaut \(9\times(1/3)=3\) et la variance \(9\times(1/3)\times(2/3)=2\). Comme l’événement strict est inclus dans l’événement large, \[\mathbb{P}(|S-3|>3)\leq\mathbb{P}(|S-3|\geq3)\leq\frac2{3^2}=\frac29\approx0{,}2222.\] La borne est vraie mais beaucoup plus grande que la probabilité exacte. Elle ne répond pas à elle seule à une demande de calcul exact.
Critères. La liste \(7,8,9\), le traitement de la frontière et la somme exacte doivent apparaître. Si tu as ajouté la valeur \(6\) ou \(0\), remplace \(S\) par cette valeur dans l’inégalité stricte avant de recalculer.
Correction expliquée 12.24 — 9. Le centre doit être celui de la série observée
La moyenne de la série est \[\overline m=\frac{1+2+4+5}{4}=\frac{12}{4}=3.\] Les quatre écarts à ce centre sont \(-2,-1,1,2\) et leurs carrés \(4,1,1,4\). La variance de la série, avec le diviseur \(N=4\), est \[\frac{(1-3)^2+(2-3)^2+(4-3)^2+(5-3)^2}{4} =\frac{4+1+1+4}{4}=\frac52.\] Son écart-type est donc \(s=\sqrt{5/2}\approx1{,}5811\).
Le programme fourni utilise le centre \(\mu=2\). Il calcule plutôt \[\sqrt{\frac{(1-2)^2+(2-2)^2+(4-2)^2+(5-2)^2}{4}} =\sqrt{\frac{1+0+4+9}{4}}=\sqrt{\frac72}\approx1{,}8708.\] Ce résultat mesure un écart quadratique au centre théorique ; ce n’est pas l’écart-type de la série autour de son propre centre.
Voici un calcul corrigé, valable pour une liste non vide :
from math import sqrt

def ecart_type_serie(moyennes):
    N = len(moyennes)
    if N == 0:
        raise ValueError("Liste vide")
    total = 0
    for m in moyennes:
        total = total + m
    centre = total / N
    carres = 0
    for m in moyennes:
        carres = carres + (m - centre)**2
    return sqrt(carres / N)
Dans la première boucle, total passe par \(0,1,3,7,12\). On fixe ensuite centre à \(3\). Dans la seconde boucle, carres passe par \(0,4,5,6,10\). Le centre ne change plus pendant cette seconde boucle.
La variable individuelle a pour écart-type \(\sqrt{36}=6\). L’écart-type théorique de la moyenne d’un échantillon de taille \(25\) est \(6/\sqrt{25}=6/5=1{,}2\). Une série de seulement quatre moyennes n’est pas tenue d’avoir exactement cet écart-type : \(s\) est une statistique calculée sur les simulations obtenues. La différence n’est pas une réfutation de la formule théorique.
Critères. Distinguer \(n=25\) et \(N=4\), calculer \(\overline m=3\) avant les carrés, et donner l’ordre des deux boucles. Si tu as divisé la somme des quatre carrés par \(25\), rappelle-toi que la série étudiée ici contient quatre nombres.
Correction expliquée 12.25 — 10. Compter les pas puis calculer la position
Il y a \(D\) pas de \(+1\) et \(36-D\) pas de \(-1\). La position finale est donc \[T=D\times1+(36-D)\times(-1) =D-36+D=2D-36.\] Le nombre \(D\) suit \(\mathcal{B}(36;1/2)\), car les directions sont indépendantes et équiprobables. Ainsi, \[\operatorname{E}(D)=36\times\frac12=18, \qquad \operatorname{V}(D)=36\times\frac12\times\frac12=9.\] Par transformation affine, \[\operatorname{E}(T)=2\times18-36=0, \qquad \operatorname{V}(T)=2^2\times9=36.\] Le signe moins devant \(36\) ne retire rien à la variance : une translation ne modifie pas la dispersion. Pour le vérifier ici, chaque écart de \(T\) à son espérance est \[(2D-36)-(2\operatorname{E}(D)-36)=2D-36-2\operatorname{E}(D)+36 =2(D-\operatorname{E}(D)).\] Son carré vaut donc \(4(D-\operatorname{E}(D))^2\) ; la moyenne pondérée de ces carrés vaut \(4\operatorname{V}(D)=36\). Pour le seuil \(12>0\), Tchebychev donne \[\mathbb{P}(|T|\geq12)=\mathbb{P}(|T-0|\geq12) \leq\frac{36}{12^2}=\frac{36}{144}=\frac14.\] Un programme possible, pour un entier \(n\geq0\), est :
from random import random

def position_finale(n):
    position = 0
    for k in range(n):
        if random() < 0.5:
            position = position + 1
        else:
            position = position - 1
    return position
La position initiale est fixée une seule fois à \(0\). Chaque passage dans la boucle produit un nouvel aléa et modifie la position courante. Le retour est placé après la boucle : sinon, le programme s’arrêterait après un seul pas.
Pour les pas imposés \(-1,+1,+1,-1,+1\), les positions sont successivement \[0\longrightarrow-1\longrightarrow0\longrightarrow1\longrightarrow0\longrightarrow1.\] Cette trace vérifie les mises à jour ; elle ne prédit pas le résultat d’une exécution aléatoire.
Critères. Il faut compter séparément pas droits et gauches, utiliser le carré du coefficient \(2\) pour la variance, et placer tirage et retour au bon endroit. Si la variance obtenue est \(18\), vérifie la règle \(\operatorname{V}(2D)=4\operatorname{V}(D)\), pas \(2\operatorname{V}(D)\).
Lire ses erreurs et choisir une reprise
Synthèse 12.26 — Des observations concrètes plutôt qu’une impression générale
Pour chaque réponse, note ce que tu sais effectivement faire : définir la variable, reconnaître les conditions, traduire l’événement, justifier la méthode, calculer, contrôler puis interpréter. Une erreur de modèle n’est pas réparée seulement en corrigeant une multiplication.
Si les questions \(1\) ou \(8\) résistent : teste les valeurs de bord, puis écris les valeurs entières possibles avant toute formule.
Si les questions \(2\) ou \(3\) résistent : reconstruis la somme de carrés ou l’inclusion d’événements ; rappelle-toi quel sens porte l’inégalité.
Si les questions \(4\) ou \(5\) résistent : sépare la variable individuelle, la somme et la moyenne ; montre le carré du coefficient puis traite l’inégalité sur un entier.
Si la question \(6\) résiste : nomme ce qui tend vers \(0\), garde le seuil fixé et distingue l’avenir probabiliste d’une trajectoire observée.
Si la question \(7\) résiste : remplace chaque opération par oui/non avant de compter ; les étapes réussies ne sont pas les opérations validées.
Si les questions \(9\) ou \(10\) résistent : écris les états successifs des variables du programme ; distingue une moyenne théorique d’une moyenne calculée sur des résultats.
Pour vérifier une réparation, cache ensuite la correction et refais le raisonnement complet. La familiarité avec la solution ne remplace pas cette tentative.
À toi 12.27 — Une reprise différée en deux décisions
À refaire demain ou quelques jours plus tard, avant de relire les formules.
Situation A. Des mesures indépendantes de même loi ont pour espérance \(6\) et pour variance \(4\). Quelle taille suffit, par la borne du cours, pour que le risque d’un écart de leur moyenne d’au moins \(0{,}5\) soit au plus \(0{,}05\) ? Et s’il doit être strictement inférieur à \(0{,}05\) ?
Situation B. Un événement de probabilité inconnue \(p\) est observé sur \(2\,000\) essais indépendants de même probabilité. Donne une garantie pour le risque que sa fréquence s’écarte de \(p\) d’au moins \(0{,}05\). Une fréquence observée égale à \(0{,}43\) permet-elle de remplacer \(p\) par \(0{,}43\) dans le modèle et de déclarer la probabilité connue ?
Aides après une tentative. En A, le dénominateur contient \(0{,}5^2\) et l’inconnue \(n\) est entière. En B, la variance individuelle est \(p(1-p)\), que l’on peut majorer sans connaître \(p\).
Correction expliquée 12.28 — Des garanties suffisantes, pas des probabilités inventées
A. Sous les hypothèses données et pour \(n\geq1\), \[\mathbb{P}(|M_n-6|\geq0{,}5)\leq\frac4{n\times0{,}25}=\frac{16}{n}.\] Pour garantir \(16/n\leq0{,}05=1/20\), on multiplie par \(20n>0\) : \(320\leq n\). Le premier entier est \(320\). Pour une borne strictement inférieure à \(1/20\), il faut \(320<n\), donc le premier entier est \(321\). Ces effectifs concernent la garantie obtenue par la borne.
B. On code la réalisation de l’événement par une Bernoulli. Avec \(p(1-p)\leq1/4\) et \(\delta=0{,}05=1/20\), \[\mathbb{P}(|F_{2000}-p|\geq0{,}05) \leq\frac1{4\times2000\times(1/20)^2} =\frac1{4\times2000/400}=\frac1{20}=0{,}05.\] La valeur observée \(0{,}43\) est une estimation de \(p\), pas sa valeur exacte. La garantie a été obtenue pour tous les \(p\in[0;1]\) ; elle ne nécessite pas de substituer cette estimation au paramètre inconnu.
Critères. Les carrés, les signes stricts/larges, les hypothèses et la distinction paramètre/observation doivent rester corrects sans aide. Si un seul de ces points manque, reprends le geste correspondant avant de refaire la situation entière.
Synthèse 12.29 — La phrase à garder en tête
Des observations indépendantes de même loi permettent de réduire la dispersion d’une moyenne. Une inégalité transforme cette dispersion en garantie sur un risque ; la loi des grands nombres décrit ce risque lorsque la taille augmente. Pour appliquer ces idées correctement, il faut d’abord savoir ce que l’on moyenne, quel événement on mesure et quelles hypothèses le modèle autorise.
Si le lecteur ne s’affiche pas, ouvrir le PDF dans un nouvel onglet ou télécharger le PDF.