Cours
Sommes de variables aléatoires — Cours en classe — Terminale spécialité
Cours
Sommes de variables aléatoires — Cours en classe — Terminale spécialité
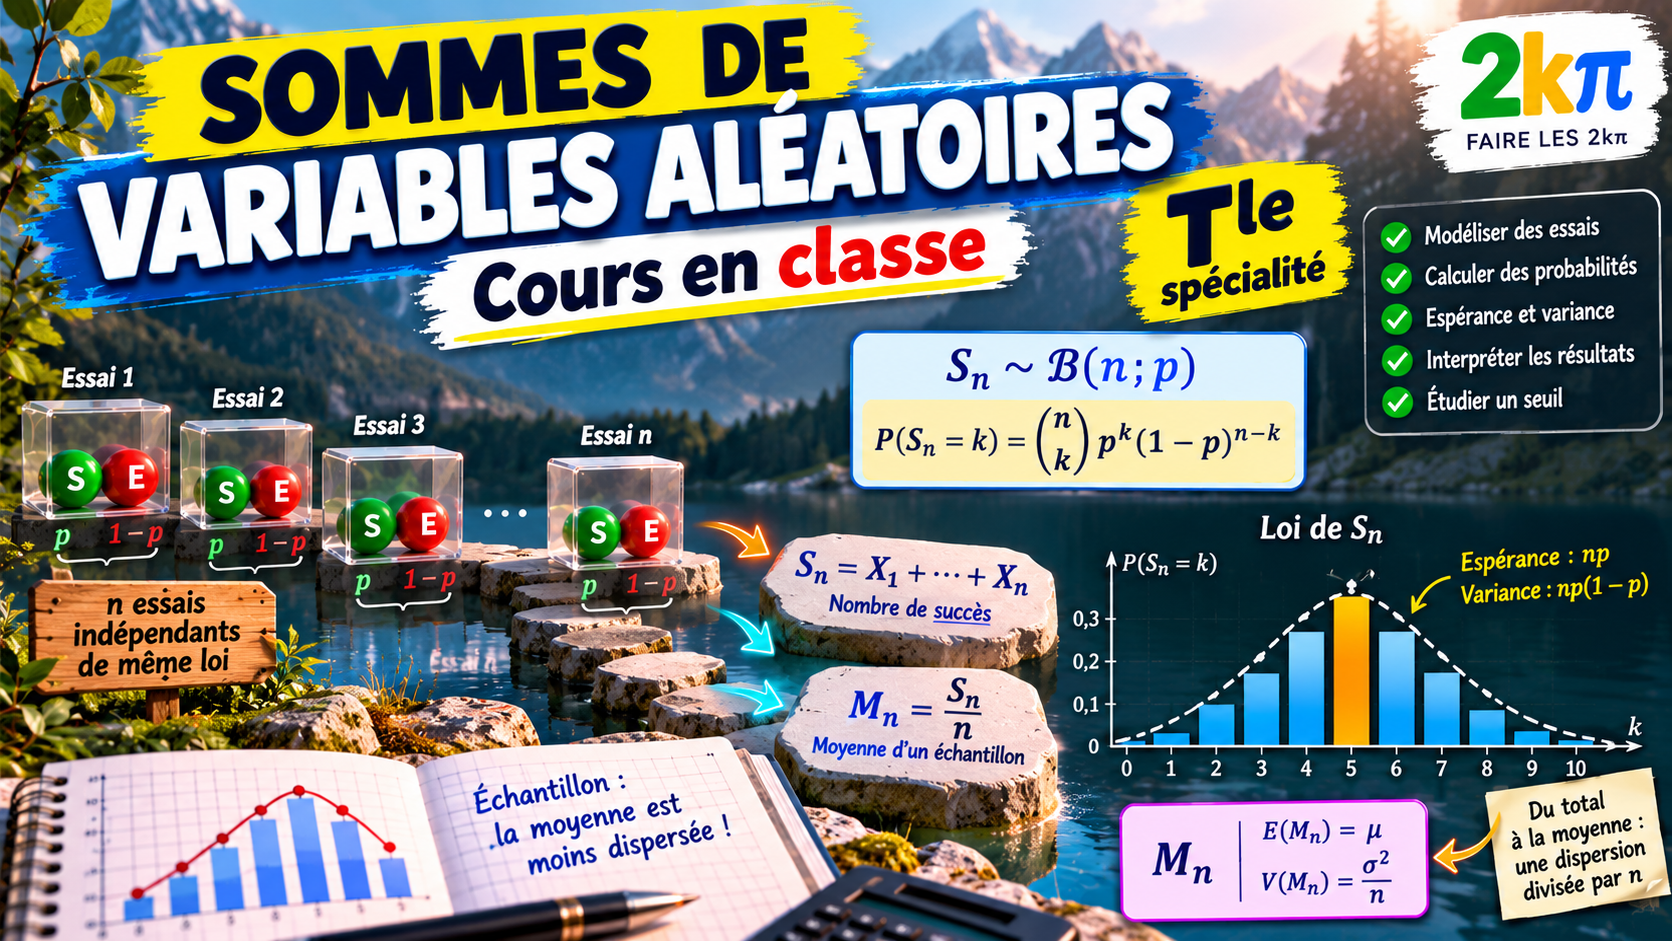
Terminale spécialité · Cours en classe
Sommes de variables aléatoires
Sommes de variables aléatoires
Terminale générale · Spécialité mathématiques
Cours en classe
La question du chapitre. Comment prévoir la moyenne et la dispersion d’un total sans forcément calculer toute sa loi ? Et que change le passage du total à la moyenne ?
Parcours.
1. Variables et sommes·
2. Espérance·
3. Transformation affine·
4. Variance et indépendance·
5. Loi binomiale·
6. Échantillons·
7. Simulation·
8. Synthèse.
Les définitions fixent le sens des mots ; les résultats sont accompagnés de leur démonstration ou de leur statut d’admission. Les variables étudiées ont un nombre fini de valeurs.
1. Variables, moments et sommes
Objectif. Décrire les nombres que l’on additionne et calculer la loi d’un total simple.
Définition 1.1 — Variable aléatoire et loi — rappel
Sur l’univers fini \(\Omega\) d’une expérience aléatoire, une variable aléatoire réelle \(X\) attribue un nombre \(X(\omega)\) à chaque issue \(\omega\). La loi de \(X\) donne ses valeurs distinctes \(x_1,\ldots,x_r\) et les probabilités \(p_i=\mathbb{P}(X=x_i)\) correspondantes, avec \[p_i\geq0\quad\text{et}\quad p_1+\cdots+p_r=1.\] \(X\) désigne la variable ; \(x_i\) une valeur ; \(\{X=x_i\}\) l’événement constitué des issues donnant cette valeur. Une même valeur peut provenir de plusieurs issues.
Définition 1.2 — Espérance, variance et écart type — rappel
Pour la loi précédente, en notant \(\mu=\operatorname{E}(X)\), \[\begin{aligned} \operatorname{E}(X)&=x_1p_1+\cdots+x_rp_r,\\ \operatorname{V}(X)&=(x_1-\mu)^2p_1+\cdots+(x_r-\mu)^2p_r,\\ \sigma(X)&=\sqrt{\operatorname{V}(X)}. \end{aligned}\] L’espérance est une moyenne pondérée par les probabilités. La variance est la moyenne des carrés des écarts à cette espérance : elle est positive ou nulle. L’écart type est sa racine carrée positive.
L’espérance et l’écart type ont la même unité que \(X\) ; la variance a l’unité au carré. L’espérance n’est pas nécessairement une valeur possible ni un résultat certain.
Exemple 1.3 — Un rappel calculé : les mesures d’un capteur
Quatre signaux équiprobables donnent les mesures \(-2\), \(0\), \(0\) et \(6\) mm. La valeur \(0\) regroupe deux signaux : la loi de \(X\) est donc \[\begin{array}{c|ccc} x&-2&0&6\\\hline \mathbb{P}(X=x)&1/4&1/2&1/4 \end{array}\] Les probabilités totalisent \(1\). On obtient \[\operatorname{E}(X)=(-2)\times\frac14+0\times\frac12+6\times\frac14=1\ \text{mm}.\] Les écarts à \(1\) sont \(-3\), \(-1\) et \(5\), d’où \[\operatorname{V}(X)=(-3)^2\frac14+(-1)^2\frac12+5^2\frac14 =\frac94+\frac24+\frac{25}4=9\ \text{mm}^2, \qquad \sigma(X)=3\ \text{mm}.\] La moyenne \(1\) n’est pas une mesure possible de ce capteur. Le nombre \(3\) décrit une dispersion : il ne garantit pas que tout écart à \(1\) soit inférieur à \(3\).
Définition 1.4 — Somme et opérations sur des variables
Si \(X\) et \(Y\) sont définies sur la même expérience, la variable \(S=X+Y\) associe à chaque issue la somme des deux valeurs obtenues : \[S(\omega)=X(\omega)+Y(\omega).\] De même, \(aX\), \(X-Y\) et \(aX+bY+c\), pour des réels fixes \(a,b,c\), sont calculées sur une même issue. Ces définitions ne demandent pas l’indépendance. Dans un modèle concret, on additionne des grandeurs d’unités compatibles.
Vocabulaire 1.5 — Des variables issues d’épreuves indépendantes
Dans les situations étudiées, l’indépendance appartient au modèle des épreuves : connaître le résultat d’une épreuve ne modifie pas les probabilités des résultats des autres. Les variables décrivant séparément ces épreuves sont alors dites indépendantes.
Pour deux variables indépendantes, la règle du produit donne \[\mathbb{P}\bigl((X=x)\cap(Y=y)\bigr)=\mathbb{P}(X=x)\mathbb{P}(Y=y).\] On utilise ici l’indépendance fournie par le modèle ; on ne cherche pas un critère abstrait permettant de la prouver pour des variables données a priori. Même loi et indépendance sont deux informations différentes. Des tirages sans remise dans une petite urne ne se traitent pas comme des répétitions indépendantes.
Méthode 1.6 — Construire la loi d’une somme
Définir les variables et l’expérience globale, puis lister les couples réalisables \((x,y)\) dans un tableau ou un arbre.
Calculer leurs probabilités. Sous indépendance, multiplier les probabilités individuelles. Sinon, utiliser par exemple la probabilité conditionnelle \(\mathbb{P}_A(B)\) de \(B\) sachant \(A\) : \(\mathbb{P}(A\cap B)=\mathbb{P}(A)\mathbb{P}_A(B)\), si \(\mathbb{P}(A)>0\).
Calculer \(x+y\) pour chaque couple, puis regrouper les couples donnant la même somme.
Additionner leurs probabilités et vérifier que la loi obtenue totalise \(1\).
Justification. Deux couples de valeurs distincts ne peuvent se réaliser simultanément : les événements correspondants sont disjoints. C’est pourquoi leurs probabilités s’ajoutent lorsqu’ils donnent le même total.
Exemple 1.7 — Deux signaux indépendants
Deux modules émettent indépendamment un signal \(0\) ou \(1\), chacun avec probabilité \(1/2\). On note \(X\) le premier signal, \(Y\) le second et \(S=X+Y\). Les quatre couples sont de probabilité \((1/2)(1/2)=1/4\).
Le total \(1\) peut provenir de \((0,1)\) ou de \((1,0)\), donc \(\mathbb{P}(S=1)=1/4+1/4=1/2\). Ainsi \[\begin{array}{c|ccc} s&0&1&2\\\hline \mathbb{P}(S=s)&1/4&1/2&1/4 \end{array}\] Le contrôle donne \(1/4+1/2+1/4=1\). Trois valeurs possibles ne signifient donc pas trois valeurs équiprobables.
Lecture. Les deux cases vertes donnent la somme \(1\). On additionne leurs probabilités, et non leurs valeurs.
2. Linéarité de l’espérance
Objectif. Calculer la moyenne d’un total sans déterminer toute sa loi.
Lemme 2.1 — Calculer l’espérance directement sur les issues
Soit un univers fini \(\Omega=\{\omega_1,\ldots,\omega_m\}\). Notons \(p_j\) la probabilité de l’issue \(\omega_j\) et \(x_j=X(\omega_j)\), sans supposer ces valeurs distinctes. Alors \[\operatorname{E}(X)=x_1p_1+\cdots+x_mp_m.\]
Démonstration. Si plusieurs issues donnent la même valeur \(x\), leurs contributions se regroupent en \(x(p_{j_1}+\cdots+p_{j_s})\). La somme de leurs probabilités est précisément \(\mathbb{P}(X=x)\). En regroupant toutes les valeurs égales, on retrouve la définition de l’espérance par la loi de \(X\).
Théorème 2.2 — Linéarité de l’espérance
Pour deux variables aléatoires finies \(X,Y\) définies sur la même expérience et tous réels constants \(a,b\), \[\boxed{\operatorname{E}(aX+bY)=a\operatorname{E}(X)+b\operatorname{E}(Y).}\] Aucune hypothèse d’indépendance n’est nécessaire.
Démonstration. Sur les issues \(\omega_1,\ldots,\omega_m\), notons \(x_j\) et \(y_j\) les valeurs de \(X\) et \(Y\), et \(p_j\) les probabilités des issues. Le lemme précédent permet d’utiliser les mêmes poids pour les trois variables. Par distributivité, \[\begin{aligned} \operatorname{E}(aX+bY) &=(ax_1+by_1)p_1+\cdots+(ax_m+by_m)p_m\\ &=a(x_1p_1+\cdots+x_mp_m) +b(y_1p_1+\cdots+y_mp_m)\\ &=a\operatorname{E}(X)+b\operatorname{E}(Y). \end{aligned}\] La preuve utilise seulement la pondération des issues et la distributivité, pas l’indépendance.
Corollaire 2.3 — Constante, transformation affine et somme finie
Pour une constante \(c\), \(\operatorname{E}(c)=c\). Pour tous réels constants \(a,b\), \[\boxed{\operatorname{E}(aX+b)=a\operatorname{E}(X)+b.}\] Pour \(n\geq1\) variables définies sur la même expérience, \[\boxed{\operatorname{E}(X_1+\cdots+X_n)=\operatorname{E}(X_1)+\cdots+\operatorname{E}(X_n).}\]
Démonstration. Une constante \(c\) a pour espérance \(c\times1=c\). Le théorème appliqué à \(aX+b\) donne la deuxième formule. Enfin, on applique successivement la linéarité à deux termes : le passage de \(n\) à \(n+1\) sépare \((X_1+\cdots+X_n)+X_{n+1}\). Avec le cas \(n=1\), cela justifie la formule pour tout entier \(n\geq1\).
Exemple 2.4 — Deux gains liés : l’espérance s’additionne quand même
Une seule expérience possède trois issues. Les gains \(X\) et \(Y\) y sont définis par le tableau suivant.
| Issue | \(\omega_1\) | \(\omega_2\) | \(\omega_3\) |
|---|---|---|---|
| Probabilité | \(1/4\) | \(1/2\) | \(1/4\) |
| \(X\) | 2 | 2 | 6 |
| \(Y\) | 4 | 0 | 0 |
| \(S=X+Y\) | 6 | 2 | 6 |
On calcule \(\operatorname{E}(X)=2(1/4)+2(1/2)+6(1/4)=3\) et \(\operatorname{E}(Y)=4(1/4)=1\). Donc \[\operatorname{E}(S)=\operatorname{E}(X)+\operatorname{E}(Y)=3+1=4.\] Ces gains sont liés : obtenir \(X=6\) impose \(Y=0\). Cela n’empêche pas d’utiliser la linéarité. Contrôle direct. \(S=6\) a pour probabilité \(1/4+1/4=1/2\) et \(S=2\) a pour probabilité \(1/2\), d’où \(\operatorname{E}(S)=6(1/2)+2(1/2)=4\).
Méthode 2.5 — Exploiter une décomposition
Quand la question porte sur un gain, une durée ou un total, écrire d’abord la variable cherchée à l’aide de variables simples. Par exemple, pour \(G=4X-3Y+2\), \[\operatorname{E}(G)=4\operatorname{E}(X)-3\operatorname{E}(Y)+2.\] On écrit la formule littérale avant de remplacer les espérances par leurs valeurs. Les coefficients doivent être des constantes. Un calcul direct sur une petite loi peut servir de contrôle ; il n’est pas nécessaire de reconstruire cette loi dans tous les problèmes.
3. Transformer une variable : \(aX+b\)
Objectif. Distinguer l’effet d’un décalage et celui d’un changement d’échelle.
Définition 3.1 — Transformation affine
Si \(a,b\) sont deux réels fixes, la variable \(Y=aX+b\) remplace chaque valeur \(x\) de \(X\) par \(ax+b\). Le coefficient \(a\) peut être négatif ou nul ; pour \(a=0\), \(Y=b\) est constante. La linéarité donne \(\operatorname{E}(Y)=a\operatorname{E}(X)+b\).
Propriété 3.2 — Variance d’une transformation affine
Pour une variable aléatoire finie \(X\) et tous réels constants \(a,b\), \[\boxed{\operatorname{V}(aX+b)=a^2\operatorname{V}(X).}\]
Démonstration. Posons \(\mu=\operatorname{E}(X)\). La moyenne de \(Y=aX+b\) vaut \(a\mu+b\). Sur une issue où \(X=x\), l’écart de \(Y\) à sa moyenne vaut \[(ax+b)-(a\mu+b)=ax+b-a\mu-b=a(x-\mu).\] Son carré est donc \(a^2(x-\mu)^2\). En prenant la moyenne pondérée de ces carrés sur les mêmes issues, le facteur constant \(a^2\) sort : on obtient \(\operatorname{V}(Y)=a^2\operatorname{V}(X)\).
La constante \(b\) disparaît des écarts. Aucun calcul n’a divisé par \(a\) : la preuve inclut \(a=0\). Une translation (\(a=1\)) ou un changement de signe (\(a=-1\)) ne modifie pas la variance.
Corollaire 3.3 — Écart type d’une transformation affine
Sous les mêmes conditions, \[\boxed{\sigma(aX+b)=|a|\sigma(X).}\]
Démonstration. La variance est positive ou nulle, donc \[\sigma(aX+b)=\sqrt{a^2\operatorname{V}(X)} =\sqrt{a^2}\sqrt{\operatorname{V}(X)}=|a|\sigma(X).\] En effet, \(\sqrt{a^2}=a\) si \(a\geq0\) et \(\sqrt{a^2}=-a\) si \(a<0\) : dans les deux cas, c’est \(|a|\). Un écart type n’est jamais négatif. Pour \(a=0\), ou si \(\operatorname{V}(X)=0\), la nouvelle variance et le nouvel écart type sont nuls.
Exemple 3.4 — Un coefficient négatif
\(X\) prend les valeurs \(0,2,4\) avec probabilités \(1/4,1/2,1/4\). Alors \[\operatorname{E}(X)=0\times\frac14+2\times\frac12+4\times\frac14=2, \quad \operatorname{V}(X)=(-2)^2\frac14+0^2\frac12+2^2\frac14=2.\] On pose \(Y=6-2X=(-2)X+6\). Le coefficient est \(a=-2\) et la constante \(b=6\), d’où \[\operatorname{E}(Y)=-2\times2+6=2,\qquad \operatorname{V}(Y)=(-2)^2\times2=8,\qquad \sigma(Y)=|-2|\sqrt2=2\sqrt2.\] Contrôle. Les valeurs de \(Y\) sont \(6,2,-2\), avec les mêmes probabilités. Leurs écarts à \(2\) sont \(4,0,-4\) : \(\operatorname{V}(Y)=16/4+0+16/4=8\).
Lecture. Le coefficient \(-2\) inverse l’ordre des valeurs et double leurs distances au centre. Les probabilités sont conservées ; la variance est multipliée par quatre.
Méthode 3.5 — Ne pas mélanger les trois règles
Mettre la variable sous la forme \(aX+b\) et identifier \(a\) avec son signe.
Choisir : \(a\operatorname{E}(X)+b\) pour l’espérance, \(a^2\operatorname{V}(X)\) pour la variance, \(|a|\sigma(X)\) pour l’écart type.
Remplacer les données, puis contrôler la non-négativité de la dispersion et les unités. Pour une petite loi, vérifier directement sur les valeurs transformées.
Aucune indépendance n’est nécessaire pour transformer une seule variable. La règle ne s’applique pas telle quelle si le coefficient est lui-même aléatoire, ni à une transformation non affine comme \(X^2\).
4. Additionner des variances sous indépendance
Objectif. Identifier l’hypothèse qui autorise le calcul de la dispersion d’un total.
Théorème 4.1 — Additivité de la variance — résultat admis
Si \(X\) et \(Y\) sont issues de deux épreuves indépendantes, alors \[\boxed{\operatorname{V}(X+Y)=\operatorname{V}(X)+\operatorname{V}(Y).}\] Plus généralement, pour \(n\) variables décrivant séparément \(n\) épreuves indépendantes, \[\operatorname{V}(X_1+\cdots+X_n)=\operatorname{V}(X_1)+\cdots+\operatorname{V}(X_n).\] Les variables n’ont pas besoin d’avoir la même loi. Ce résultat est admis dans ce cours, conformément au programme. L’hypothèse d’indépendance ne peut pas être supprimée de cette règle ; en revanche, l’égalité des variances ne constitue pas un critère réciproque d’indépendance.
Corollaire 4.2 — Combinaison pondérée et différence
Si \(X,Y\) sont indépendantes et \(a,b,c\) sont des réels constants, \[\boxed{\operatorname{V}(aX+bY+c)=a^2\operatorname{V}(X)+b^2\operatorname{V}(Y).}\]
Démonstration. Transformer séparément les deux épreuves ne les relie pas : \(aX\) dépend seulement de la première et \(bY\) seulement de la seconde. La constante ne change pas la variance. Le théorème puis la propriété affine donnent \[\operatorname{V}(aX+bY+c)=\operatorname{V}(aX)+\operatorname{V}(bY) =a^2\operatorname{V}(X)+b^2\operatorname{V}(Y).\] En particulier, puisque \((-1)^2=1\), \[\boxed{\operatorname{V}(X-Y)=\operatorname{V}(X)+\operatorname{V}(Y).}\] Un signe moins entre les variables ne conduit donc pas à soustraire leurs variances. Les écarts types ne s’additionnent pas non plus : \(\sigma(X+Y)=\sqrt{\sigma(X)^2+\sigma(Y)^2}\) sous indépendance.
Exemple 4.3 — Coefficients, signe moins et constante
On suppose \(X,Y\) indépendantes, avec \(\operatorname{E}(X)=5\), \(\operatorname{E}(Y)=3\), \(\operatorname{V}(X)=4\) et \(\operatorname{V}(Y)=9\). Pour \(D=2X-Y+7\), \[\operatorname{E}(D)=2\times5-3+7=14.\] Les coefficients des variables sont \(2\) et \(-1\). Grâce à l’indépendance, \[\operatorname{V}(D)=2^2\times4+(-1)^2\times9=16+9=25, \qquad \sigma(D)=\sqrt{25}=5.\] Le nombre \(7\) modifie l’espérance, pas la variance. Sans l’indépendance, l’espérance \(14\) resterait justifiée ; la variance \(25\) ne serait pas déductible des seules données ci-dessus.
Contre-exemple 4.4 — Doubler une mesure ou en additionner deux
Reprenons les signaux \(0/1\) équiprobables : \(\operatorname{E}(X)=1/2\) et \(\operatorname{V}(X)=(-1/2)^2/2+(1/2)^2/2=1/4\).
Une seule réalisation doublée : \(2X\) vaut \(0\) ou \(2\), chacune avec probabilité \(1/2\), et \(\operatorname{V}(2X)=4\times(1/4)=1\).
Deux réalisations indépendantes : si \(Y\) suit la même loi et provient d’une seconde épreuve indépendante, \(X+Y\) vaut \(0,1,2\) avec probabilités \(1/4,1/2,1/4\) et \(\operatorname{V}(X+Y)=1/4+1/4=1/2\).
Les espérances sont toutes deux égales à \(1\), mais les lois et variances diffèrent. Ainsi, on ne peut pas appliquer l’additivité à \(X+X\) comme s’il s’agissait de deux répétitions indépendantes.
Lecture. Les deux lois ont la même espérance \(1\). La somme indépendante peut valoir \(1\), contrairement à \(2X\) ; sa variance est ici plus petite.
Méthode 4.5 — Choisir une formule de variance
Premier geste : écrire la variable cherchée, puis isoler ses coefficients et ses constantes. Pour une seule variable transformée, utiliser la règle affine. Pour additionner des variances, repérer l’indépendance dans le modèle des épreuves.
Écrire la formule avec les coefficients au carré, substituer, puis prendre la racine seulement si l’on cherche l’écart type. Contrôler le signe et l’unité. Si l’indépendance n’est pas fournie, ne pas l’inventer : un tableau ou un arbre complet peut permettre un calcul direct ; à défaut d’information suffisante, la variance du total reste indéterminée.
5. Compter des succès : application à la loi binomiale
Objectif. Construire une somme de variables simples, puis démontrer les moments du compteur.
Définition 5.1 — Indicatrice et loi de Bernoulli
Soit un événement \(A\) de probabilité \(p\in[0;1]\). Son indicatrice est la variable \(I\) qui vaut \(1\) si \(A\) se réalise et \(0\) sinon. Sa loi est la loi de Bernoulli de paramètre \(p\) : \[\begin{array}{c|cc}i&0&1\\\hline\mathbb{P}(I=i)&1-p&p\end{array}\] Le « succès » est simplement l’événement que l’on compte : il peut désigner un défaut ou un échec dans le langage courant.
Proposition 5.2 — Moments d’une variable de Bernoulli
Pour une variable \(I\) de Bernoulli de paramètre \(p\), \[\boxed{\operatorname{E}(I)=p,\qquad \operatorname{V}(I)=p(1-p),\qquad \sigma(I)=\sqrt{p(1-p)}.}\]
Démonstration. La définition de l’espérance donne \(\operatorname{E}(I)=0(1-p)+1p=p\). Les écarts à \(p\) sont \(-p\) et \(1-p\), donc \[\begin{aligned} \operatorname{V}(I)&=(-p)^2(1-p)+(1-p)^2p\\ &=p(1-p)\times p+p(1-p)\times(1-p)\\ &=p(1-p)\bigl[p+(1-p)\bigr]=p(1-p). \end{aligned}\] La racine donne l’écart type. On n’a divisé ni par \(p\) ni par \(1-p\) : la preuve reste valable pour \(p=0\) et \(p=1\).
Lemme 5.3 — Un compteur est une somme de variables 0/1
Pour \(n\geq1\) événements \(A_1,\ldots,A_n\), notons \(I_i\) l’indicatrice de \(A_i\). Le nombre \(N\) d’événements réalisés vérifie \[\boxed{N=I_1+\cdots+I_n.}\]
Démonstration. Sur chaque issue, un événement réalisé apporte exactement \(1\) à la somme et un événement non réalisé apporte \(0\). Cette somme est donc exactement le nombre recherché sur toute issue. Aucune indépendance n’est nécessaire.
Par linéarité, on en déduit \(\operatorname{E}(N)=\mathbb{P}(A_1)+\cdots+\mathbb{P}(A_n)\), même si ces probabilités sont différentes ou si les événements sont liés. Cela ne suffit pas à conclure que \(N\) est binomiale.
Lecture. Dans cette réalisation de six épreuves, les indicatrices valent \(1,0,1,0,0,1\). Leur somme est \(3\), le nombre de succès.
Définition 5.4 — Schéma de Bernoulli et loi binomiale — rappel
Un schéma de Bernoulli comporte un nombre fixé \(n\geq1\) d’épreuves, décrites chacune par succès/échec, indépendantes, et ayant toutes la même probabilité de succès \(p\in[0;1]\). Le nombre \(X\) de succès suit la loi binomiale de paramètres \(n,p\), notée \(\mathcal{B}(n;p)\).
En notant \(I_i\) l’indicatrice du succès à l’épreuve \(i\), on a \(X=I_1+\cdots+I_n\). Les \(I_i\) sont indépendantes et de même loi de Bernoulli ; elles ne prennent pas nécessairement la même valeur dans une réalisation.
Théorème 5.5 — Espérance, variance et écart type de la loi binomiale
Si \(X\) suit \(\mathcal{B}(n;p)\), avec \(n\geq1\) entier et \(0\leq p\leq1\), alors \[\boxed{\operatorname{E}(X)=np,\qquad \operatorname{V}(X)=np(1-p),\qquad \sigma(X)=\sqrt{np(1-p)}.}\]
Démonstration. On réalise cette loi par un schéma de Bernoulli et on écrit \(X=I_1+\cdots+I_n\), où chaque \(I_i\) a pour espérance \(p\) et pour variance \(p(1-p)\).
Pour l’espérance, la linéarité suffit : \[\operatorname{E}(X)=\operatorname{E}(I_1)+\cdots+\operatorname{E}(I_n) =\underbrace{p+\cdots+p}_{n\text{ termes}}=np.\] Pour la variance, l’indépendance est utilisée : les indicatrices décrivent séparément les épreuves indépendantes. L’additivité admise donne \[\operatorname{V}(X)=\operatorname{V}(I_1)+\cdots+\operatorname{V}(I_n) =\underbrace{p(1-p)+\cdots+p(1-p)}_{n\text{ termes}}=np(1-p).\] La racine carrée de la variance donne l’écart type. Si l’on connaît seulement la loi de \(X\), ses moments sont les mêmes que ceux de ce compteur, puisqu’ils ne dépendent que de la loi.
Cas limites. Pour \(p=0\), \(X=0\) avec probabilité \(1\) ; pour \(p=1\), \(X=n\) avec probabilité \(1\). La variance est nulle dans les deux cas, comme l’indique la formule.
Le nombre \(np\) est une moyenne théorique : il peut ne pas être entier et n’annonce pas le nombre de succès d’une série particulière.
Méthode 5.6 — Du texte au compteur, puis à la quantité demandée
Définir le succès et la variable qui compte les succès. Au besoin, construire les indicatrices et leur somme.
Vérifier les quatre points du modèle : nombre d’épreuves fixé, deux catégories, indépendance, même probabilité \(p\).
Identifier \(n,p\) ; calculer les moments du compteur. Si la question porte sur un score ou un coût, écrire ensuite cette variable en fonction du compteur.
Contrôler : espérance du compteur entre \(0\) et \(n\), variance positive ou nulle, racine et unité appropriées.
Exemple 5.7 — Construire un score à partir des réussites
On effectue \(12\) essais indépendants, chacun de probabilité de réussite \(1/4\). Chaque réussite rapporte \(4\) points et on retranche un coût fixe de \(6\) points à la fin.
Décomposer. Notons \(I_i\) l’indicatrice de la réussite à l’essai \(i\) et \(X=I_1+\cdots+I_{12}\) le nombre de réussites. Les quatre conditions du schéma de Bernoulli sont vérifiées : \(X\) suit \(\mathcal{B}(12;1/4)\). Le score est \(G=4X-6\). \[\operatorname{E}(X)=12\times\frac14=3,\qquad \operatorname{V}(X)=12\times\frac14\times\frac34=\frac94.\] Transformer les moments. Pour le score, \[\operatorname{E}(G)=4\times3-6=6\ \text{points}, \qquad \operatorname{V}(G)=4^2\times\frac94=36\ \text{points}^2,\] donc \(\sigma(G)=6\) points. Le coût fixe affecte la moyenne, pas la dispersion. Le score peut être négatif ; sa variance, elle, reste positive ou nulle.
6. Somme et moyenne d’un échantillon
Objectif. Distinguer un total d’une moyenne et mesurer l’effet de la taille de l’échantillon.
Définition 6.1 — Échantillon de taille \(n\)
Pour un entier \(n\geq1\), un échantillon de taille \(n\) de la loi de \(X\) est une liste de variables aléatoires \((X_1,\ldots,X_n)\) indépendantes et de même loi que \(X\). Après les expériences, on observe des nombres \((x_1,\ldots,x_n)\) : c’est une réalisation de l’échantillon. « De même loi » signifie mêmes valeurs et mêmes probabilités, pas mêmes nombres obtenus.
Exemple 6.2 — Même loi, résultats différents
Une mesure \(X\) vaut \(2\) ou \(10\), chacune avec probabilité \(1/2\). Quatre mesures indépendantes peuvent donner \((2,10,2,2)\) : le total observé est \(16\) et la moyenne observée \(4\). Pourtant, \(\operatorname{E}(X)=2/2+10/2=6\). Une moyenne observée n’est pas obligatoirement égale à l’espérance. Deux observations indépendantes peuvent aussi être égales par hasard.
Définition 6.3 — Somme et moyenne aléatoires
Pour l’échantillon \((X_1,\ldots,X_n)\), on définit \[\boxed{S_n=X_1+\cdots+X_n,\qquad M_n=\frac{X_1+\cdots+X_n}{n}=\frac{S_n}{n}.}\] Ces variables sont aléatoires, puisqu’elles dépendent des observations futures. La condition \(n\geq1\) permet de définir la moyenne.
Théorème 6.4 — Moments de la somme et de la moyenne
Soit \((X_1,\ldots,X_n)\) un échantillon de la loi de \(X\), avec \(\mu=\operatorname{E}(X)\), \(v=\operatorname{V}(X)\) et \(\sigma=\sqrt v\). Alors
| Variable | Espérance | Variance | Écart type |
|---|---|---|---|
| \(S_n=X_1+\cdots+X_n\) | \(n\mu\) | \(nv\) | \(\sqrt n\,\sigma\) |
| \(M_n=S_n/n\) | \(\mu\) | \(v/n\) | \(\sigma/\sqrt n\) |
Démonstration. 1. Pour le total. Les variables ont toutes la même espérance \(\mu\). Par linéarité, \[\operatorname{E}(S_n)=\operatorname{E}(X_1)+\cdots+\operatorname{E}(X_n) =\underbrace{\mu+\cdots+\mu}_{n\text{ termes}}=n\mu.\] Elles ont toutes la variance \(v\) et sont indépendantes, donc \[\operatorname{V}(S_n)=\operatorname{V}(X_1)+\cdots+\operatorname{V}(X_n)=nv, \qquad \sigma(S_n)=\sqrt{nv}=\sqrt n\,\sigma.\] La même loi rend les moments identiques ; l’indépendance permet l’addition des variances, mais n’est pas nécessaire à l’addition des espérances.
2. Pour la moyenne. Puisque \(n\geq1\), le coefficient \(1/n\) est défini et \(M_n=(1/n)S_n\). Ainsi \[\operatorname{E}(M_n)=\frac1n\operatorname{E}(S_n)=\frac{n\mu}{n}=\mu,\] \[\operatorname{V}(M_n)=\left(\frac1n\right)^2\operatorname{V}(S_n) =\frac{nv}{n^2}=\frac{nv}{n\times n}=\frac vn.\] Le facteur est \(1/n^2\) pour la variance : on simplifie un seul facteur \(n\). Enfin, \[\sigma(M_n)=\sqrt{\frac vn}=\frac{\sqrt v}{\sqrt n}=\frac\sigma{\sqrt n}.\] Pour \(n=1\), on retrouve les moments d’une seule observation. Pour \(v=0\), toutes les variances et tous les écarts types ci-dessus sont nuls.
Exemple 6.5 — Masse totale et masse moyenne d’un lot
La masse \(X\) d’un composant vaut \(198\), \(200\) ou \(202\) g avec probabilités \(1/4\), \(1/2\), \(1/4\). Un lot réunit \(50\) composants dont les masses sont supposées indépendantes et de cette même loi.
Une seule masse. \[\operatorname{E}(X)=\frac{198+400+202}{4}=200\ \text{g},\qquad \operatorname{V}(X)=\frac{(-2)^2}{4}+\frac{0^2}{2}+\frac{2^2}{4}=2\ \text{g}^2.\] L’écart type individuel vaut \(\sqrt2\) g. Pour le total et pour la moyenne, \[\begin{aligned} \operatorname{E}(S_{50})&=50\times200=10\,000\ \text{g},& \operatorname{V}(S_{50})&=50\times2=100\ \text{g}^2,\\ \operatorname{E}(M_{50})&=200\ \text{g},& \operatorname{V}(M_{50})&=\frac2{50}=0{,}04\ \text{g}^2. \end{aligned}\] Ainsi \(\sigma(S_{50})=10\) g et \(\sigma(M_{50})=0{,}2\) g. Contrôle : \(M_{50}=S_{50}/50\), donc son écart type est \(10/50=0{,}2\) g, et non \(10/\sqrt{50}\).
Si l’emballage ajoute une masse fixe de \(300\) g, le total emballé \(S_{50}+300\) a pour espérance \(10\,300\) g et garde un écart type de \(10\) g.
Corollaire 6.6 — Effet de la taille sur l’écart type de la moyenne
À loi individuelle inchangée, multiplier la taille \(n\) par un entier \(k\geq1\) divise l’écart type de la moyenne par \(\sqrt k\) : \[\sigma(M_{kn})=\frac\sigma{\sqrt{kn}} =\frac1{\sqrt k}\frac\sigma{\sqrt n} =\frac{\sigma(M_n)}{\sqrt k}.\] C’est une conséquence directe du théorème. En particulier, multiplier la taille par \(4\) divise l’écart type par \(2\) ; le diviser par \(3\) demande de multiplier la taille par \(9\). L’espérance de la moyenne reste \(\mu\).
Lecture. Pour une loi d’espérance \(6\) et d’écart type \(4\), les tailles \(1,4,16,64\) donnent les écarts types \(4,2,1,0{,}5\). Les segments montrent seulement une échelle d’écart type ; ce ne sont pas des intervalles garantis.
Méthode 6.7 — Trouver une taille minimale : attention au signe strict
Pour un objectif \(\sigma(M_n)<\varepsilon\), avec \(\varepsilon>0\) et \(n\geq1\), écrire d’abord \(\sigma/\sqrt n<\varepsilon\), puis résoudre sur des quantités positives. Si \(\sigma>0\), \[\frac\sigma{\sqrt n}<\varepsilon \ \Longleftrightarrow\ \sigma<\varepsilon\sqrt n \ \Longleftrightarrow\ \frac\sigma\varepsilon<\sqrt n \ \Longleftrightarrow\ n>\left(\frac\sigma\varepsilon\right)^2.\] Les multiplications et divisions se font par des nombres strictement positifs ; le carré conserve l’ordre entre nombres positifs. Choisir ensuite le plus petit entier admissible et contrôler la frontière. Pour un objectif large \(\leq\), le signe final est \(\geq\). Si \(\sigma=0\), toute taille \(n\geq1\) convient déjà à l’objectif strict.
Exemple. Pour \(\sigma=3\) et \(\varepsilon=0{,}5\), \[\frac3{\sqrt n}<0{,}5 \ \Longleftrightarrow\ 3<0{,}5\sqrt n \ \Longleftrightarrow\ 6<\sqrt n \ \Longleftrightarrow\ 36<n.\] Le minimum est 37. Pour \(n=36\), l’écart type vaut \(3/6=0{,}5\), exclu par le signe strict. Pour \(n=37\), \(3/\sqrt{37}\approx0{,}493<0{,}5\). Avec « inférieur ou égal », le minimum aurait été \(36\).
Point de vigilance 6.8 — Une dispersion n’est pas une garantie sur chaque observation
L’inégalité \(\sigma(M_n)<0{,}5\) ne signifie pas que toutes les moyennes observées sont à moins de \(0{,}5\) de \(\mu\), ni que cette proximité a une probabilité de \(95\,\%\). Les formules comparent les lois des moyennes, pas une obligation pour chaque réalisation. Les théorèmes de concentration seront étudiés dans un autre chapitre.
7. Simuler une réalisation d’un échantillon
Objectif. Relier le modèle, les variables du programme et la sortie observée.
Algorithme 7.1 — Une observation, puis sa répétition indépendante
Une durée vaut \(1\), \(3\) ou \(7\) minutes avec probabilités \(1/4\), \(1/2\), \(1/4\). Pour simuler une observation, on partage \([0;1[\) en trois intervalles de ces longueurs : \[[0;0{,}25[\ \longrightarrow\ 1,\qquad [0{,}25;0{,}75[\ \longrightarrow\ 3,\qquad [0{,}75;1[\ \longrightarrow\ 7.\] On utilise de nouveaux appels au générateur pseudo-aléatoire pour simuler les répétitions indépendantes. L’entrée \(n\) est un entier au moins égal à \(1\).
from random import random

def observation():
    u = random()
    if u < 0.25:
        return 1
    if u < 0.75:
        return 3
    return 7

def echantillon(n):
    valeurs = []
    total = 0
    for i in range(n):
        x = observation()
        valeurs.append(x)
        total = total + x
    return [valeurs, total, total / n]
Le premier return termine la fonction : la deuxième condition est donc examinée seulement si \(u\geq0{,}25\). La boucle fait exactement \(n\) tours.
Justification. Au départ, le total vaut \(0\). À chaque tour, on ajoute la nouvelle valeur à la somme des précédentes ; après \(n\) tours, total est la somme des \(n\) observations. La division finale par \(n>0\) donne leur moyenne. L’appel à observation() doit rester dans la boucle : recopier une seule observation ne simulerait pas \(n\) répétitions indépendantes.
Exemple 7.2 — Lire les états d’une exécution
Pour \(n=4\), supposons que les nombres générés soient \(0{,}10\), \(0{,}80\), \(0{,}40\), \(0{,}60\). Ce sont des données choisies pour suivre le code, pas une sortie imposée au générateur.
| Tour | \(u\) | Observation \(x\) | Mise à jour du total |
|---|---|---|---|
| 1 | \(0{,}10\) | 1 | \(0+1=1\) |
| 2 | \(0{,}80\) | 7 | \(1+7=8\) |
| 3 | \(0{,}40\) | 3 | \(8+3=11\) |
| 4 | \(0{,}60\) | 3 | \(11+3=14\) |
La sortie est [[1, 7, 3, 3], 14, 3.5] : la liste, sa somme et sa moyenne. L’affectation lit l’ancien total à droite, puis le remplace à gauche.
La moyenne théorique de la loi vaut \(1/4+3/2+7/4=3{,}5\) minutes. Ici, la moyenne observée coïncide avec elle, mais la liste \([1,1,1,1]\) donnerait \(1\). Une simulation illustre le modèle ; elle ne démontre pas les formules du cours ni la perfection du générateur.
8. Synthèse : choisir et contrôler
Objectif. Retrouver rapidement la bonne formule avec ses conditions.
À retenir 8.1 — Les formules essentielles
Les variables sont finies et définies sur la même expérience ; \(a,b,c\) sont des constantes réelles.
| Conditions | Résultats |
|---|---|
| Sans indépendance | \(\operatorname{E}(aX+bY+c)=a\operatorname{E}(X)+b\operatorname{E}(Y)+c\) |
| Une variable transformée | \(\operatorname{V}(aX+c)=a^2\operatorname{V}(X)\) ; \(\sigma(aX+c)=|a|\sigma(X)\) |
| \(X,Y\) indépendantes | \(\operatorname{V}(aX+bY+c)=a^2\operatorname{V}(X)+b^2\operatorname{V}(Y)\) |
| \(X\) de loi \(\mathcal{B}(n;p)\) | \(\operatorname{E}(X)=np\) ; \(\operatorname{V}(X)=np(1-p)\) ; \(\sigma(X)=\sqrt{np(1-p)}\) |
Un échantillon \((X_1,\ldots,X_n)\) est constitué de variables indépendantes et de même loi, avec \(n\geq1\). Pour une loi d’espérance \(\mu\) et d’écart type \(\sigma\),
| Variable | Espérance | Variance | Écart type |
|---|---|---|---|
| \(S_n=X_1+\cdots+X_n\) | \(n\mu\) | \(n\sigma^2\) | \(\sqrt n\,\sigma\) |
| \(M_n=S_n/n\) | \(\mu\) | \(\sigma^2/n\) | \(\sigma/\sqrt n\) |
Méthode 8.2 — Le bon premier geste
| Question | Premier geste et contrôle |
|---|---|
| Loi d’un total | Énumérer les couples réalisables, calculer leurs probabilités et regrouper les sommes égales. Contrôler le total \(1\). |
| Espérance d’un total | Décomposer en variables simples puis appliquer la linéarité, sans exiger l’indépendance. |
| Variance d’un total | Identifier l’indépendance du modèle avant d’additionner les variances ; mettre les coefficients au carré. |
| Nombre de succès | Définir les variables \(0/1\) et leur somme ; vérifier les conditions binomiales avant d’utiliser \(np(1-p)\). |
| Moyenne d’observations | Écrire \(M_n=S_n/n\) ; dans la variance, le coefficient est \(1/n^2\) avant simplification. |
| Seuil de dispersion | Partir de \(\sigma/\sqrt n\), respecter le signe strict ou large et vérifier le plus petit entier. |
À ne pas confondre. Même loi / mêmes valeurs / indépendance ; \(nX\) / somme de répétitions indépendantes ; espérance / valeur certaine ; variance / écart type. Un dessin ou une simulation ne remplace pas une démonstration.
Preuves à retrouver. La linéarité : p. 3 ; la variance affine : p. 5 ; les moments binomiaux : p. 9 ; les moments d’un échantillon : p. 10. L’additivité des variances indépendantes est le résultat admis de la p. 6.
Si le lecteur ne s’affiche pas, ouvrir le PDF dans un nouvel onglet ou télécharger le PDF.
Pour apprendre dans le bon ordre